Guia de Prompts MiniMax H3: Como Escrever Prompts Mais Eficazes para Vídeo, Ref2VA, Câmera, Áudio e Referência
Um bom prompt para o MiniMax H3 deve definir muito mais do que o estilo visual. Ele precisa explicar o que acontece ao longo do tempo, como a câmera se movimenta, quais detalhes devem permanecer consistentes, o papel de cada referência e como o diálogo, o som e a música se encaixam na sequência. Para ter mais controle, o segredo é escolher o modo H3 correto, descrever mudanças observáveis e dar a cada referência um papel claro.
Este guia aborda T2VA, I2VA, FL2VA, L2VA, Ref2VA, controle de câmera, áudio, consistência de personagens e solução de problemas práticos. Esses princípios também se aplicam a fluxos de trabalho estruturados de vídeo com IA, como no Leadde, onde documentos, materiais de treinamento e informações de produtos são transformados em vídeos escaláveis com narração, avatares e saída multilíngue.
Guia de Prompts para o MiniMax H3: Qual é a Melhor Estrutura de Prompt?
A forma mais útil de encarar um prompt para o MiniMax H3 é como um roteiro de produção audiovisual. Em vez de acumular palavras como "cinematográfico", "realista" e "dramático", descreva o que o espectador realmente consegue ver e ouvir conforme o clipe se desenvolve para entender como criar vídeos realistas com IA.
A Fórmula Simples de Prompt para H3
Para criar prompts no dia a dia, comece com:
Sujeito + Ação + Ambiente + Câmera + Timing + Áudio
Por exemplo, "uma mulher em uma estação de trem chuvosa" estabelece a cena, mas não traz muitas informações temporais. Um prompt mais forte explica que ela caminha em direção à plataforma, para ao ouvir um trem se aproximando, vira-se na direção do som e é acompanhada por uma câmera lenta de rastreamento.
O Guia Oficial de Prompts Base do MiniMax formaliza essa ideia com três campos: integrated_multimodal_description, overall_soundscape e non_diegetic_music. O primeiro carrega a linha do tempo visual, ações, tomadas, locutores, diálogos e áudio sincronizado da cena; os outros dois separam o som ambiental e físico da música de fundo direcionada exclusivamente ao público.
Escreva Resultados Observáveis, Não Apenas Adjetivos
Uma regra útil é converter intenções abstratas em comportamentos visíveis.
Em vez de "ela parece confiante", descreva-a caminhando com firmeza, mantendo contato visual, ajeitando o paletó e parando sem hesitação.
A mesma abordagem ajuda com restrições. Em vez de repetir "não dê zoom", descreva o resultado desejado: "o assunto permanece aproximadamente com o mesmo tamanho no enquadramento do início ao fim." Um teste de consistência no H3 feito pela comunidade relatou que restrições de enquadramento mensuráveis funcionaram melhor naquele fluxo de trabalho específico do que repetir uma instrução negativa para a câmera. Esta é uma observação prática e anedótica do fluxo de trabalho, e não uma garantia oficial do MiniMax.
Qual Modo do MiniMax H3 Você Deve Usar?
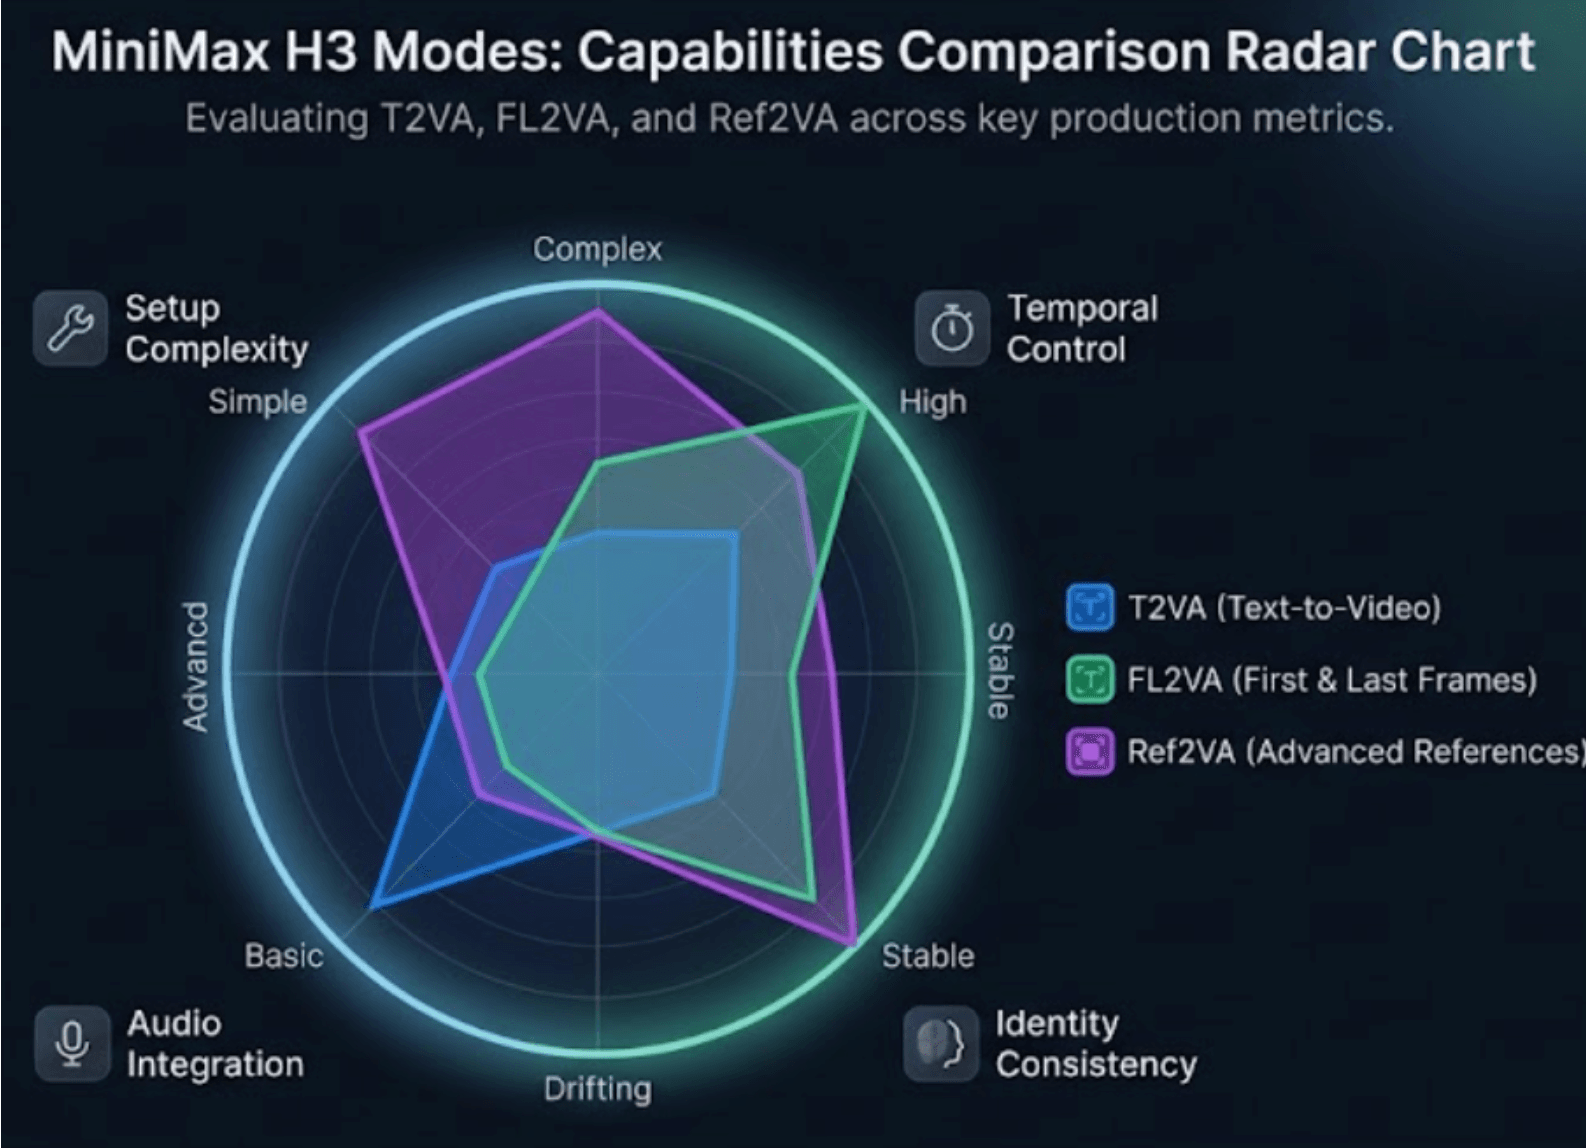
Escolher o modo correto pode ser tão importante quanto reescrever o prompt. O fluxo de trabalho Base do MiniMax suporta geração apenas por texto, além de tarefas de primeiro quadro, último quadro e primeiro e último quadro, enquanto seu checkpoint separado Ref2VA lida com a geração de referências multimodais.
| Modo | Entrada | Melhor Objetivo para o Prompt |
| T2VA | Texto | Construir a cena audiovisual completa |
| I2VA | Primeiro quadro | Preservar a abertura e desenvolver a partir dela |
| FL2VA | Primeiro + último quadro | Descrever a transição entre os pontos finais |
| L2VA | Último quadro | Construir a cena em direção ao final fornecido |
| Ref2VA | Imagens/vídeo/áudio | Combinar diferentes papéis de referência |
T2VA, I2VA, FL2VA e L2VA
O T2VA precisa estabelecer a cena do zero. O I2VA trata a imagem fornecida como o primeiro quadro real, portanto, o prompt deve preservar a identidade, roupas, objetos, cores e composição antes de introduzir o movimento.
Com o FL2VA, o prompt não deve apenas descrever a Imagem 1 e a Imagem 2. O MiniMax recomenda especificamente descrever o caminho observável entre elas: como o sujeito se move, como as poses mudam, como os objetos são manipulados e como a composição ou a iluminação convergem para o quadro final. O L2VA inverte o processo de raciocínio, partindo de um estado anterior plausível e aterrissando gradualmente no último quadro fornecido.
Quando Você Deve Usar o Ref2VA?
Use o Ref2VA quando diferentes ativos desempenham funções distintas — por exemplo, uma imagem define um personagem, outra define as roupas, um vídeo fornece o movimento de caminhada e o ritmo da câmera, e o áudio fornece a referência de voz.
Isso é mais bem compreendido como geração orientada por relacionamentos. O modelo precisa saber não apenas o que cada arquivo contém, mas como as informações de cada fonte devem influenciar o vídeo final. O formato de referência completa do MiniMax distingue explicitamente sujeitos reutilizáveis, âncoras concretas de imagens, fontes temporais em nível de vídeo e referências de áudio.
Use o Modo Mais Simples que Consiga Resolver a Tomada
Uma regra prática de produção é: não adicione complexidade de referência a menos que a tomada exija.
Se uma transição precisa apenas de uma abertura e término precisos, o FL2VA dá ao trabalho uma definição direta. Mude para o Ref2VA quando você realmente precisar de relações como identidade da Imagem 1 + movimento do Vídeo 1 + voz do Áudio 1.
Isso também facilita a depuração. Quando há menos restrições independentes concorrendo, fica mais fácil identificar se o problema vem do movimento, da identidade, do enquadramento ou do áudio.
Como Controlar Tomadas, Movimento de Câmera, Timing e Transições?
Os prompts do H3 tornam-se mais fáceis de controlar quando a linha do tempo é tratada como uma edição em vez de um parágrafo.
Cortes de Tomada, Marcações de Tempo e Orçamento Temporal
O formato oficial do MiniMax não usa marcações de tempo como [Shot 1]. As tomadas seguintes começam com tempos de corte crescentes, como [Shot 2] At 00:03.500. Uma nova tomada deve introduzir novas informações relevantes — como um ponto de vista, localização, estado, assunto ou momento diferente. Uma pequena mudança de distância ou ângulo geralmente é melhor expressa como movimento de câmera do que como outro corte.
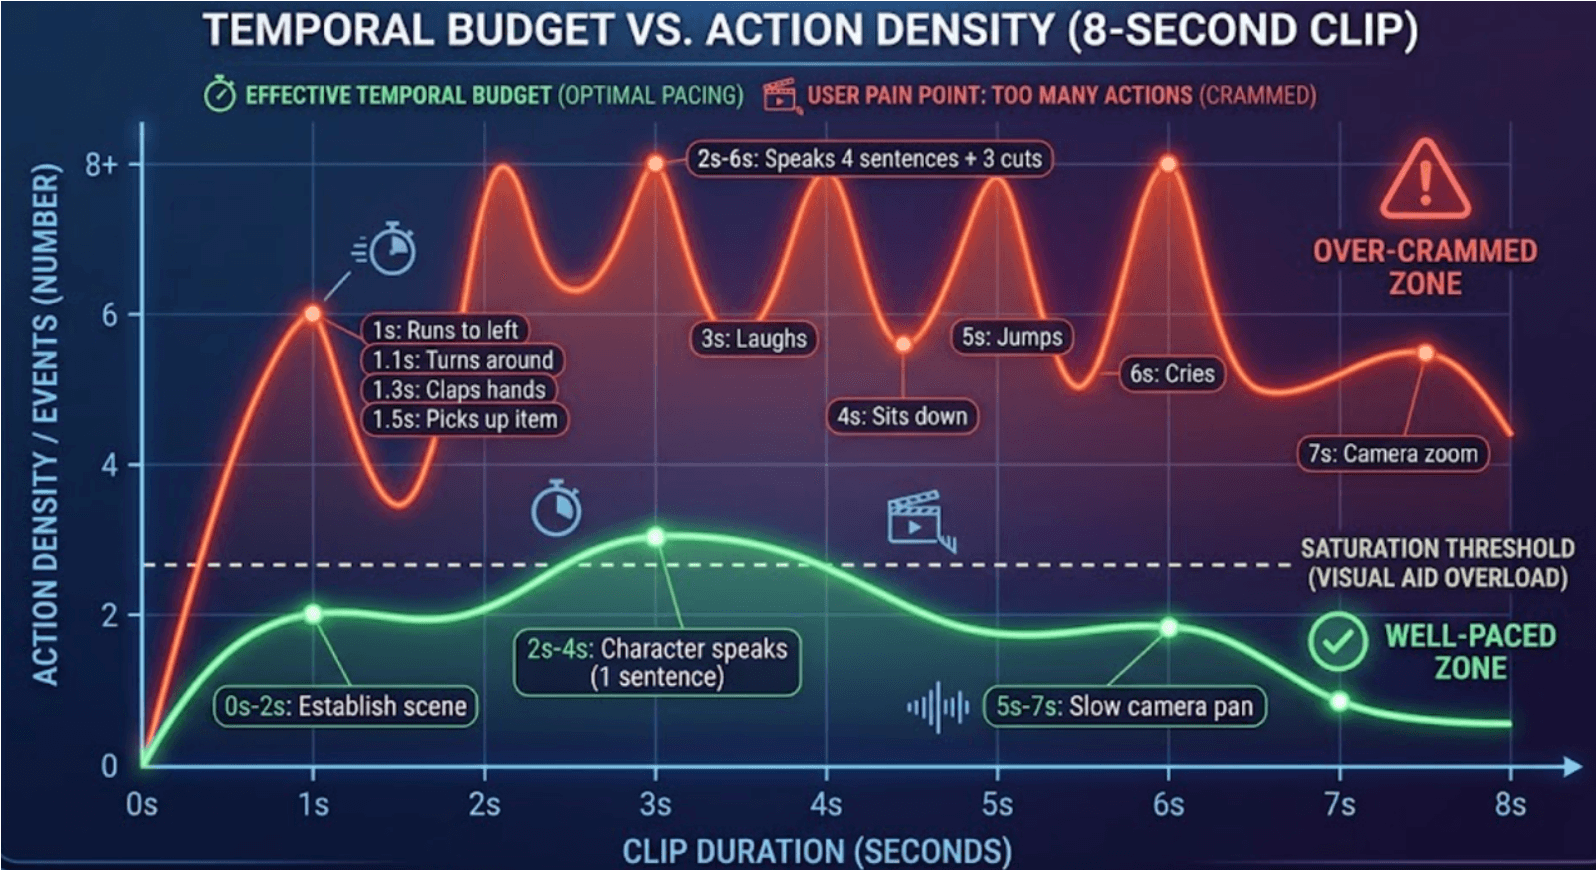
Isso cria um orçamento temporal prático. Em um clipe de 8 segundos, três ações, dois movimentos de câmera, uma reação, uma frase falada e dois cortes competem pela mesma duração limitada. Quando uma geração parece precipitada, remover eventos geralmente funciona melhor do que adicionar mais linguagem descritiva.
Linguagem de Câmera Compatível com o H3
O MiniMax documenta operações de câmera que incluem aproximação/afastamento (push/pull), panorâmica (pan), deslocamento lateral (truck), inclinação (tilt), pedestal, arco (arc), rastreamento (tracking), tomadas estáticas, ponto de vista (POV), rolagem (roll) e trepidação da câmera. A lógica recomendada é essencialmente:
Tipo de Movimento + Amplitude opcional + Velocidade opcional
Portanto, em vez de "câmera cinematográfica dinâmica", escreva algo acionável, como "a câmera se desloca lentamente para a direita, mantendo o produto centralizado."
Separe o Que Deve Permanecer Fixo do Que Pode Mudar
Antes de gerar, crie um mapa mental simples de itens fixos versus variáveis.
Um vídeo de produto pode exigir que o formato da garrafa, o texto do rótulo, a tampa e a cor permaneçam fixos, enquanto a posição da câmera, os reflexos, o movimento da água e a iluminação mudam. Uma sequência de personagens pode travar o rosto, o penteado e a roupa, permitindo que a pose e a expressão evoluam.
Isso reduz instruções contraditórias, pois o prompt deixa de exigir que todas as propriedades visuais mudem ao mesmo tempo.
Como Usar Referências Sem Perder a Consistência de Personagens ou Produtos?
Os fluxos de trabalho de referência mais fortes atribuem a cada ativo um propósito específico.
Dê a Cada Referência uma Única Função Clara
Um mapeamento prático pode ser:
Imagem 1 → identidade do personagem Imagem 2 → vestuário Imagem 3 → design do produto Vídeo 1 → movimento de caminhada e trajetória da câmera Áudio 1 → timbre de voz
O formato Ref2VA oficial do MiniMax suporta exatamente esse tipo de definição entre fontes: um sujeito pode obter a aparência de uma imagem e o movimento de um vídeo, enquanto um único arquivo de referência também pode fornecer vários sujeitos reutilizáveis.
O ponto importante é evitar a transferência acidental. Se o Vídeo 1 deve fornecer o movimento, mas não o ator ou o ambiente, declare isso explicitamente no design do relacionamento.
Sujeitos, Imagens, Storyboards e Vídeo de Referência
Na terminologia oficial, <Subject N> representa conteúdo visível reutilizável, enquanto <Picture N> é usado quando uma imagem serve como um quadro concreto, âncora de composição ou referência para roteiros e storyboards de vídeo. <Video N> representa relações de vídeo completo, como edição, continuação, movimento de câmera, cortes, ritmo ou estrutura temporal. <Audio N> lida com a cópia de áudio ou características como timbre de voz, entrega, ritmo ou estilo musical.
Essa distinção evita um erro conceitual comum: uma referência de personagem não é automaticamente um quadro-chave, e um criador de storyboards de vídeo com IA não gera automaticamente um ponto final exato.
Economia de Referência e Consistência por Tomada
Mais material de referência não significa automaticamente mais informação. Em fluxos de trabalho de produção, corte o vídeo de referência apenas na porção que demonstra claramente o movimento, a trajetória da câmera ou a qualidade vocal de que você precisa.
Avalie também a identidade ao longo de toda a tomada, e não apenas no primeiro quadro. Um teste da comunidade encontrou desvios de identidade consideravelmente mais precoces em close-ups do que em enquadramentos com rostos menores sob a configuração local específica daquele usuário. As marcações de tempo exatas não devem ser generalizadas, mas a lição para o fluxo de trabalho é útil: verifique a identidade do rosto, as roupas e pequenos adereços em vários pontos de cada tomada importante.
Como Funcionam o Ref2VA Avançado, Diálogos e Prompts de Áudio?
O Ref2VA é onde a criação de prompts no H3 se torna mais parecida com o planejamento de produção multimodal do que com a geração convencional de texto para vídeo.
A Estrutura de Prompt para Ref2VA em Seis Partes
O guia de referência completa do MiniMax define seis seções:
subject_definitions → summary → retention_analysis → detailed_description → overall_soundscape → non_diegetic_music.
O sistema primeiro define o significado das referências, depois resume a tarefa, explica como cada referência é preservada ou transferida e, por fim, escreve o vídeo de destino na ordem de reprodução.
Uma camada de planejamento útil antes de escrever o prompt formal é:
| Fonte | Preservar | Transferir | Ignorar |
| Imagem 1 | Rosto, cabelo | — | Fundo |
| Vídeo 1 | — | Caminhada, câmera | Identidade do ator |
| Áudio 1 | Timbre de voz | Entrega | Diálogo original |
Isso transforma um pedido vago como "use todas essas referências" em relações explícitas entre fonte e destino.
Diálogo, Voz, Efeitos Sonoros e Música
Personagens que falam usam IDs estáveis como (S1) e (S2), enquanto os diálogos são colocados dentro de <d>[Language] ...</d>. O MiniMax também distingue diálogos na tela de locuções fora da tela e recomenda manter explicitamente a boca de um personagem fechada na tela quando ele estiver apenas narrando.
Sons ambientais e efeitos físicos pertencem à paisagem sonora, enquanto non_diegetic_music é reservada para músicas ouvidas pelo público e não pelos personagens. Se você quiser passos, chuva e sons de objetos, mas nenhuma trilha sonora, mantenha a paisagem sonora e defina non_diegetic_music: N/A.
Prompt em Linguagem Natural vs. Prompt Estruturado Oficial
Instruções curtas em linguagem natural ainda podem funcionar no sistema hospedado H3 porque o MiniMax usa o H3-Context-IR, uma camada de pré-processamento que interpreta as relações entre texto, imagens, vídeo e áudio antes de produzir uma representação estruturada para o H3-Base. O cartão do modelo aberto descreve a análise de instruções, a associação intermodal, a compreensão temporal e o raciocínio lógico como parte desse processo.
Isso explica uma aparente contradição: prompts simples podem ser adequados para gerações diretas hospedadas, enquanto prompts estruturados tornam-se mais valiosos para tarefas precisas de múltiplas referências, diálogos, timing e produções repetíveis.
Por Que o MiniMax H3 Ignora os Prompts e Qual é o Melhor Fluxo de Trabalho de Teste?
Quando uma geração falha, reescrever tudo de uma vez dificulta a identificação da causa.
Problemas Comuns com Prompts no H3 e Suas Soluções
| Problema | Causa Provável | Primeira Coisa a Testar |
| A pessoa errada fala | Mapeamento de locutor ambíguo | Travar (S1)/(S2) |
| O personagem muda | Sinais de identidade conflitantes | Simplificar referências |
| Referência ignorada | Papel ambíguo | Atribuir uma única função |
| Cortes aleatórios | Muitas instruções de tomada | Usar movimento de câmera |
| Marcação de tempo ignorada | Usada como timing de ação | Reservá-la para cortes |
| Saltos no FL2VA | Caminho de transição ausente | Descrever mudanças intermediárias |
| Final errado | Convergência fraca | Travar a composição final |
| Música indesejada | Camadas de áudio misturadas | Definir a música explicitamente |
| O texto muda | Terminologia não preservada | Citar o texto visível exato |
| O vídeo parece apressado | Muitos eventos | Reduzir batidas |
Um princípio útil é executar uma comparação controlada quando dois modos podem resolver a mesma tarefa, em vez de assumir que o modo mais complexo sempre produzirá o clipe melhor.
Um Fluxo de Trabalho Prático de Teste H3 Passo a Passo
Comece definindo o critério de aceitação da geração: talvez a identidade do personagem importe mais, ou talvez o rótulo do produto, a transição do ponto final, a autoria do diálogo ou o movimento da câmera sejam inegociáveis.
Em seguida, teste em camadas: estabeleça o personagem e a cena primeiro; adicione movimento e câmera em seguida; adicione voz e som após o comportamento visual estar estável; introduza cortes extras, storyboards ou personagens adicionais somente após a versão mais simples funcionar. A regeneração em alta resolução deve vir depois que o resultado semântico estiver correto, pois uma resolução mais alta não consegue resolver relacionamentos de referência contraditórios.
Essa abordagem em etapas é especialmente útil em pipelines de vídeo escaláveis. Para fluxos de trabalho que transformam conhecimento repetível ou conteúdo de negócios em vídeo, incluindo ferramentas de treinamento de documentos em vídeo como o Leadde, separar a estrutura de conteúdo, o comportamento visual, a narração gerada por IA e a renderização final torna as revisões mais fáceis de isolar, evitando que você precise reconstruir toda a produção a cada ajuste.
Salve Tomadas Bem-Sucedidas em Vez de Regenerar Tudo
Para projetos mais longos, trate cada clipe bem-sucedido como um ativo de produção validado. Se a Tomada 1 e a Tomada 2 funcionarem, mas a Tomada 3 falhar, regenere apenas a seção com falha em vez de descartar tudo o que foi feito antes.
Os fluxos de trabalho da comunidade H3 já utilizam tomadas com pontos de salvamento por esse motivo: uma vez que uma seção bem-sucedida é salva, os experimentos subsequentes podem ser executados novamente sem pagar repetidamente o custo computacional e criativo de recriar o material anterior.
Isso leva a um princípio de produção mais amplo:
Gerar → validar → salvar → continuar.
No caso de vídeos com IA, a criação de prompts eventualmente se transforma em engenharia de fluxo de trabalho.
Conclusão
A criação de prompts para o MiniMax H3 funciona melhor quando a tarefa está claramente estruturada, em vez de ser apenas descrita com mais palavras. Escolha o modo mais simples que se adapte à tomada, descreva mudanças observáveis, separe os atributos fixos das variáveis, atribua a cada referência um papel específico e depure uma camada de vez. Para fluxos de trabalho avançados de Ref2VA, a vantagem real vem de tornar explícitas as relações entre personagens, movimento, câmera, áudio e quadros-chave — transformando, em seguida, as gerações bem-sucedidas em blocos de construção reutilizáveis para a próxima tomada.