如何用一张照片制作会说话的虚拟形象(6个简单步骤)
只需一张照片即可轻松制作会说话的数字人:上传清晰的肖像,添加文案或画外音,选择 AI 声音,即可生成具备逼真口型同步和面部动作的视频。无需摄像机、录音设备或剪辑经验。
借助 Leadde,你可以将照片转化为会说话的 AI 数字人,并将其用于制作教育视频、产品解说视频和培训内容。
在本指南中,你将学习如何通过 6 个简单步骤用照片制作会说话的数字人、探索 AI 工具、提升视频真实感,并解决常见的口型同步问题。
如何通过 6 个步骤用照片制作会说话的数字人
你可以使用 AI 照片动画工具(如 Leadde)来制作会说话的数字人。该过程包括准备图片、添加语音、生成面部动作以及导出成品视频。
以下是以 Leadde 为例的实用工作流。
第 1 步:选择一张清晰的照片
从主体面向镜头的优质肖像开始。
为了获得更好的效果:
- 使用清晰、光线充足的照片。
- 保持眼睛和嘴巴清晰可见。
- 选择自然的微表情。
- 避免使用强力滤镜、阴影和面部遮挡物。
简单的半身照或自拍照通常效果很好。请确保你拥有使用该人物肖像的权限,特别是当你正在评估商业使用 AI 数字人是否合法时。
第 2 步:上传你的照片
访问 Leadde 的 AI 照片说话生成器,并在网络应用程序中选择照片数字人。
上传你的肖像以创建 AI 主播。Leadde 会根据该图片生成能够对语音内容做出反应的面部动画。
你还可以探索其图片数字人功能,创建可重复使用的虚拟人物作为你的数字主播。
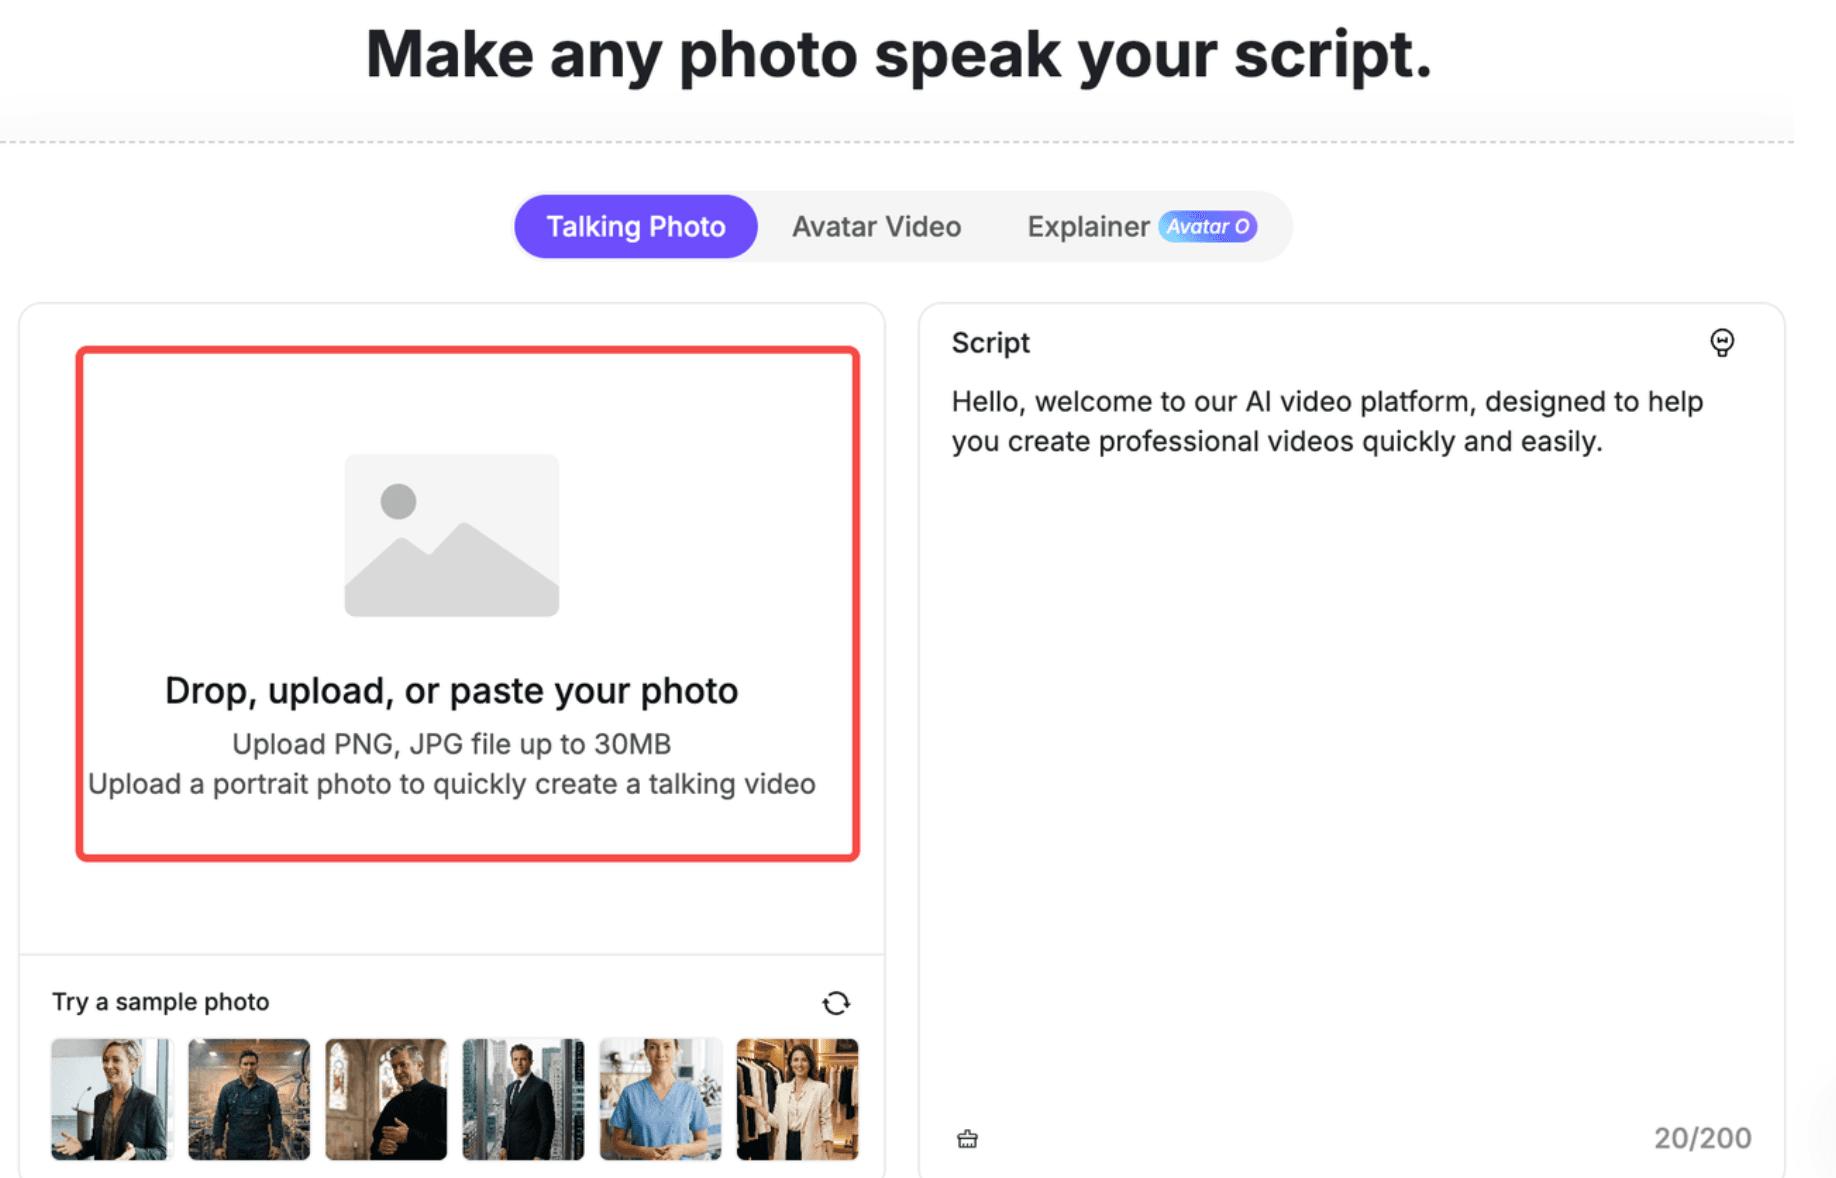
第 3 步:添加文案或音频
写下你想让数字人说的话。如果你在组织信息结构方面需要帮助,请查看我们的视频文案模板与示例。
例如:
“欢迎来到我们的产品教程!今天,我将向你展示如何在三个简单步骤内轻松上手。”
保持句子简短且对话化。自然的文案能让 AI 生成的语音更容易被理解。
一些 AI 数字人平台还支持上传音频。当你想要保留已录制演讲者的发音或语调时,这非常有用。
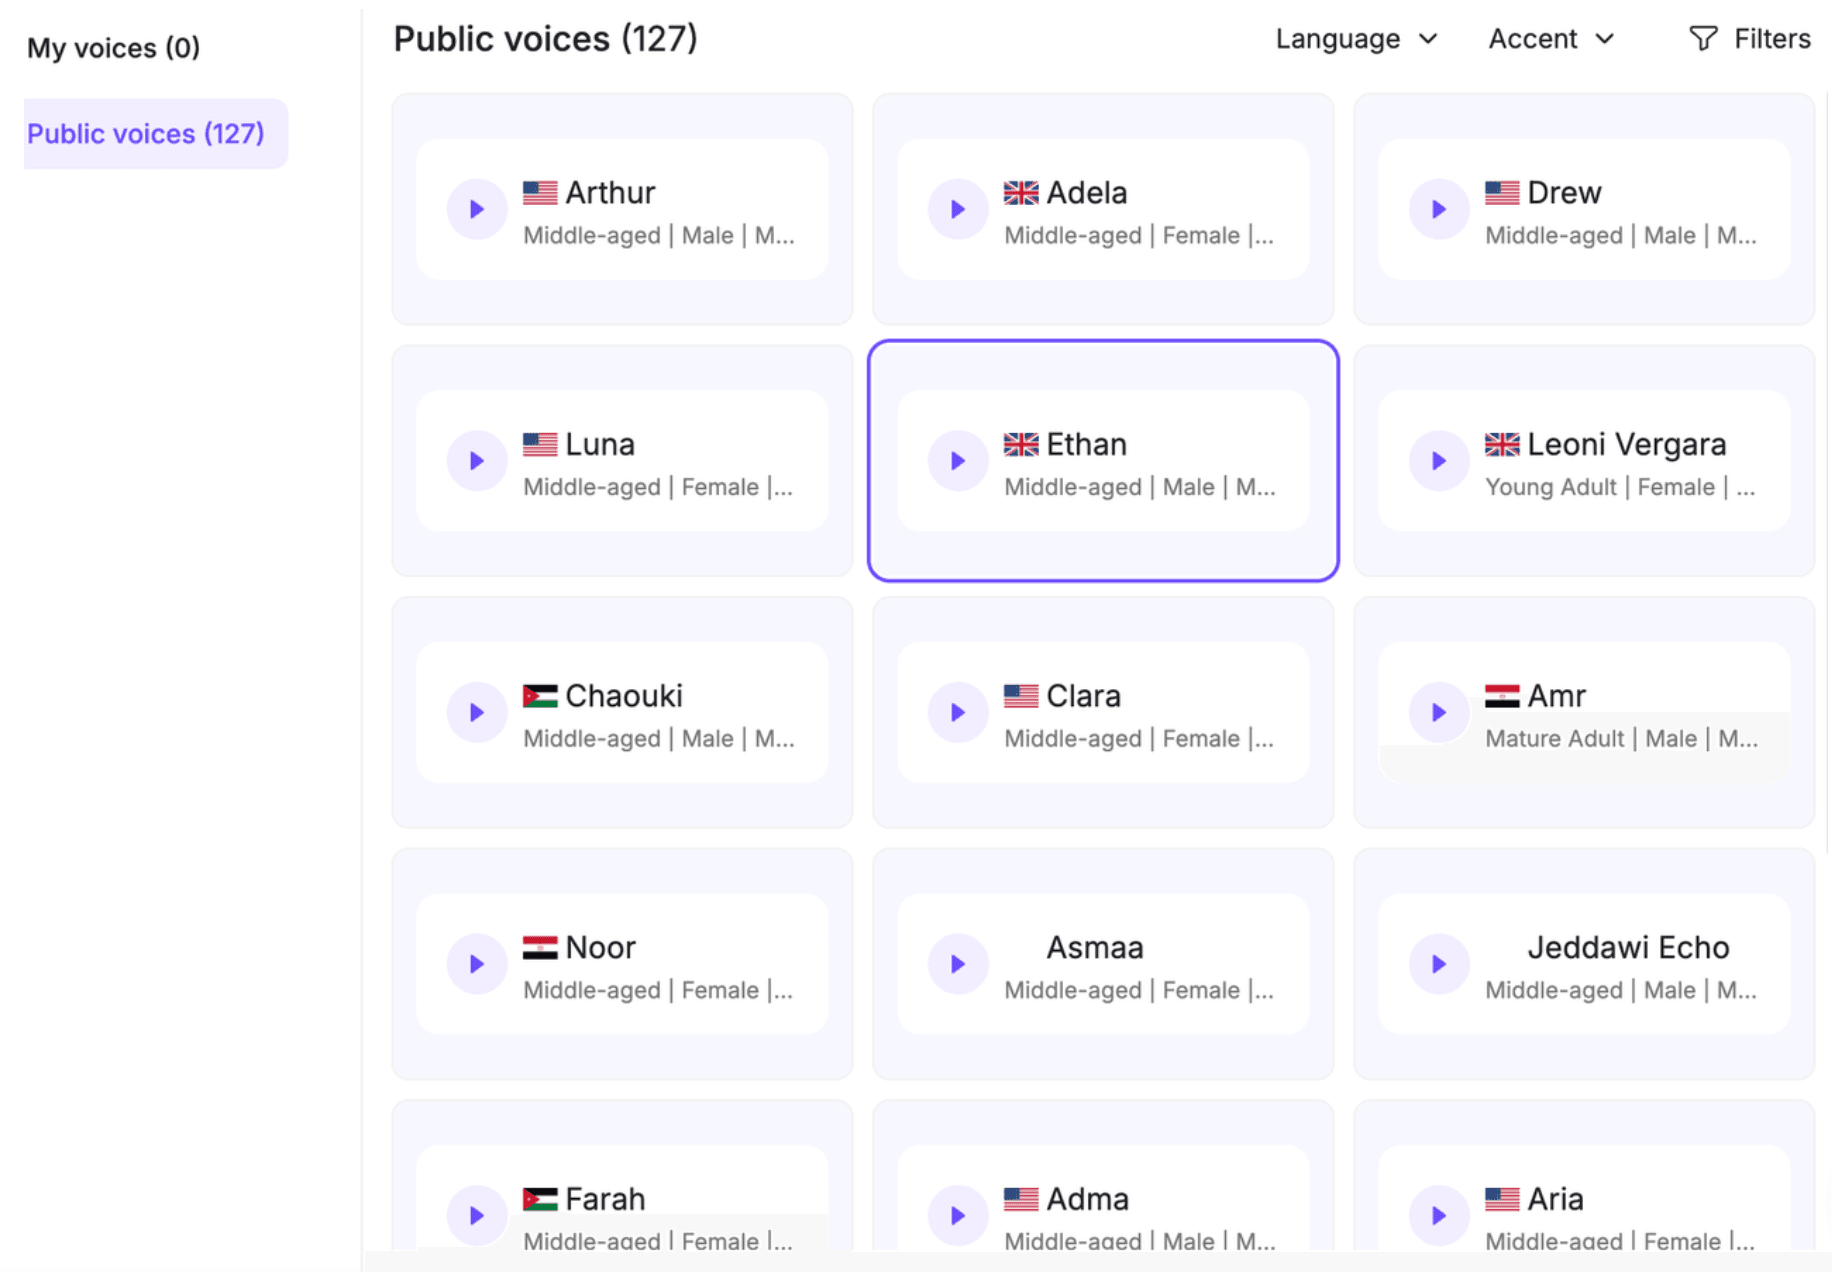
第 4 步:选择声音并自定义
选择与你的内容相匹配的 AI 声音。
对于教育视频,清晰、平静的声音效果很好。营销视频则可以从更具活力的语调中受益。
Leadde 提供 AI 声音以及自定义视频演示的选项,包括背景和视觉元素。
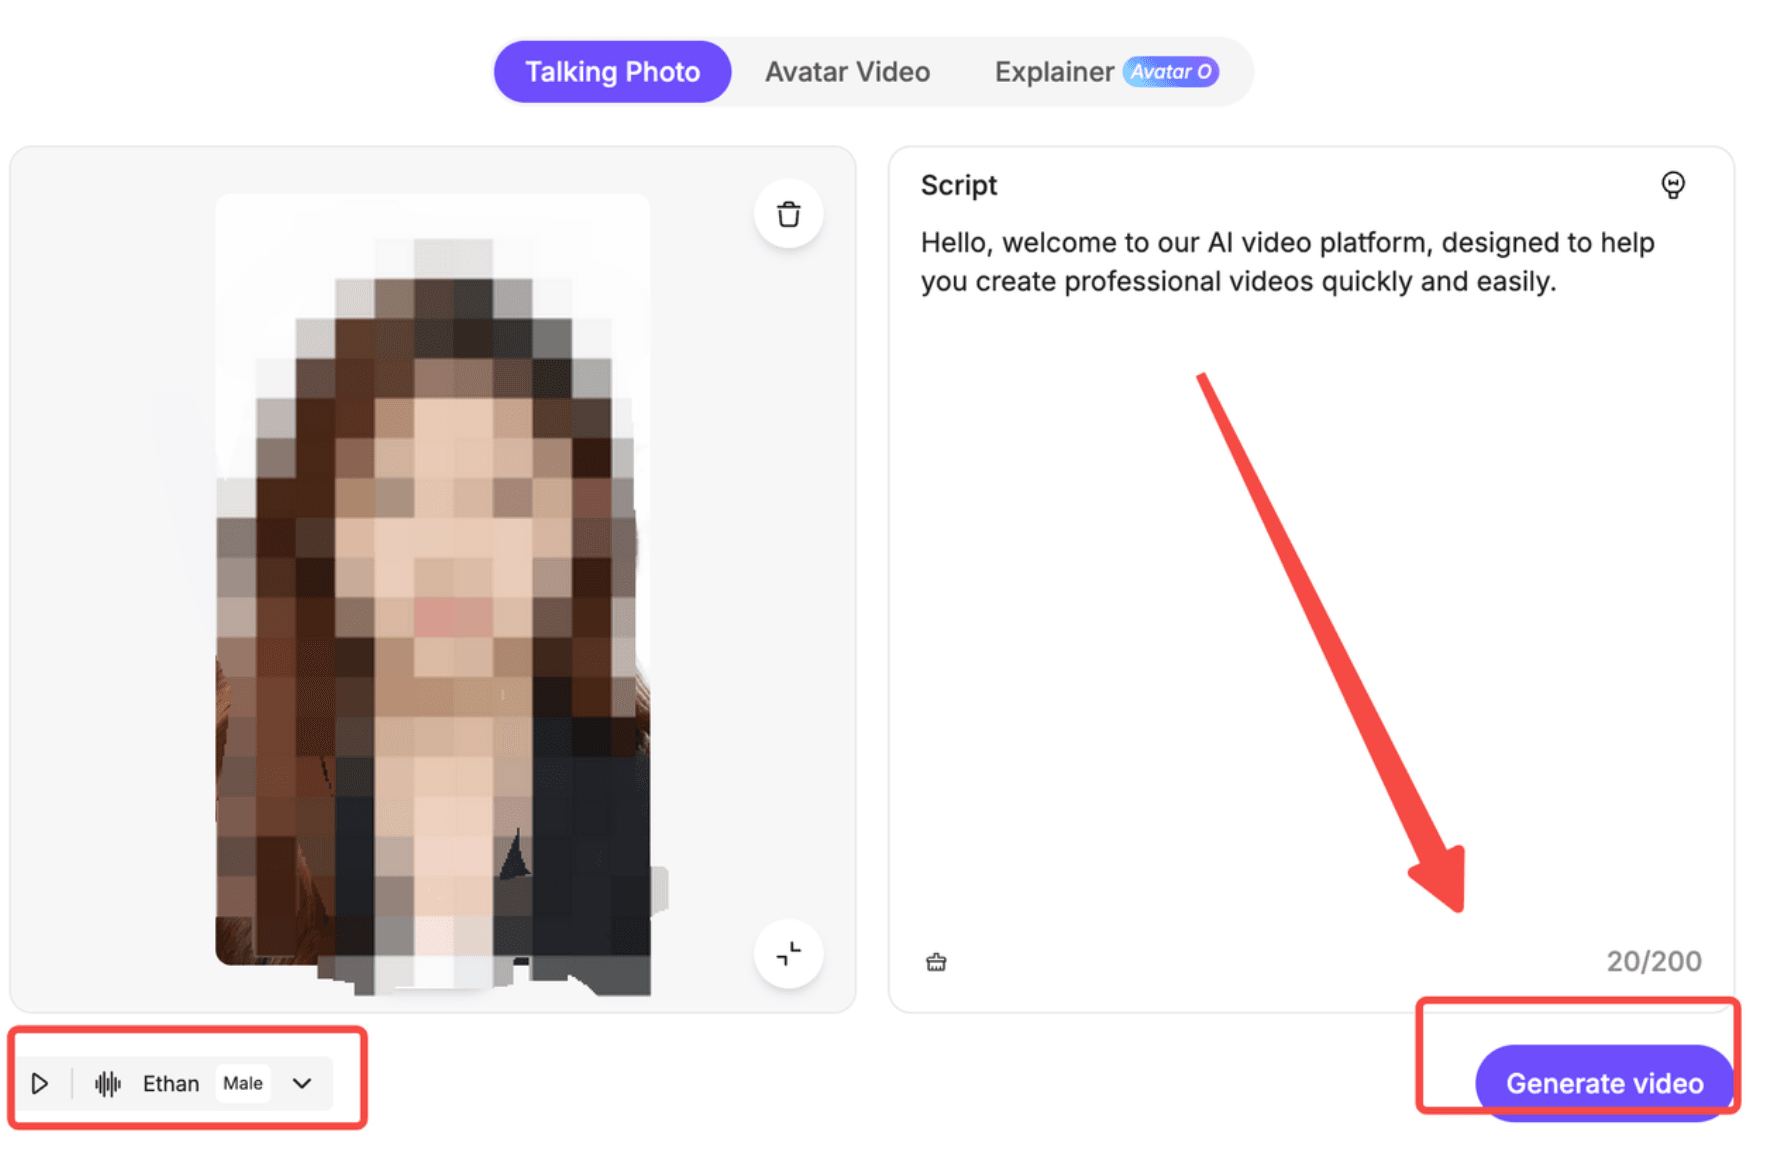
第 5 步:生成并预览
点击生成视频,让 AI 创建你的会说话数字人。
在制作较长的视频之前,建议先测试一小段文案。
检查生成结果的以下方面:
- 准确的口型动作
- 自然的面部表情
- 清晰的发音
- 连贯的面部外观
如果发现任何不自然的地方,请在生成下一个版本前调整源照片或文案。
第 6 步:导出你的会说话数字人视频
一旦满意,请使用可用的格式和分辨率导出你的视频。
用于发布:
- 16:9: YouTube 视频、演示文稿和培训课程。
- 9:16: TikTok、Instagram Reels 和 YouTube Shorts。
- 1:1: 正方形社交媒体帖子。
导出选项和分辨率限制取决于你所选择的订阅方案。
什么是会说话的数字人?什么样的照片效果最好?
会说话的数字人是由静态图像创建的 AI 生成合成视频角色。AI 会分析面部特征,并将其与语音相结合,以驱动口型动作、表情以及有时还包括头部手势。
与传统视频录制不同,会说话的数字人可以播报新的文案,而无需原本人员再次出镜。
AI 如何将照片变成会说话的数字人?
会说话的数字人生成器通常结合了三种技术:
- 面部分析: 识别面部特征点和视觉特征。
- 语音生成或处理: 将书面文案转换为音频或处理现有录音。
- 音频驱动的动画: 生成与语音对齐的口型动作和面部运动。
会说话的照片可以创建动画剪辑,而可重复使用的 AI 数字人则可以充当常驻主播。交互式数字人则更进一步,能够对用户的输入做出动态响应。
逼真 AI 数字人的照片要求
原始图像对视频质量有着重大影响。
在上传前请使用此检查清单:
| 照片元素 | 推荐条件 |
| 分辨率 | 清晰、高质量的肖像 |
| 面部位置 | 正面朝向、居中 |
| 光线 | 均匀,无强烈的阴影 |
| 表情 | 自然或中性 |
| 嘴部可见性 | 无遮挡 |
| 背景 | 简单、不杂乱 |
实用技巧: 上传前放大面部。如果眼睛或嘴巴显得模糊,请使用更好的源图像,而不是指望 AI 动画能恢复丢失的细节。
可以让自拍照、老照片或插画动起来吗?
可以,具体取决于所使用的工具。
当面部细节清晰可见时,自拍照和专业半身照通常都很适用。
如果面部足够清晰,老照片也可以使用。然而,划痕、模糊和面部细节缺失会降低动画质量。
一些平台支持插画角色,但其他平台则要求是逼真的真人照片。例如,Leadde 的通用数字人指南建议使用真实的相片,而不是卡通、截图或经过大量修图的图像。
在上传之前,请务必检查所选工具的图像要求。
哪些 AI 工具可以用照片制作会说话的数字人?
几个 AI 平台都可以让照片动起来,但它们的工作流各不相同。如需全面了解,请查看我们的顶尖 AI 数字人生成器指南。
最佳选择取决于你需要的是简短的说话剪辑、可重复使用的数字主播,还是完整的教育视频。
最佳 AI 说话数字人生成器对比
| AI 工具 | 最适合用于 | 核心工作流 |
| Leadde | 培训、教育、商业演示 | 照片数字人、文案、文档转视频 |
| HeyGen | 数字主播和可重复使用的数字人 | 照片数字人创建与数字人视频 |
| Fliki | 配音视频和创作者内容 | 照片说话、AI 声音、视频剪辑 |
| PixVerse | 角色动画与短视频 | 结合图像与音频的数字人口型同步 |
| D-ID | 面向开发者的数字人工作流 | 照片驱动的视频生成与 API |
这些工具在声音选项、动画模型、使用限制和编辑功能上各有不同。
如果你只需要一个简短的剪辑,专门的说话照片生成器可能就足够了。
对于培训或产品教育,完整的视频创作平台可能更有用,因为你还需要结构化的文案、配套的视觉素材和可重复的编辑工作流。
可以免费制作会说话的数字人吗?
可以。一些 AI 数字人平台提供免费方案或试用权限。
例如,Leadde 提供包含数字人视频创作和自定义照片数字人的免费方案(受方案额度限制)。
然而,免费使用并不一定意味着无限下载。
在选择工具前请核对以下细节:
- 视频生成点数或额度
- 视频最大时长
- 水印限制
- 导出分辨率
- 商业使用权限
同时还要考虑重新生成的成本。如果你需要多次尝试才能达到准确的口型同步,总制作成本可能会高于成功制作单个视频的成本。
如何让会说话的数字人看起来和听起来更自然?
逼真的会说话数字人不仅需要准确的口型动作。它的声音、面部表情、节奏以及整体表现应该相辅相成。
选择合适的声音并编写自然的文案
大多数会说话的数字人工作流采用以下三种声音方法之一:
| 声音方法 | 最佳应用场景 |
| 文字转语音 | 快速配音和频繁更新的文案 |
| 上传音频 | 保留现有的语音表现 |
| 声音克隆 | 重复使用授权演讲者的声音 |
为了实现自然的解说,请使用简短的句子、熟悉的词汇和适当的标点符号。
以音频为先的工作流可以提高制作一致性: 确定最终文案、生成或录制画外音、检查发音,然后创建数字人动画。
这对于员工培训、产品教程和定期发布的品牌视频特别有用。
音频上传和声音克隆的可用性因平台而异。
如何改善口型同步、面部表情和数字人一致性
在专业的视频工作流中,视觉质量应该从多个维度进行评估,而不应仅仅根据口型同步来判断。
使用这个数字人质量五点检查法:
- 口型同步准确度: 嘴部动作是否与所说的话对齐?
- 身份一致性: 在整个视频中,面部是否保持可识别性?
- 面部动作: 眨眼、表情和头部运动看起来是否自然?
- 语音播报: 发音、语速和停顿是否合适?
- 视觉连贯性: 角色在各个场景之间是否保持外观一致?
对于较长的解说,建议将解说拆分为较短的段落。
这使得单个剪辑更容易审查,并允许你插入幻灯片、屏幕录像或相关的视觉素材,而不是一直展示不间断的头部特写。
常见的会说话数字人问题及解决方法
即使图像很好,AI 生成的说话视频也可能包含视觉或音频问题。
| 问题 | 可能原因 | 推荐解决方法 |
| 口型不同步 | 音频时序或文案不匹配 | 检查音频并重新生成 |
| 面部模糊 | 源照片质量低 | 上传更清晰的肖像 |
| 不自然的表情 | 动画或源图像不合适 | 尝试更简单的动作或换一张照片 |
| 机器感解说 | 文案过于密集或声音不适合 | 缩短句子并调整语调 |
| 外观不一致 | 场景之间的差异 | 重复使用相同的数字人素材并检查转场 |
每次只更改一个变量。 这有助于确定问题是来自图像、声音还是动画设置。
如何将会说话的数字人应用于教育、培训和营销?
当组织需要重复传达信息,而又无需为每个视频都录制一个主播时,会说话的数字人就派上用场了。
当它们与清晰的解释、相关的视觉素材以及井然有序的内容工作流相结合时,其价值会倍增。
用于教育视频和员工培训的会说话数字人
教育工作者可以使用 AI 数字人来引出课程、总结概念和阐明学习目标。
企业培训团队可以将其用于入职培训、工作场所政策和标准操作程序。
例如,一家准备员工入职视频的公司可以:
- 按主题组织培训文档。
- 为每个学习目标编写简短的文案。
- 使用统一的 AI 数字人来引导每节课。
- 添加截图、流程图和字幕。
- 在与员工分享视频前检查准确性。
从教学设计的角度来看,数字人应该起到引导解说而非取代有效演示的作用。
用于产品解说、营销和多语言视频的会说话数字人
营销和 SaaS 团队可以使用会说话的数字人进行产品介绍、功能解说、客户教育和社交视频。
常驻数字主播可以帮助在多个视频中保持一致的视觉形象。
多语言工作流是另一个实际应用。团队可以针对不同的受众调整审核过的文案和解说,而无需为每种语言安排新的主播录制。
然而,口语内容仍然需要进行翻译审核,尤其是对于技术术语。
从会说话的照片到完整的 AI 培训视频
会说话的照片只是高效教学视频的一个组成部分。
对于更复杂的内容,团队需要文案、配套的视觉素材、结构化的场景以及高效的审核流程。
这就是 Leadde 的 AI 视频创作工具 超越基础照片动画的地方。
Leadde 可以将 PDF、PowerPoint 演示文稿、文档和文案转化为包含 AI 生成解说、结构化场景和数字主播的视频。
一个实用的工作流是:
照片数字人 → PDF 或 PPT → 结构化视频场景 → AI 解说 → 内容审核 → 多语言视频
例如,培训团队无需让数字人阅读整本员工手册,而是可以将文档分成简短的主题,使用辅助视觉素材来解释流程,并在政策变更时更新相关的视频部分。
其结果不仅是一张会说话的照片,更是一种传达业务知识的可复用方法。
关于用照片制作会说话数字人的常见问题
我可以不用录制视频,直接用照片制作会说话的数字人吗?
可以。AI 会说话数字人生成器使用文字文案或音频输入来让静态图像动起来。你不需要拍摄自己或录制真人表演。只需上传合适的肖像,选择声音,即可生成带有同步语音和面部动画的视频。
我可以用自己的声音让照片说话吗?
可以,前提是你选择的平台支持音频上传或声音克隆。你可以录制自己的解说并将其用作语音源,或者创建一个授权的 AI 声音模型。为了获得最佳效果,请使用背景噪音极小的清晰音频。
我可以从老照片制作会说话的数字人吗?
一些 AI 工具可以在面部特征清晰可见的情况下让老照片动起来。然而,受损、模糊或低分辨率的图像可能会产生不自然的结果。在动画制作前提高图像清晰度可能会有所帮助,尽管修复可能会引入原始照片中不存在的面部细节。
会说话的数字人会说不同的语言吗?
会。许多 AI 数字人平台提供多语言声音或视频翻译功能。Leadde 支持多语言视频生成,这使其非常适合国际培训和产品沟通。语言可用性和口型同步质量取决于所选的工作流和模型。
生成一个会说话的数字人需要多长时间?
生成时间因平台、视频时长、模型和处理需求而异。一个短剪辑可能只需要几分钟,而较长的视频或反复修改则需要额外的时间。请留出额外的时间来检查发音、面部动画和导出的视频。
我可以将会说话的数字人用于商业视频吗?
许多平台在特定的方案或许可条款下允许商业使用。在发布广告、培训内容或产品视频之前,请检查提供商当前的使用条件。你还必须对视频中包含的源图像、声音和其他材料拥有相应的权利。
我可以用 AI 让别人的照片动起来吗?
只有在获得必要的许可或其他合法依据的情况下才可以。在未经授权的情况下使用他人的肖像或声音可能会引起隐私、公开权和冒充方面的担忧。避免误导性表现,并在发布平台适当或要求时披露合成媒体。
结论
用照片制作会说话的数字人始于清晰的图像、自然的文案和 AI 视频生成器。为了获得更好的效果,请在发布前检查声音质量、口型同步、面部表情和视觉连贯性。借助像 Leadde 这样的工具,你可以超越单一的说话照片,为教育视频、员工培训和产品沟通创建可重复使用的 AI 主播。