长篇PDF转视频:关键信息,一字不漏
将长篇PDF转化为视频而不丢失关键信息,远不止一键总结那么简单。最稳妥的方法是首先梳理文档结构,识别必须保留的事实、步骤、条件和例外,然后将其转化为视频场景,并对照原文进行验证。
这对于培训手册、SOP(标准操作程序)、研究报告、产品文档以及其他信息密集的PDF文件尤为重要,因为其中任何一个遗漏的警告、数字或例外都可能改变内容的含义。
像Leadde这样的工具可以简化这一流程,将PDF及其他文档转化为结构化的视频工作流,提供AI生成的脚本、旁白、视觉内容和多语言输出。然而,最佳效果仍需将自动化与源文档映射、大纲审查、脚本检查和最终覆盖验证相结合。
长篇PDF转视频:如何在不丢失关键信息的情况下进行转换?
长篇PDF转视频的工作流应优先保留原意,而非简单缩短文字。最稳妥的步骤如下:
- 审计源PDF。
- 映射章节、段落、程序和证据。
- 识别必须保留的信息。
- 将源文档拆分为逻辑视频单元。
- 生成并审查大纲。
- 将已批准的内容转化为口语脚本。
- 创建忠实于源文档的视觉内容。
- 将最终视频与原始信息图进行比对。
将PDF转化为视频究竟意味着什么?
“PDF转视频”可以指代多种截然不同的产出。
旁白式PDF本质上是展示页面,同时配以语音朗读或总结。视频摘要则提取主要观点并压缩文档。而结构化的教学视频则围绕观众需要理解或执行的任务,将源文档重组为不同的场景。
对于长篇文档而言,第三种方法通常最为实用,因为PDF页面是为阅读而设计,而非必然适用于视听教学。
为什么长篇PDF会带来信息压缩难题?
现代多模态模型能够处理超大型PDF输入。例如,Google已证明其PDF理解能力涵盖文本、图像、图表和表格,可处理多达1000页的文档。
然而,输入容量不等于信息覆盖率。
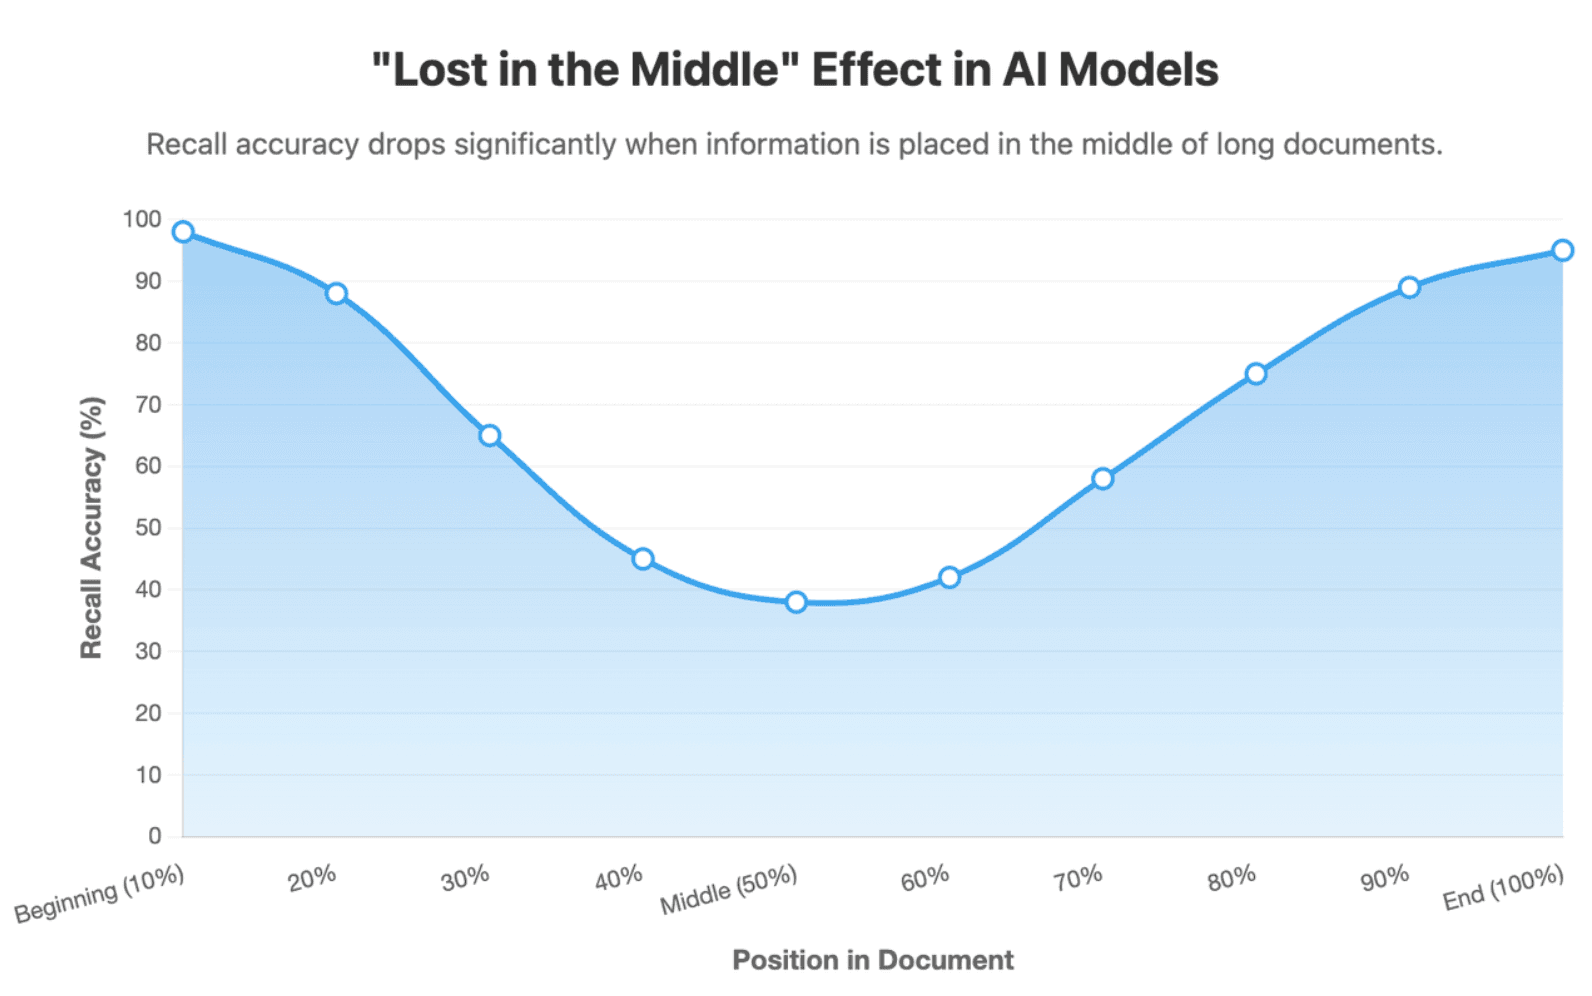
对长上下文语言模型的研究表明,模型性能会因重要信息在长输入中出现的位置而异,中间部分的信息有时被利用的可靠性较低。
实际意义很简单:不要因为AI接受了100页文档,就认为所有重要细节都已纳入五分钟的视频中。
将长篇PDF转化为视频前,您应该检查什么?
许多归因于“AI总结”的错误,实际上早在文档提取阶段就已经产生。
检查PDF是否易于AI读取
低风险PDF通常具有原生可选文本、清晰的标题、逻辑阅读顺序和简单的表格。
高风险文件包括:
- OCR识别能力较弱的扫描页面;
- 多栏布局;
- 跨多页的表格;
- 密集的脚注;
- 公式和技术图表;
- 包含关键文本的截图;
- 不一致的页面布局。
如果提取的源文档本身就不可靠,请勿直接进行视频生成。
确认结构、版本和信息来源的真实性
对于SOP、合规材料、政策和培训内容,请确认PDF是当前批准的版本。
在生成任何内容之前,请明确章节、程序、附录、修订日期和内容所有者。高效地转换过时文档,最终仍会产生过时的培训内容。
根据信息风险选择工作流
| 信息风险 | 典型内容 | 建议控制措施 |
| 低 | 营销或概念性解释 | 更多自动化 |
| 中 | 产品教育或标准培训 | 大纲 + 脚本审查 |
| 高 | 安全、合规、财务或技术程序 | 源文档映射 + 领域专家 + 视觉验证 |
错误代价越高,工作流就越不应仅依赖自动总结。
长篇PDF应该制作成一个视频,还是多个短视频?
通常,页数不应决定视频结构。
一个概念可能始于第12页,在第13页使用表格,并在第14页解释其例外情况。将每一页都视为独立的场景可能会破坏这种关联性。
根据学习目标或用户任务拆分内容
从教学设计的角度来看,一个更强的单元通常是一个连贯的观众目标。
一份50页的入职手册可以拆分为独立的入职视频,例如:
- 账户设置;
- 安全要求;
- 工作场所政策;
- 报告流程;
- 故障排除。
这通常比将整本手册强行压缩成一个短视频更有用。
压缩前先进行信息预算
每个视频的旁白时间和观众注意力都是有限的。
在缩短文档之前,请将可用运行时长与必须保留的信息单元数量进行比较。如果一个五分钟的视频无法清晰地解释这些内容,请制作另一个视频,而不是删除更多源内容。
这一点尤为重要,因为一些文档转视频产品明确承认,较长的PDF可能会降低总结质量。例如,Pictory目前表示,50页以下的PDF能使其“文档转视频”功能获得最佳效果,并建议如果遗漏了关键点,则应拆分更长的文档。
如何决定哪些信息必须保留在视频中?
目标并非保留每个句子。而是要保留所有能改变观众理解、决策或行动的细节。
创建一份“必须保留信息”图
在编写视频脚本之前,请对源文档进行分类:
| 优先级 | 处理方式 |
| 必须保留 | 必须准确呈现在视频中 |
| 应该保留 | 可压缩但应保留 |
| 辅助信息 | 可缩短的示例或背景 |
| 仅供参考 | 可保留在PDF中,无需旁白 |
必须保留的内容通常包括定义、日期、数字、步骤、警告、限制、依赖关系、条件和例外。
保护注意事项、条件和例外
细微的词语可能承载着巨大的含义。
思考以下两句话的区别:
“该流程能提升性能。”
以及:
“在特定条件下,该流程可能会提升性能。”
删除“可能”或“在特定条件下”会使声明比原文更绝对。
对于高风险PDF,除了主要信息图之外,还应维护一个简单的注意事项和例外登记表。记录规则时,应包含“仅当”、“除非”、“除了”、“大约”、“必须”和“应该”等短语。
重要性取决于观众目标
不同文档需要不同的保留规则。
SOP需要其顺序、决策点、条件和警告。研究论文需要其方法、发现和局限性。执行报告可能优先关注KPI、风险和建议。
因此,AI在决定哪些内容可以舍弃之前,应了解受众和目标。
如何将PDF转化为精准的大纲、脚本和视觉故事?
最稳妥的工作流是逐步从源文档结构过渡到视频结构,而非直接从PDF跳到最终的MP4。
构建源文档到场景的映射
从以下开始:
文档 → 章节 → 段落 → 概念 → 主张或步骤 → 证据
然后将这些单元连接到计划的场景。
| PDF来源 | 必须保留信息 | 视频场景 | 视觉内容 | 状态 |
| §3.2 | 密码每90天过期 | 场景4 | 时间轴 | 已覆盖 |
| §3.3 | 服务账户例外 | 场景5 | 标注 | 已覆盖 |
这能带来大多数一键式工作流所缺乏的:可追溯性。
它也使大纲审查变得具体。如果某个源文档部分消失,应将其标记为已合并、仅供参考、有意排除或意外遗漏。
当前一些AI视频工作流已经认识到在生成前审查结构的重要性。例如,Synthesia的助手在创建场景之前会返回一个可编辑的大纲,允许修改或添加章节和关键点。
在不改变含义的前提下转换脚本
视频脚本不应逐字逐句地照搬PDF内容。
您可以缩短句子、解释术语、添加过渡语,并将书面散文转化为自然的口语。但请勿随意更改术语、数字、限定性语言、程序顺序或例外情况。
一个实用的制作原则是:
先确保准确性,再优化风格。
此外,请将源文档事实与解释性补充内容区分开来。如果脚本为了提高学习效果而添加了类比或示例,审查人员应清楚这是编辑添加的,而非直接取自PDF。
保护承载信息的视觉内容
并非所有视觉内容都服务于同一目的。
装饰性视觉内容包括头像、背景和辅助镜头。
承载信息的视觉内容包括图表、表格、流程图、公式、截图和标签。
办公室的素材视频可能与营收报告相关,但它无法传达从12.4%到8.1%的变化。
当涉及精确信息时,优先选择:
原始视觉内容 → 裁剪/高亮/动画
或:
已验证的源数据 → 确定性图表渲染
而非要求生成式图像模型凭记忆重现精确数据。
对于AI编辑的视觉内容,请定义保留约束:明确哪些可以更改,哪些必须保持不变,例如数字、箭头、标签、产品几何形状或警告符号。
如何验证最终视频没有丢失关键信息?
最终的质量检查应比简单地观看一次视频更系统化。
采用三道审查关卡
- 关卡1:大纲审查 检查章节、顺序和覆盖范围。
- 关卡2:脚本审查 检查事实、名称、数字、条件、例外和术语。
- 关卡3:最终视频审查 检查旁白、字幕、视觉内容、时间安排和本地化版本。
对于安全、合规、法律、财务或技术材料,在发布前增加领域专家审查。
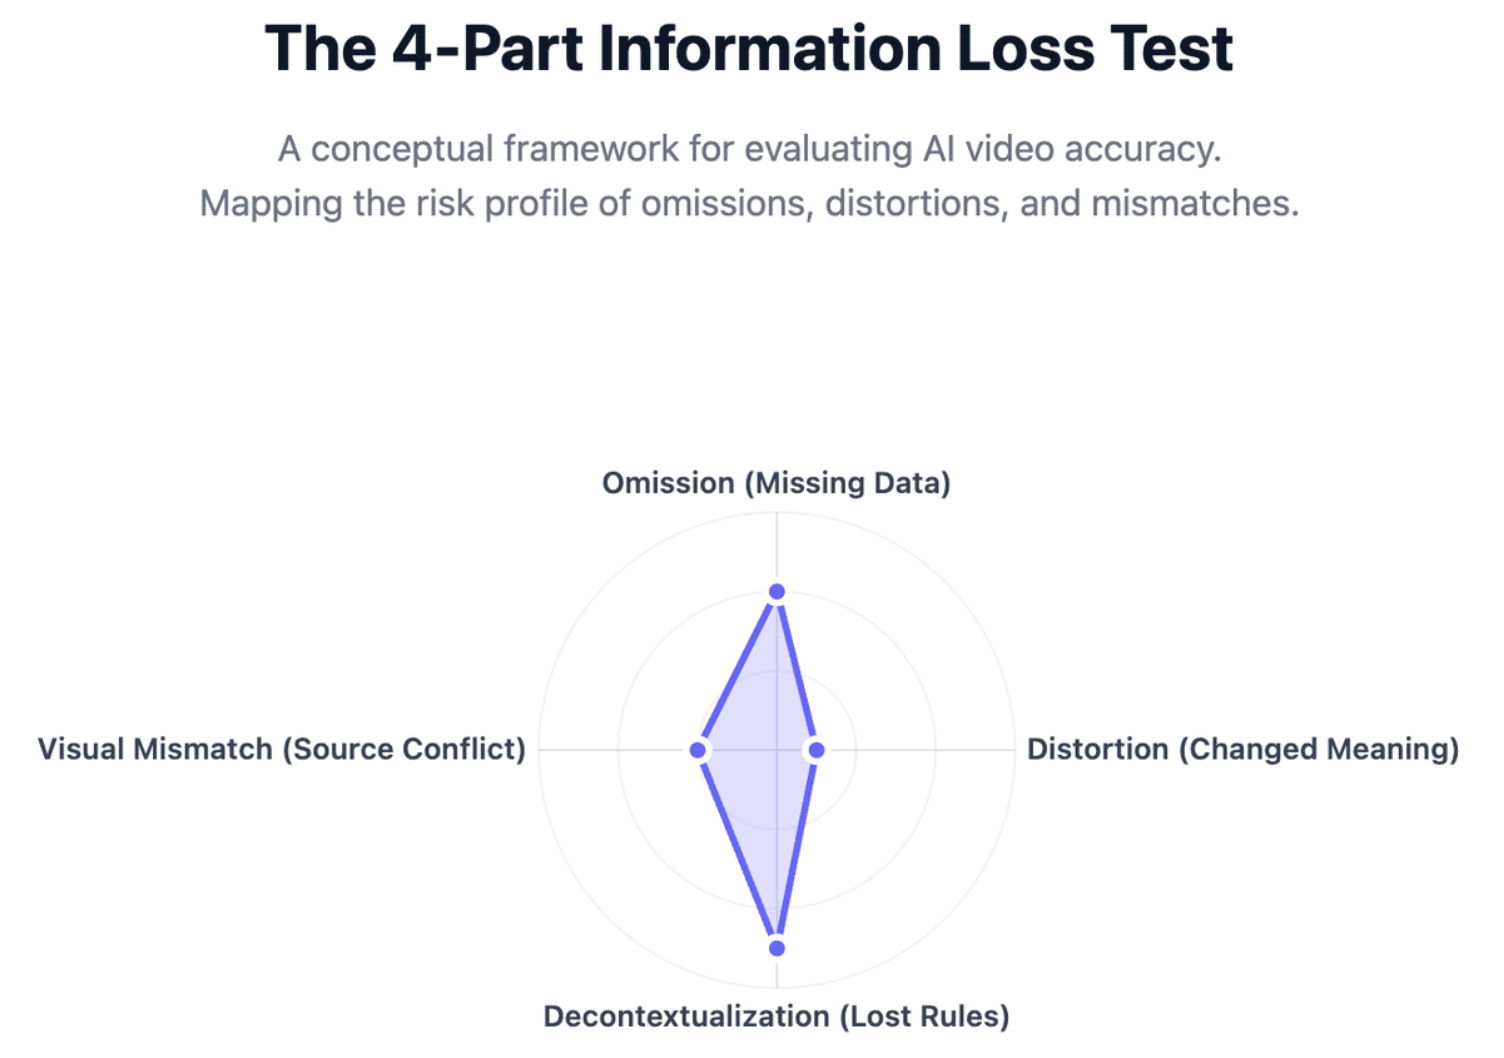
执行四部分信息丢失测试
提出四个独立问题:
| 失败类型 | 审查问题 |
| 遗漏 | 是否有重要观点消失? |
| 扭曲 | 其含义是否改变? |
| 去语境化 | 是否删除了条件或例外? |
| 视觉不匹配 | 视觉内容是否与源文档矛盾或误导? |
这比问“视频是否准确?”这种模糊问题更有用。
衡量覆盖率并保持可追溯性
团队还可以使用一个简单的内部指标:
覆盖率 = 正确呈现的必须保留项 ÷ 必须保留项总数
这是一种实用的质量保证方法,而非行业基准。
更重要的目标是零无故遗漏。如果某项内容被有意排除,请记录其原因。
源文档到场景的映射也使更新变得更容易。当PDF发生变化时,识别受影响的章节,找到相应的场景,并更新这些场景,而不是重新生成整个视频并引入新的措辞或视觉偏差。
关于将长篇PDF转化为视频的常见问题
AI可以将50页或100页的PDF转化为视频吗?
是的,现代AI系统可以处理大型PDF,但成功上传并不保证完整的信息覆盖。对于长篇文档,首先要映射结构并将其拆分为逻辑模块。如果多个重要目标争夺有限的视频时间,请制作系列视频,而不是将所有内容强行塞入一个短视频。
每页PDF都应该成为一个视频场景吗?
不。PDF页面是布局单元,不一定是学习或沟通单元。一个想法可能跨越几页,而一页也可能包含几个想法。围绕连贯的概念、程序、问题或观众任务来构建场景,而不是以页面边界为准。
由长篇PDF制作的视频应该多长?
没有单一的理想时长。应由学习目标和信息密度来决定运行时长。如果视频内容过于密集,无法清晰解释必须保留的信息,请将其拆分为模块,而不是删除越来越重要的细节。
AI可以在不丢失重要信息的情况下总结长篇PDF吗?
AI可以有效地总结长篇文档,但不应假设任何通用总结都能自动保留所有重要细节。长上下文研究表明,信息利用率在大型输入中可能有所不同。当完整性至关重要时,请使用章节级处理、源文档映射和明确的覆盖率检查。
在PDF转视频工作流中,处理图表和表格的最佳方式是什么?
当原始图表可读时,直接复用;当需要动画或简化时,从已验证的源数据重建。除非输出内容已单独对照源文档进行检查,否则请避免依赖生成式视觉内容来呈现精确数字。
扫描版PDF可以转化为视频吗?
是的,但扫描版PDF通常首先需要可靠的OCR(光学字符识别)或多模态文档处理。在视频生成之前,请检查阅读顺序、标题、数字、表格和标签。否则,在提取过程中引入的错误将流入脚本和视觉内容。
如何验证AI生成的视频是否准确?
将大纲、脚本和最终场景与源文档中提取的“必须保留信息”图进行比对。分别检查是否存在遗漏、含义改变、条件缺失、数字错误和误导性视觉内容。高风险内容还应接受领域专家审查。
总结
将长篇PDF转化为有用的视频,并非旨在保留每个句子或将数十页内容压缩到最短运行时长。目标是保留那些能改变观众理解、决策或行动的信息。源文档映射、结构化场景规划、脚本审查、视觉验证和最终覆盖率检查,使AI能够在加速制作的同时,不放弃对准确性的控制。