如何使用 MiniMax H3:提示词、参考图、音频和 ComfyUI 全面指南
MiniMax H3 的最佳使用方式是先选择正确的生成模式,再决定哪些部分应由文本、画面、参考图、运动轨迹和音频来控制。你可以通过文本生成,锁定第一帧或最后一帧,或使用图像、视频和音频来引导主体身份、运动轨迹、运镜行为以及人声。
由于 H3 将多模态参考与原生视听生成相结合,更好的效果通常源于清晰的控制,而不是更长的提示词。本指南将介绍如何选择合适的工作流、编写更好的提示词、使用参考图、管理对话与声音、进行高效测试,以及如何在 ComfyUI 或 API 中进行操作。
如果你的起点是PDF、演示文稿、SOP或培训文档,而不是创意提示词,那么Leadde会是更好的选择,它可以帮助你在手动导演 H3 中的每个场景之前(或代替手动导演),将结构化的源内容转化为视频工作流。
如何使用 MiniMax H3:你应该从哪个工作流开始?
使用 MiniMax H3 最快的方法是在编写提示词之前先选择生成模式。H3 支持文本、首尾帧输入以及多模态参考,但每种输入扮演的角色各不相同。MiniMax 官方的模型卡片将其开源权重检查点分为:用于文本和基于帧生成的 FL2VA,以及用于通过图像、视频或音频进行参考驱动生成的 Ref2VA。
| 模式 | 最适合 | 控制视频的要素 |
| T2VA | 从零开始创建场景 | 文本提示词 |
| I2VA | 从精确的图像开始 | 首帧 + 提示词 |
| L2VA | 到达特定的结尾 | 末帧 + 提示词 |
| FL2VA | 同时控制起点和终点 | 首帧 + 末帧 |
| Ref2VA | 保持身份、运动、运镜、风格或声音的一致性 | 多模态参考 + 提示词 |
你的图片是帧还是参考?
这一区别解决了许多控制难题。
帧是时间锚点。如果上传的产品图片必须是观众看到的绝对第一张图,请将其用作首帧。
参考图是可复用的信息。如果你在创建新构图时,仅需要产品设计、角色面部、服装或视觉风格保持一致,请将其视作参考。
MiniMax 的官方提示词指南明确了这一区别:I2VA 从提供的 0.00 秒图像开始,而全参考模式则根据每个资产所扮演的角色,分别追踪主体、图片、视频和音频。
H3 控制栈
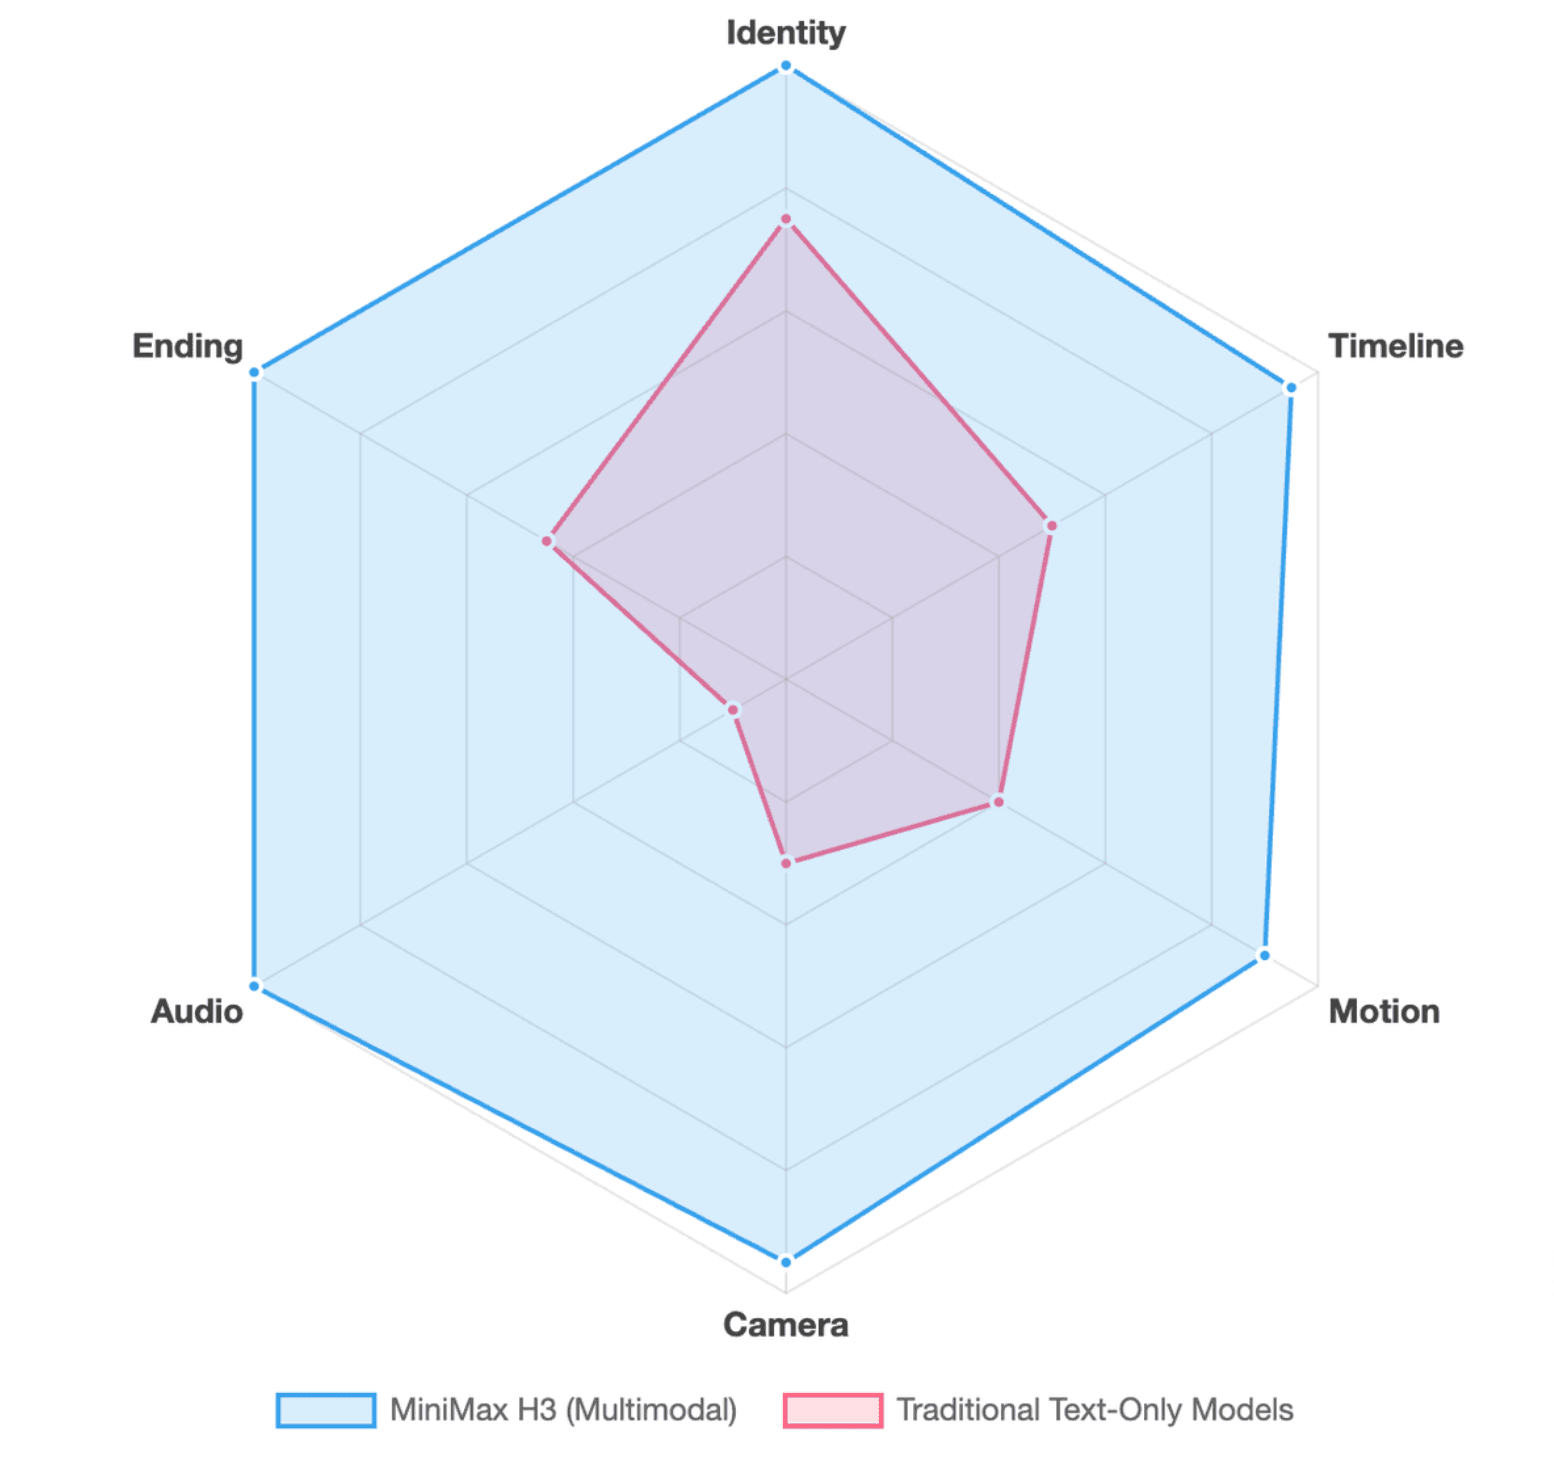
在编写提示词之前,请决定控制视频六大要素的方案:身份、时间线、运动、运镜、音频和结尾。
例如,商业广告视频可以使用参考图来确定产品身份,使用文本来描述产品动作,使用参考视频来控制运镜,使用原生音频指令来设计音效,并使用末帧来呈现最后的焦点镜头。
这可以避免一个常见错误:企图用一个长文本提示词来控制所有东西。
如何编写能提供更多控制权的 MiniMax H3 提示词?
一个实用的 H3 提示词会按播放顺序列出视频内容。它要求你像导演一样去描述那些实际可见、可听的内容,而不是像文案那样罗列形容词,这类似于编写高效视频脚本模板与示例时采用的最佳实践。
实用的结构为:
场景 → 主体 → 动作 → 运镜 → 对话/声音 → 结尾
MiniMax 的官方基础提示词格式遵循相同的底层逻辑。其 integrated_multimodal_description 按顺序描述镜头,而 overall_soundscape 和 non_diegetic_music 则分别控制物理音效和背景音乐。
按播放顺序构建场景
与其使用:
一部具有动感运镜的高端电影级护肤品广告。
不如使用可观察的序列:
玻璃精华瓶立在深色石头底座上。一束狭窄的光线扫过标签。瓶子缓慢顺时针旋转,同时镜头拉近。凝露折射出光线。瓶子停止旋转,Logo 正对镜头。
第二种版本为 H3 提供了可执行的可见状态变化。
此外,还要考虑复杂度预算。一个包含三个角色、四次转场、一次变身、两句台词、运镜以及多个参考的 10 秒剪辑,可能在技术上可以被描述,但这并不意味着所有这些事件都能自然地融入 10 秒之内。
有意识地指导运镜和转场
仅在镜头需要时才指定运镜行为:推入、拉远、摇镜头、跟镜头、俯仰、弧形运镜或保持静止。
避免将每一次构图调整都变成一次新的剪辑。从中景到特写的缓慢变化通常可以描述为镜头移动,而不是一个新场景。
定义结尾,而不仅仅是动作
当提示词解释了动作在何处结束时,它会变得更容易控制。
与其以“角色走向窗户”结尾,不如定义最终状态:角色在窗户旁停下,转身面向镜头,并以天际线为背景定格。
这对于产品演示视频、Logo 镜头、转场以及首尾帧工作流尤为重要。
如何在 MiniMax H3 中使用图像、视频、分镜和声音参考?
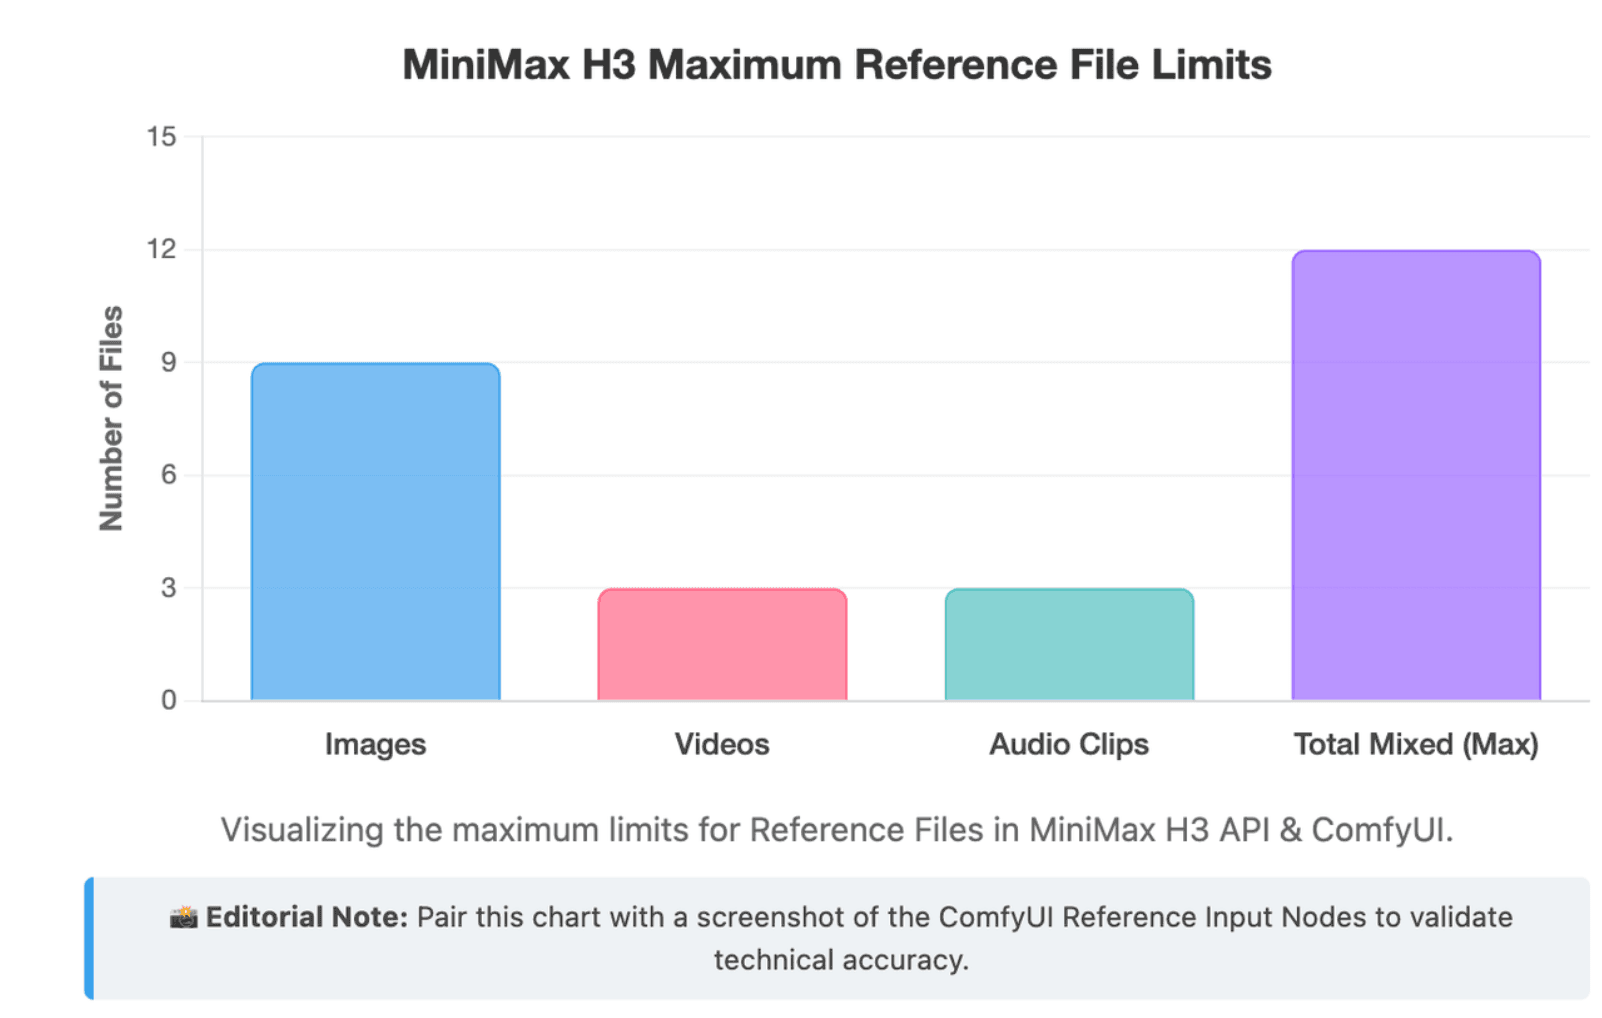
参考视频功能让 H3 超越了传统的图生视频工具。官方的 Ref2VA 模型接受多模态参考,并可利用它们来影响身份、运动、运镜行为、风格和音频。MiniMax 目前文档记录的支持上限为:总计最多 9 张图片、3 个参考视频、3 个音频片段和 12 个混合文件。
赋予每个参考一个明确的任务
强大的参考设置可能会这样分配:
图片 1 → 角色身份;图片 2 → 服装;视频 1 → 身体动作;视频 2 → 运镜;音频 1 → 声音。
ComfyUI 的官方 H3 文档推荐了相同的原则:按连接顺序引用每个输入,并明确说明哪个资产控制身份、风格、运动、运镜或声音。
更多的参考并不意味着自动获得更强的控制力,反而会给 H3 带来更多需要协调的关系。如果两张图片暗示了不同的服装,而参考视频包含另一个角色的外貌,除非提示词明确了这些职责,否则模型必须自行决定哪个信号最重要。
<Subject> 对比 <Picture>
在 MiniMax 的全参考格式中,<Subject N> 代表从参考资产中抽象出的可复用可见内容,例如人、物体、环境或其他元素。<Picture N> 代表用作帧或构图锚点的具体图像。<Video N> 和 <Audio N> 则用于追踪时间和音频参考。
这意味着一个主体不一定等于一个文件。一个角色可以结合来自一张图片的面部身份,以及来自另一个来源的服装或运动信息。
什么时候应该使用分镜?
当空间关系用语言比用画面更难解释时,分镜可以充当视觉规划层。这对于多镜头序列、产品发布、角色调度或重复出现的构图特别有用。
从 AI 视频工作流的角度来看,其优势不在于分镜能保证每一帧都完美,而在于它减少了必须纯靠文字传达的空间和镜头规划信息量。
如何在 MiniMax H3 中控制对话、音效和音乐?
H3 在生成视频的同时会生成原生立体声音频,而不是将音频当作单独的后期制作层。MiniMax 规定输出为 32 kHz 立体声,其提示词系统支持将对话、物理声音和非画外音音乐作为独立概念处理。
将对话作为镜头的一部分来编写
对话应回答四个问题:谁 in 说、说了什么、何时说、占用多少屏幕时间。
MiniMax 的结构化格式可以使用持久的说话者 ID(如 (S1))和对话标签(如 <d>[English]...</d>)。不过,初学者无需从语法开始。更重要的原则是时机。
使用对话预算
对话会消耗现实中的时间。
如果说话者出现 4 秒,切勿编写一句在现实中需要 8 秒才能说完的话。否则模型将被迫压缩、加速、截断或扭曲语音。
在实践中这非常重要,因为本地 H3 用户已经在配合视觉提示词迭代镜头时机和对话,而不是将语音视为独立的层。一项报道的 RTX 5080 测试使用了结构化的多镜头提示词,在生成本身保持高计算成本的同时,需要反复调整提示词。
将声景与背景音乐分离
使用声景来处理场景中物理存在的声音:脚步声、引擎、风声、门声、人群、织物摩擦声或机械声。
使用非画外音音乐来处理观众能听到但角色听不到的音乐。
将两者分离,能为 H3 提供比诸如“添加电影级音效”之类模糊指令更有用的指导。MiniMax 的官方提示词格式刻意将这两个音频层保持独立。
哪些设置和测试工作流能产出更好的 MiniMax H3 结果?
MiniMax 记录的 H3 输出时长为 4–15 秒、24 FPS、支持多种宽高比,开源 H3-Base 工作流的默认短边为 768 像素。其完整的系统可以通过 H3-Regenerate-2K 生成 2K 分辨率。
根据镜头选择时长、宽高比和分辨率
不要盲目选择最长的时长。应将时长与有意义的事件数量相匹配。
大多数横屏内容使用 16:9,竖屏社交视频使用 9:16,当正方形构图契合分发渠道时使用 1:1。在 ComfyUI 中,官方的 H3 工作流通过分辨率选择器公开了宽高比和百万像素控制,更高的像素数会增加生成成本。
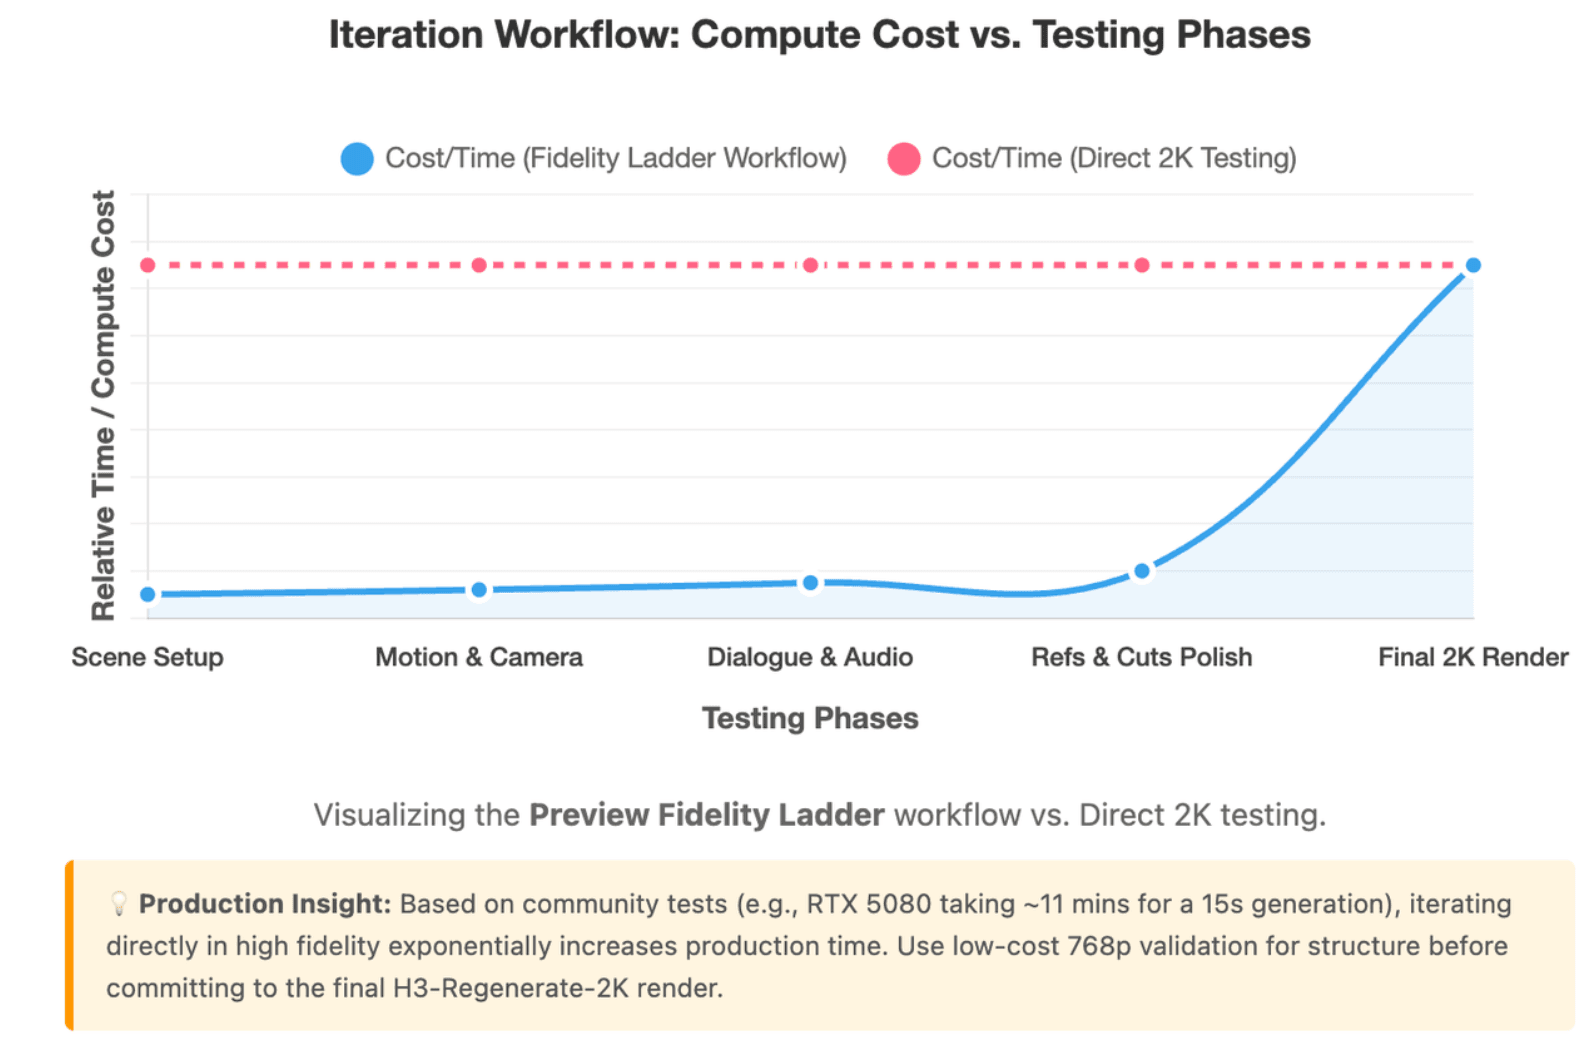
使用预览保真度阶梯
低成本预览非常有用,但前提是针对正确的问题。
早期测试适合检查构图、主要运动、运镜方向、转场和大致时机。它们在评估微小文字、远处的面部、Logo 或精细产品细节时的可靠性较低。
因此,目标不应简单地是“始终先以低分辨率生成”,而是利用更便宜的生成结果来做出结构性决策,然后将计算资源花在只有在高保真度下才可见的细节上。
每次测试一个变量
实用的生产顺序是:首先验证场景,然后验证运动和运镜,接着是对话/音频,再添加额外的参考或转场,最后进行高质量生成。
这一点至关重要,因为 AI 视频的真实成本通常是 生成成本 × 迭代次数。在一次社区测试中,一个 RTX 5080 系统在约 11 分钟内生成了一个 15 秒、0.4MP、10 步的 H3 视频,并且随着视频长度的增加,每步所需时间大幅上升。该用户还报告说需要使用变通方法来避免内存溢出错误。请将此视为单一的现实案例,而非通用基准。
如何在 ComfyUI、API 工作流中使用 MiniMax H3 并修复常见问题?
ComfyUI 目前为**文生视频、图生视频和参考视频**提供官方 H3 模板。其原生节点在文本/帧工作流中使用 FL2VA 系列,在多模态参考中使用 Ref2VA。
MiniMax API 走的是另一条路线:H3 任务是异步的。你提交一个生成、Context-IR 或再生任务,接收一个 task_id,然后查询该任务以获取结果。成功的生成任务通过 content.url 返回视频,而 Context-IR 则通过 content.prompt 返回增强的提示词。
完整的 H3 系统也不应与开源的 H3-Base 权重混淆。MiniMax 描述了三个模块:H3-Context-IR → H3-Base → H3-Regenerate-2K。本地 H3-Base 用于验证 768p 生成,而完整的 2K 工作流则将原始上下文与 768p 结果结合起来进行再生。
在三个层级诊断失败原因
在重写提示词之前,先识别出故障所在的层级。
| 层级 | 典型问题 | 应修改的内容 |
| 提示词 | 错误的动作、时机、运镜或结尾 | 重写时间线 |
| 参考 | 身份、服装、运动或声音偏移 | 澄清或减少参考角色 |
| 渲染 | 微小的文字、远处的面部、精细细节 | 测试更高保真的输出/设置 |
这一区分非常有用,因为并非每个视觉缺陷都是提示词的问题。
MiniMax H3 的常见问题与实用修复方案
如果身份偏移,请简化冲突的参考,并明确定义哪个源控制身份。如果产品或 Logo 发生变化,请明确将必须保留的属性与模型可以重新设计的元素分离开来。
如果视频感觉仓促,请减少动作、转场或对话,而不是添加更多的提示词细节。如果语音听起来被压缩,请缩短对话或给说话者更多时间。
对于首尾帧畸变,请描述中间的物理过渡,而不仅仅是指定两个端点。如果 R2V 参考的影响很小,请说明其确切角色,而不是简单地附加它。
本地用户还应谨慎对待性能调优。ComfyUI 官方文档记载了可选的 Sage Attention,并表示其示例工作流在画质损失极小的情况下,生成速度大约可翻倍;但其他缓存、量化和实验性优化技术可能会带来不同的权衡。
结论
当你将视频生成视为生产工作流而非提示词长度竞赛时,MiniMax H3 会变得更容易控制。选择正确的模式,为每个参考分配具体的职责,在可用时间内合理规划动作与对话,在最终渲染前测试结构性决策,并将故障诊断为提示词、参考或渲染问题。这种方法可以从简单的文生视频剪辑扩展到复杂的多模态设置,这也反映了当今人们制作 AI 视频速度如此之快的原因。