AI视频配音:2026年工作原理与最佳工具解析
AI 视频配音是将视频翻译并替换原始口头对话的自动化过程,它使用目标语言中同步的合成画外音,同时保留发言者的声音特征、语速和情感表达。对于跨国企业和数字教育工作者而言,它彻底消除了传统流程中预定录音棚、挑选配音演员以及手动调整时间轴的痛点。
从教学设计的角度来看,培训和产品团队往往投入大量精力将现有文档转化为视频资产,但在将其推向国际市场进行本地化时,又会遇到新的阻碍。现代的 AI 视频工作流程正在填补这一运营空白:像 Leadde 这样的平台允许团队在几分钟内将 SOP 文档转化为培训视频,并自动将幻灯片转化为基础资产,而集成的 AI 配音功能则有助于在几分钟(而不是几周)内实现面向全球受众的视频本地化。
在本指南中,你将深入了解现代语音合成背后的技术架构,对比适用于企业和教育内容的领先配音平台,并学习如何实施能够大规模保持教学清晰度的自动化本地化工作流程。
AI 视频配音:它是什么?内容团队为什么需要它?
AI 视频配音工具是一个软件平台,它利用人工智能自动转写、翻译并为现有视频资产生成新的画外音。先进的平台利用声音克隆技术来保持发言者原本的语调、节奏和声音特征,确保本地化版本对母语受众而言足够真实自然。
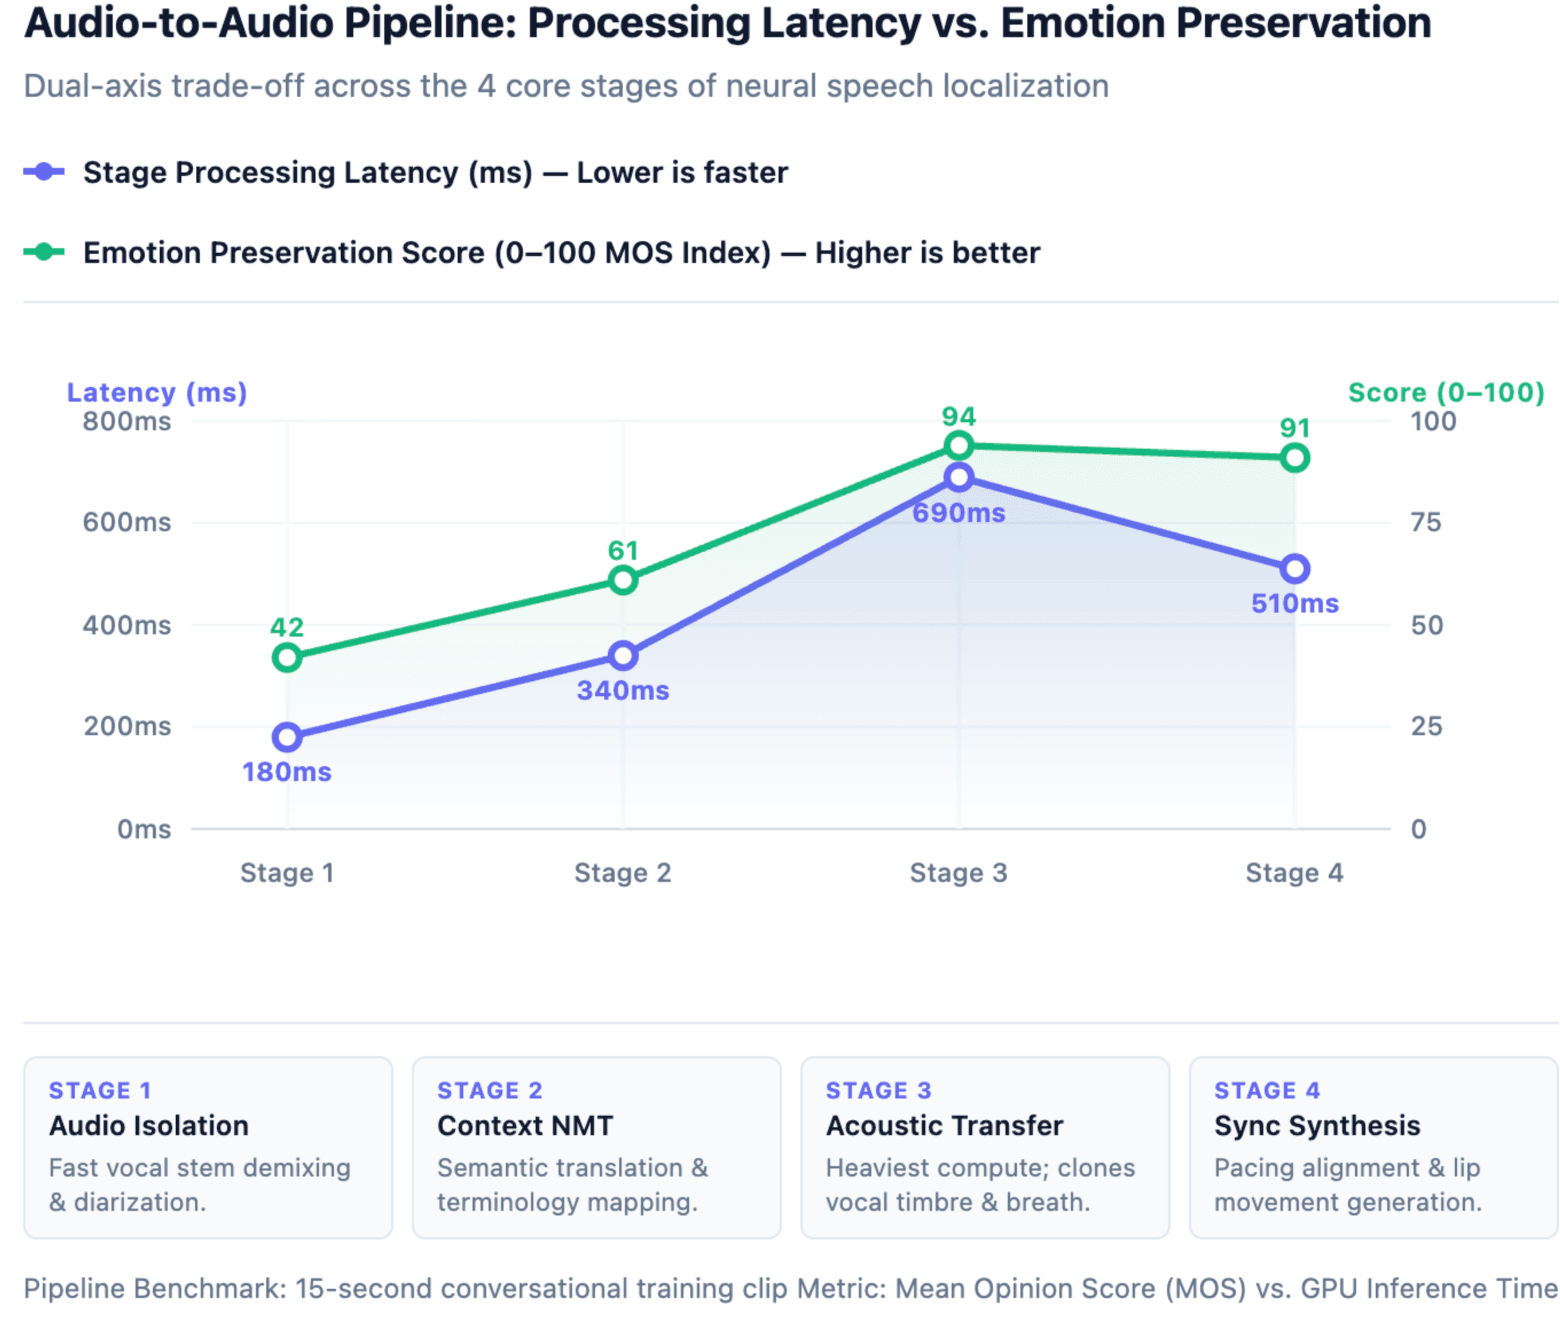
从教学设计的角度来看,传统的本地化周期——转写、翻译、录音和重新剪辑——给全球培训项目的推广造成了巨大的瓶颈。内容团队面临着越来越大的压力,既要在不牺牲教学准确性的同时快速交付本地化媒体,又要兼顾成本。虽然传统方法能确保高度的情感控制,但在扩展现代视频库时,它们在财务和运营上往往难以为继。AI 视频配音则能自动完成这些重复的制作阶段,使企业能够调整视频内容以适应全球市场,并以极低的成本维持品牌的一致性。
AI 视频本地化流程到底是如何运作的?
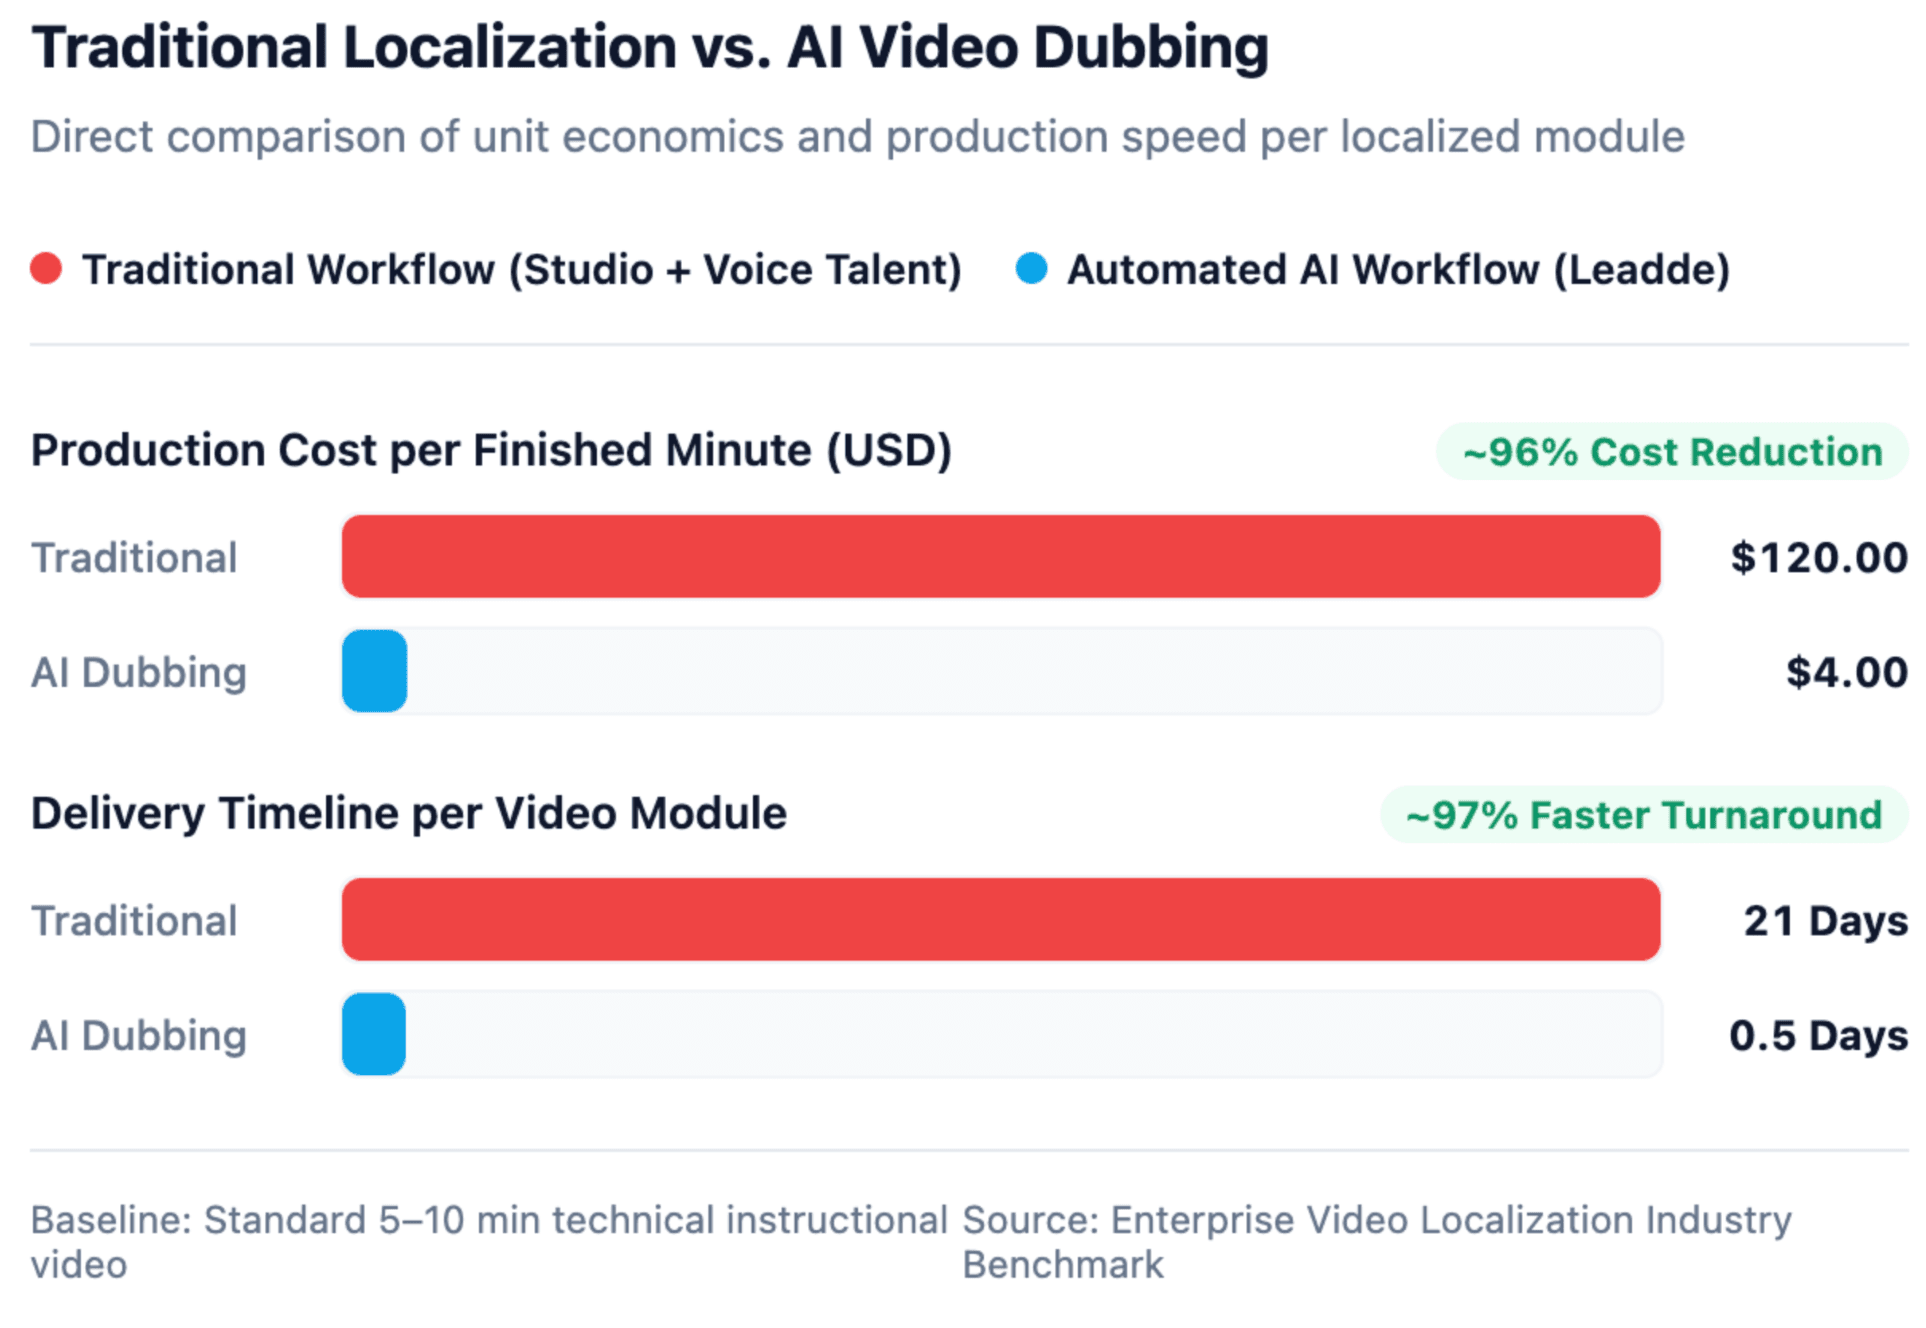
在专业的视频工作流程中,要在不破坏视觉流畅度的前提下无缝替换音频,需要一个同步的技术管道。早期的文本转语音工具听起来很机械,并且经常会覆盖关键的背景音频。而现代的 AI 模型能够隔离人声层,确保背景音乐和环境音完好无损。
语音识别与说话人日志划分
AI 引擎将主要的人声层与背景噪音隔离,准确转写出所说的词语,并识别同一视频中的多个不同发言者(说话人日志划分)。这种最初的文本提取构成了本地化的基础转写文本。
上下文感知本地化
先进的 AI 不会进行死板的字面直译,而是会调整措辞、习语和专业术语,使输出结果对母语受众来说听起来自然流畅。专业平台允许团队对这些文本进行审阅和编辑,以防止教学错误层层叠加,其运作方式就像是企业工作流程中的专属视频翻译器一样。
音频到音频的声音克隆
现代生成式模型不是纯粹从文本转写中生成声音,而是直接根据源音频的表现来调节输出。AI 会捕捉呼吸模式、微停顿和情感语调,在如何制作 AI 声音的现代突破基础之上,将这些声音细微差别映射到翻译后的语言中。
时间与视觉对齐
由于翻译后的句子在不同语言中的长度各不相同——例如,德语翻译通常比英语长——AI 会动态调整生成音频的节奏,使其与原始视频的视觉线索、幻灯片切换以及口型动作相匹配。
适用于创作者和企业的最佳 AI 配音工具是什么?
不同的沟通目标需要不同的本地化策略。教育工作者将静态 PDF 转化为全球合规视频的软件需求,与社交媒体运营者为短视频宣传片配音的需求有着天壤之别。
| 选项 | 最适合 | 优势 | 局限性 |
| Leadde | 教育与培训视频 | 专为“文档转视频”工作流程打造;可将 PDF、SOP 和幻灯片转化为结构化的、覆盖 88 种语言和 175 种方言的本地化培训视频。 | 高度专注于可扩展的企业和教学内容,而非独立社交媒体剪辑。 |
| ElevenLabs | 情感音频本地化 | 行业领先的自然声音克隆和音频到音频情感迁移;支持 90 多种语言和口音。 | 主要是一个以音频为中心的管道;如果需要视觉口型同步,则需要外部工具。 |
| HeyGen | 出镜人视觉本地化 | 针对“数字人”出镜视频的高精度视觉口型同步和强大的自定义 AI 数字人生成功能。 | 高级配音和口型同步功能消耗独立的点数额度;在较长的视频中可能会出现漂移。 |
| Canva (EasyDubbing) | 快速营销视频 | 直接集成在 Canva 编辑器中;为社交媒体内容提供快速的一键翻译和声音克隆。 | 最适合短视频片段;缺乏深度的企业学习管理系统集成。 |
如何实现可扩展的“文档到视频”配音工作流程?
培训团队往往要花费大量时间将文档和演示文稿转换为视频,然后才能开始本地化。对于每一种语言变体都依赖人工重新录音,是一种过时且无法扩展的方法。
从文档生成基础视频
与其从零开始录制真人出镜,不如使用像 Leadde 这样的 AI 视频生成器来导入现有的组织知识,例如学习如何将 PDF 手册转换为培训视频或 Word SOP。该平台会自动将文档构建成逻辑场景,生成教学脚本,并应用初始的 AI 出镜人和画外音。
审阅源转写文本
在启动配音流程之前,内容团队应手动审阅基础转写文本。在源语言中纠正一个听错的专业术语或专有缩写,可以防止该错误在多个目标语言中被放大。
应用克隆声音并大规模本地化
通过配音引擎处理经过批准的基础视频,确保工具保留了 AI 讲师的声音和情感语调。审阅本地化输出,并导出最终视频以及生成的的多语言字幕(SRT 文件),以完全满足无障碍访问合规性,从而帮助分布式团队通过 AI 视频工具实现全球培训同步。
扩展多语言视频时面临的常见挑战是什么?
尽管 AI 视频生成技术正日益普及,但许多创作者和教育工作者在探索人们是如何制作逼真的 AI 视频的同时,也在努力应对保持自然表达和视觉一致性的挑战。了解这些局限性对于构建可扩展的工作流程至关重要。
解决长视频中的口型同步漂移问题
许多 AI 视觉配音工具在处理长镜头时表现不佳,几分钟后往往会导致视觉漂移或音频与口型动作脱节。为了缓解这一问题,专业人员会将长视频拆分为易于管理的片段,或者战略性地使用 B-roll(补充镜头)和演示幻灯片来切离出镜人的面部特写。
管理语言膨胀与认知负荷
当将技术内容从英语翻译成德语或西班牙语等语言时,自然会发生文本膨胀。如果 AI 工具将较长的翻译硬塞进压缩的时间窗口内,语速就会变得极其不自然地仓促,从而显著增加学习者的认知负荷。教学设计师必须将本地化的脚本编辑得更加简练,而不是人为地加快音频播放速度。
处理多说话人日志划分
虽然自动化工具对于快速分发很方便,但在多个人同时说话时,它们往往无法识别或保留不同的声音。对于小组讨论或访谈视频,内容团队必须使用能够进行日志划分的专业 AI 平台,以便同时克隆多个独特的发言者而不合并声音配置文件。
常见问题解答 (FAQ)
AI 配音能保持原发言者的情感吗?
是的。现代 AI 配音系统使用音频到音频建模。AI 不仅是朗读翻译后的文本脚本,还会分析原始音频的情感表达、音高和呼吸模式,并将这些相同的声调变化应用到目标语言中。
如何将培训文档转化为配音视频?
像 Leadde 这样的平台专门从事“文档到视频”的工作流程。用户可以上传现有的 PDF 或演示文稿,学习如何使用 AI 一步步创建多语言视频讲座,将文本转换为带有 AI 画外音的结构化教育视频,然后可以轻松将其翻译并配音成多种语言。
AI 配音能保留背景噪音和音乐吗?
是的。现代 AI 配音工具将主要的人声层与背景音频隔离。它们仅用翻译后的画外音替换口头词语,同时保持原有的音乐、音效和环境噪音完好无损。
为什么 YouTube 的自动配音不足以应对企业培训?
虽然 YouTube 内置的翻译功能对于日常分发很高效,但它往往无法保留发言者的情感语调,在处理多说话人日志划分时力不从心,且不会克隆原始声音,这无法达到企业培训所需的专业质量。
AI 视频本地化对于专有业务数据安全吗?
企业级 AI 视频平台提供强大的数据隐私控制,以确保专有的培训材料和克隆的声音数据不会被用于训练公共 AI 模型。在上传内部文档之前,务必验证平台的企业安全合规性。
AI 视频配音彻底改变了企业处理全球沟通的方式,将历史上昂贵且耗时的本地化周期变成了一个敏捷、自动化的工作流程。通过将智能的“文档到视频”生成与先进的声音克隆和仔细的质量监督相结合,内容团队可以成功地在国际范围内扩展引人入胜的多语言培训库。