如何无需摄像设备制作口播视频(AI数字人工作流)
无需摄像机、专业影棚或出镜主持人,你也可以借助AI 虚拟人打造专业的口播视频,以同步的语音和面部动作生动传递你的内容。
诸如 Leadde 等AI 视频平台让这一工作流更上一层楼,无需人工拍摄,即可利用 AI 主持人将文稿、PDF 转换为视频、将PPT 演示文稿转换为视频。
本指南将深入探讨口播视频的工作原理、优秀示例,以及为教育、培训和营销创作吸引人视频的分步工作流。
什么是口播视频?它是如何运作的?
口播视频是一种真人出镜或由 AI 生成的虚拟人向观众讲话的视频格式,通常采用头像或半身构图。它常用于解释概念、分享专业知识、演示产品以及交付教育或企业培训内容。
与需要实地拍摄的传统口播视频不同,AI 生成的版本使用数字主持人来交付写好的文稿内容。
口播视频的核心特征
大多数口播视频都具备以下几个特征:
- 以主持人为主导的沟通: 可见的演讲者引导观众了解内容。
- 直接互动: 面部表情、眼神交流和声音传达能营造出更具个人特色的体验。
- 灵活的视觉辅助: 幻灯片、动画、屏幕录制和图形可强化核心信息。
- 清晰的叙事结构: 信息围绕特定的沟通目标进行组织。
口播视频的优势与局限性
| 优势 | 局限性 |
| 建立个人连接 | 视觉上可能会显得单调重复 |
| 简化知识传递 | 复杂概念可能需要额外的视觉效果 |
| 适用于多个行业 | 传统制作需要实地拍摄 |
| 支持专家主导的沟通 | 更新已录制的内容可能需要重新拍摄 |
| 适应 AI 视频工作流 | AI 生成的表情可能缺乏自然感 |
当演讲者为所呈现的信息增添背景、公信力或指导时,这种格式能发挥出色的效果。
口播视频对学习有效吗?
一项关于教育视频中讲师存在感的系统性评价发现,学习者通常对可见的讲师持积极态度。然而,仅靠讲师出镜并不能持续改善学习成果。
从教学设计的角度来看,在建立背景或解释核心观点时展示主持人,而在教授复杂概念或流程时优先考虑相关的视觉内容。
PubMed Central (PMC)+1
口播视频有哪些不同类型?(附示例)
根据主持人和辅助信息在屏幕上的呈现方式,口播视频可分为几种不同的格式。
传统口播与采访视频
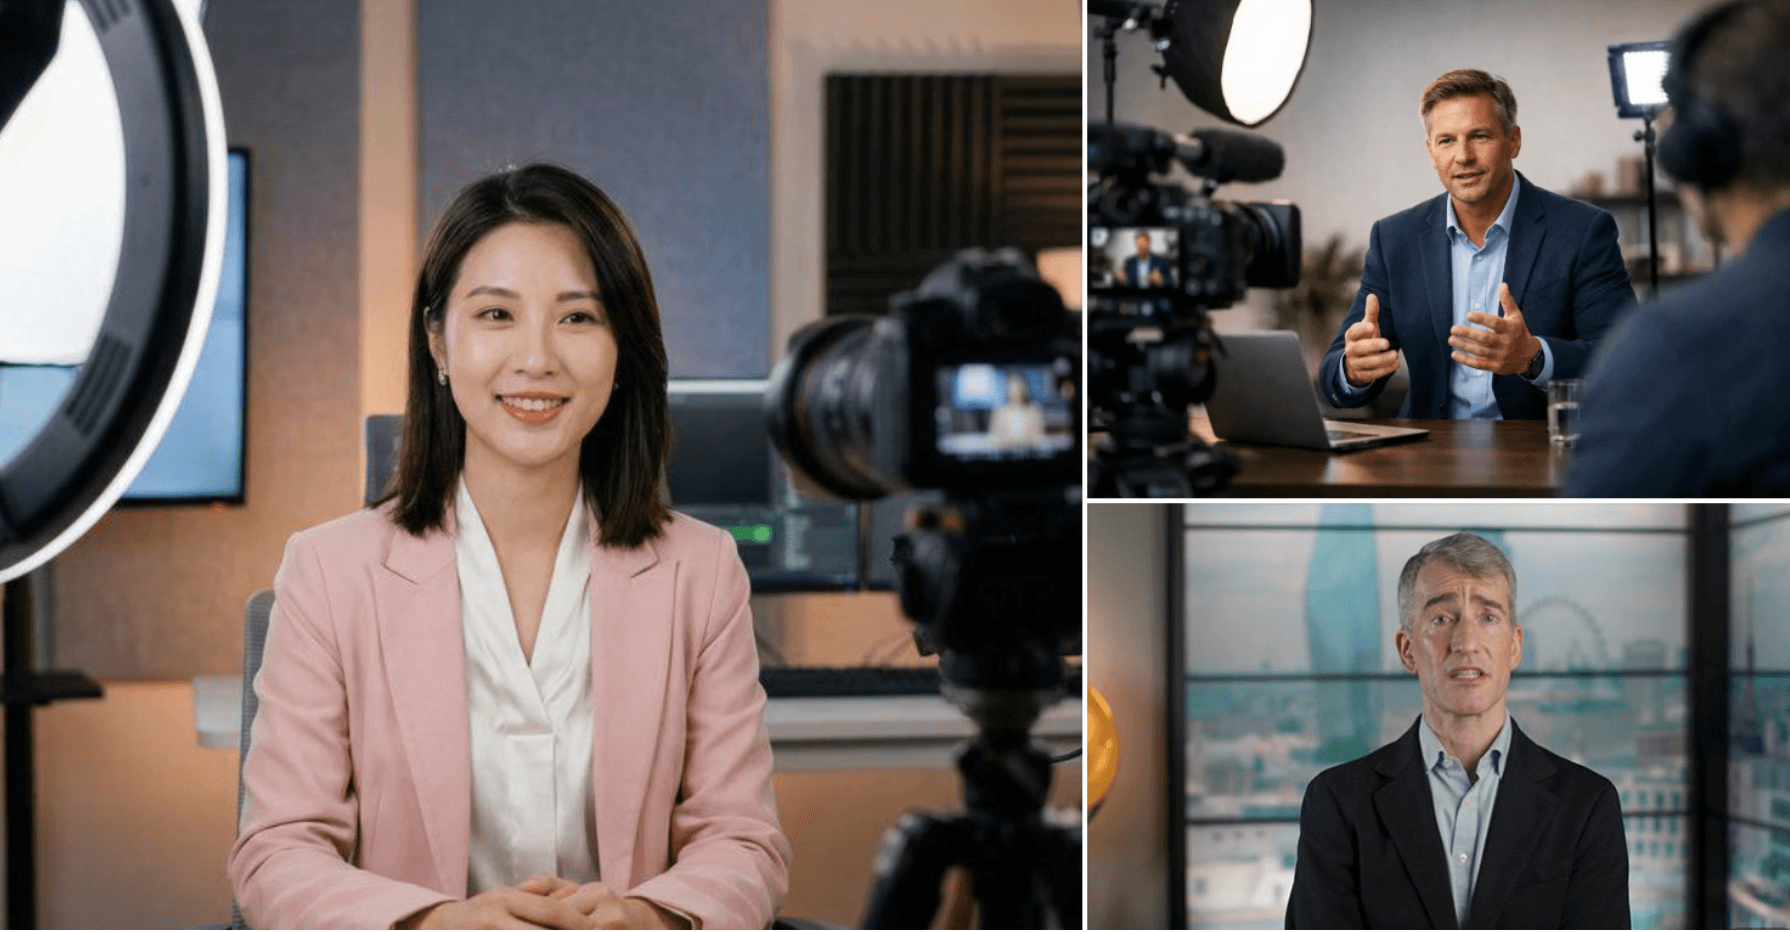
传统的口播视频由真人直接对着镜头讲话或回答采访问题。
常见的例子包括专家访谈、YouTube 评论视频、高管公告以及客户证言视频。当个人公信力和真实的真人经历至关重要时,这种格式尤为有价值。
画中画与屏幕录制视频
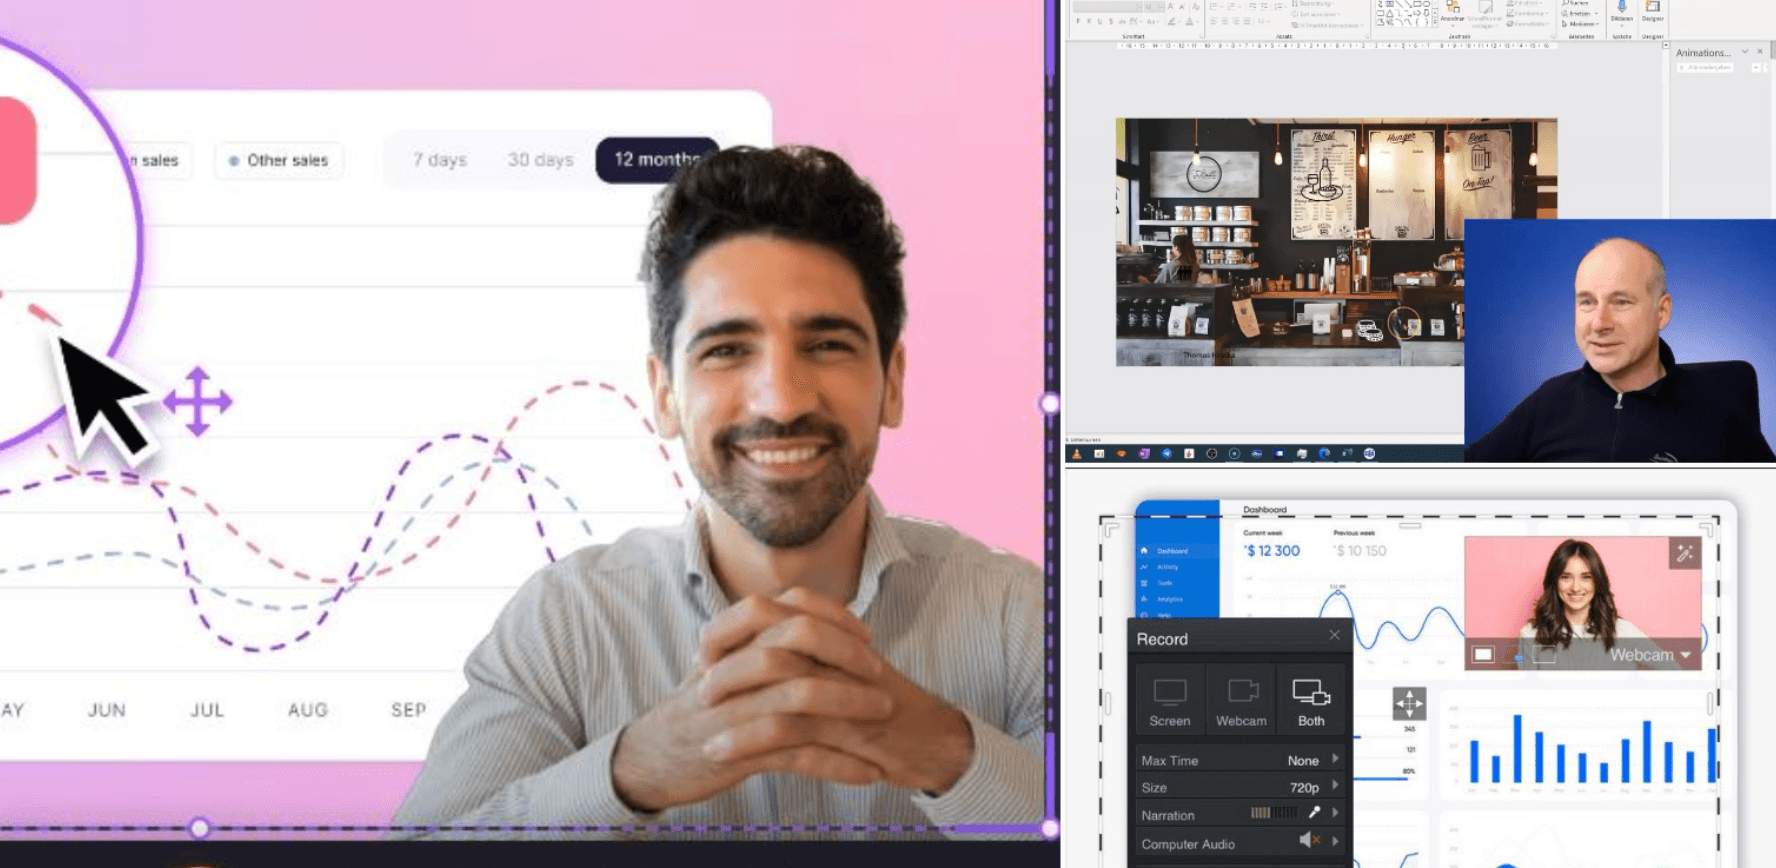
这种格式将主持人与幻灯片、软件演示或屏幕录像结合在一起。绿幕背景还可以帮助将演讲者融入更大的视觉演示中。
例如,HubSpot 使用标题和动画来支持营销教育,而 Slack 则展示了相对简单的由主持人主导的视频如何有效地传达产品信息。
AI 虚拟人口播视频
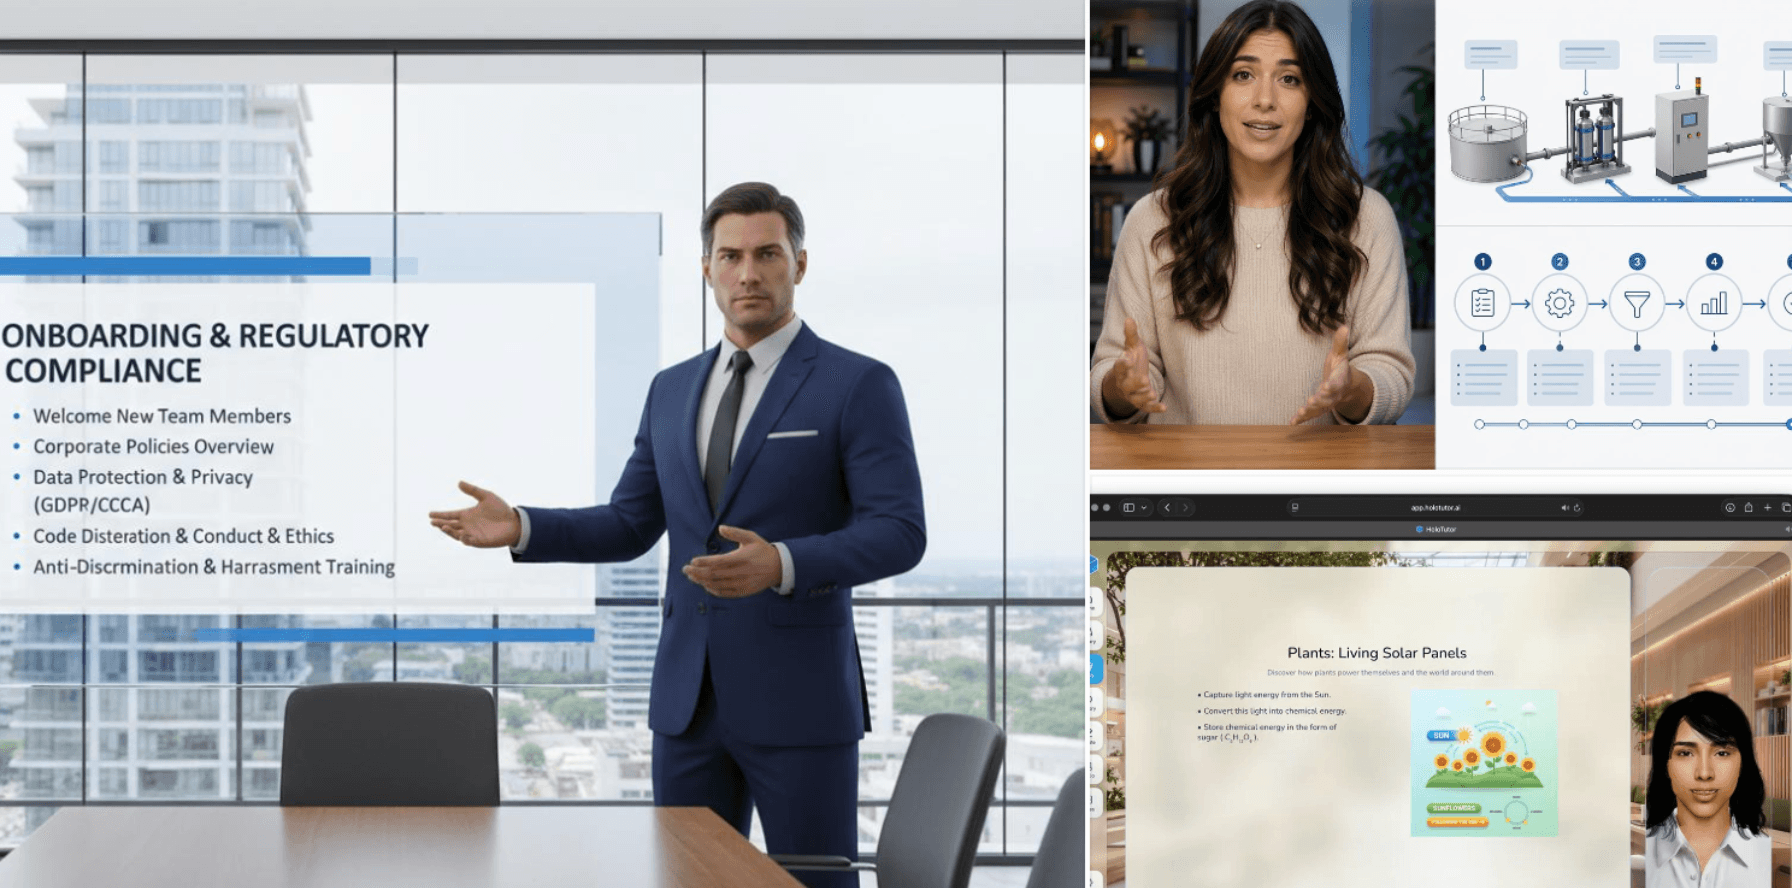
AI 口播视频使用数字生成的虚拟人,而无需真人出现在镜头前。
典型应用包括:
像 Leadde 这样的平台将 AI 虚拟人与结构化内容生成相结合,使这种格式对于将现有知识转化为视频的组织而言尤为实用。
分步指南:如何制作口播视频
无论你是使用摄像机还是 AI 虚拟人,高效的视频制作都始于理解观众需要学习什么。
准备设备与录制设置
对于传统的口播视频,基础设置包括:
| 设备 | 推荐配置 |
| 摄像机 | 智能手机、网络摄像头或数码相机 |
| 麦克风 | 领夹式或 USB 麦克风 |
| 光线 | 自然窗光或柔光照明 |
| 背景 | 干净、无干扰的环境 |
| 提词器 | 可选的文稿播报辅助工具 |
| 剪辑软件 | 视频和音频编辑工具 |
在投资昂贵的设备之前,请优先确保音频清晰、构图稳定且光线充足。
如果你使用 AI 虚拟人,则可以完全跳过实体录制设置。
编写文稿并规划视觉效果
从明确的观众目标切入。不要编写仅专注于旁白的文稿,而应使用双栏视频文稿来同时规划观众所听到的内容和看到的画面。
| 旁白内容 | 屏幕视觉效果 |
| 引入问题 | 主持人出镜 |
| 解释概念 | 图表或插图 |
| 演示解决方案 | 屏幕录像 |
| 总结核心要点 | 带有文字高亮的主持人画面 |
这种方法减少了不必要的剪辑决策,并确保每个视觉元素都支撑核心信息。
录制、剪辑并发布视频
与其一口气录完整篇文稿,不如将其分成易于管理的段落。
这种模块化录制方法可以更轻松地纠正错误、替换过时的信息,并在无需重新制作整个视频的情况下复用单个片段。
发布前,请去除不必要的停顿、提高音频清晰度、添加字幕并验证内容的准确性。
如何让口播视频更具吸引力?
一段引人入胜的口播视频并不一定需要持续的镜头移动或复杂的动画。它需要能够帮助观众理解信息的视觉选择。
善用 B-roll、字幕和视觉叙事
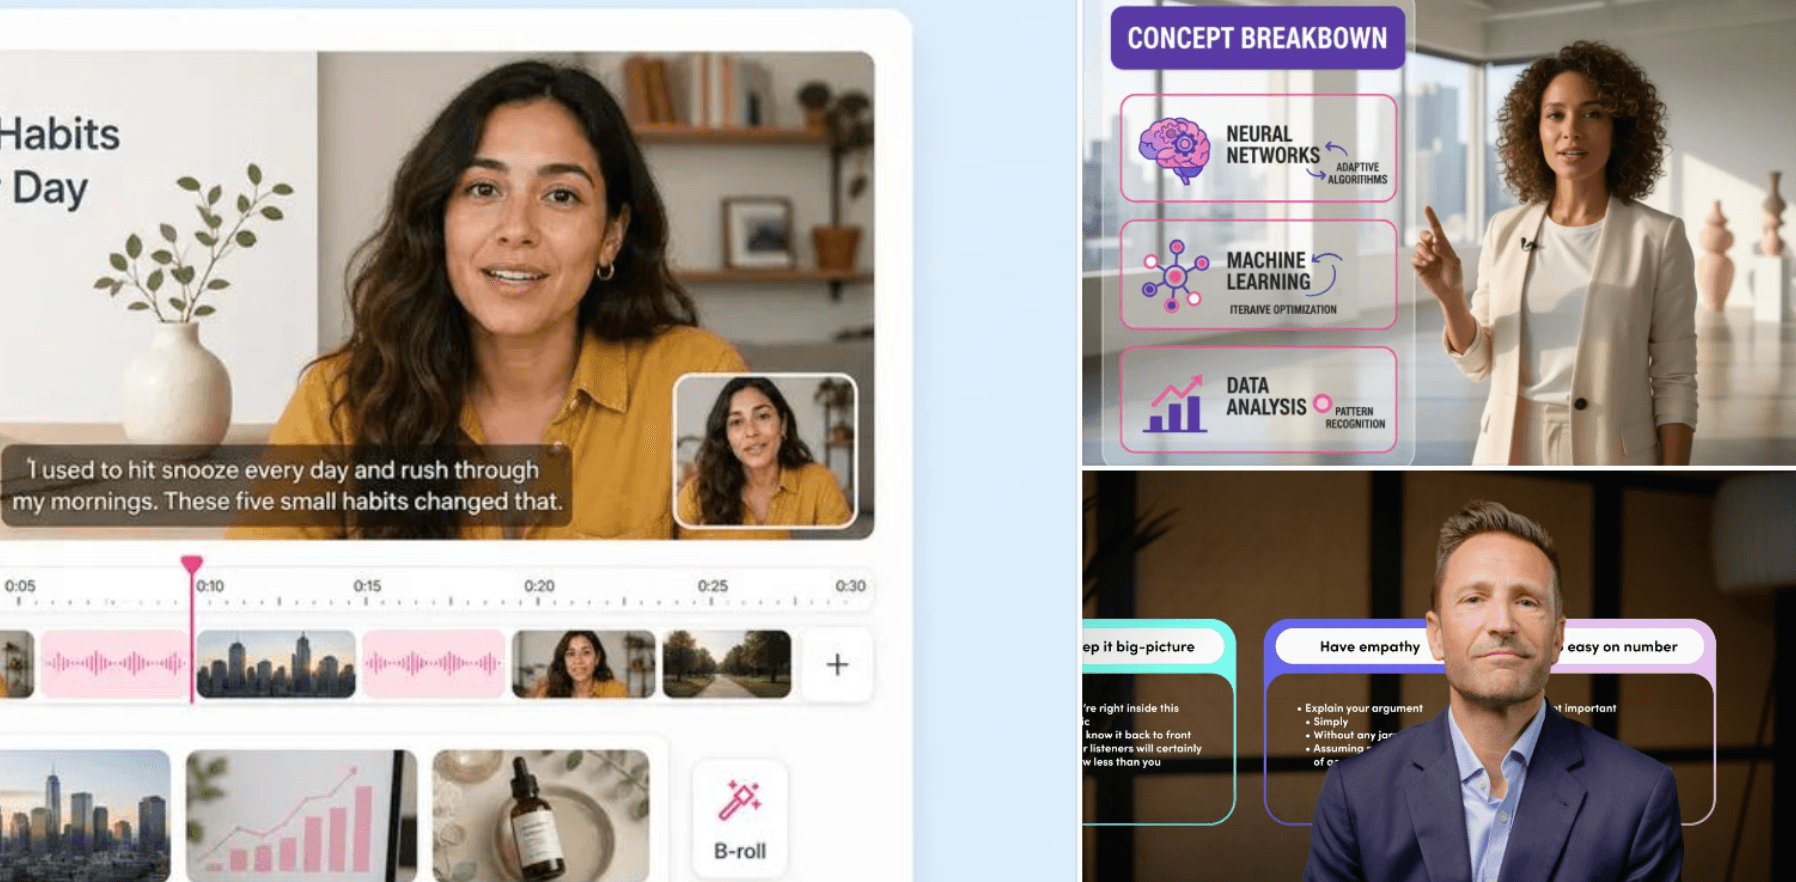
几种技巧可以改善观看体验:
- B-roll: 直观展示演讲者正在描述的内容。
- 字幕: 提高无障碍性并强化口头传达的信息。
- 动态图形: 解释各种关系和抽象概念。
- 镜头角度: 在适当时机引入视觉变化。
- 视觉高亮: 将注意力引导至核心信息。
切忌为了填补空白而盲目添加视觉特效。在教育视频中,过多的运动特效反而会分散学习者需要处理的信息注意力。
什么时候应该展示主持人,而不是 B-roll?
以下主持人与视觉决策框架有助于确定哪种视觉格式能够最好地支持每项沟通目标。
| 沟通目标 | 推荐视觉效果 |
| 建立公信力 | 口播主持人 |
| 解释抽象概念 | 图表或插图 |
| 演示操作流程 | 屏幕录像 |
| 对比信息 | 图表或表格 |
| 强化核心结论 | 带有高亮文字的主持人 |
| 传达个人信息 | 全屏主持人 |
主持人应当引导观众,而不是与内容本身“抢戏”。
在制作培训视频时,这种区别尤为重要——因为理解和知识保留远比单纯的视觉刺激更重要。
如何无需拍摄即可创作 AI 口播视频
AI 口播视频生成器通过将数字主持人、合成语音、面部动画和自动化视频制作融为一体,彻底消除了对传统拍摄的需求。
AI 口播生成器是如何运作的?
大多数 AI 口播生成器都结合使用了以下部分或全部技术:
| 技术 | 功能 |
| 文本转语音 (TTS) | 将书面文稿转换为旁白 |
| 唇形同步 | 将口型与语音对齐 |
| 面部动画 | 生成表情和动作 |
| 头部运动 | 模拟自然的主持人行为 |
| 身份保留 | 保持一致的面部外观 |
微软研究院的 VASA-1 研究表明,在特定的实验条件下,静态肖像和语音音频可以生成高达 40 FPS 的逼真说话面部。
该研究突显了自然的微表情、头部运动以及精准的唇形同步如何共同造就可信度极高的 AI 主持人。
从文本、照片或音频创作口播视频
典型的无相机生产工作流包含五个步骤:
- 选择 AI 虚拟人,或从授权肖像创建会说话的虚拟人。
- 输入你的视频文稿或上传音频。
- 选择声音、语言和视觉呈现风格。
- 生成口播视频。
- 检查发音、面部动作和内容的准确性。
该工作流对于已经准备好文稿的创作者非常有用。然而,企业往往需要从现有文档入手,而不是从写好的旁白开始。
使用 Leadde 将 PDF 或 PPT 转化为口播视频
Leadde 采用“内容至上”的方法来进行 AI 视频创作,能够将文档、演示文稿和培训材料转化为带有 AI 虚拟人的结构化视频。
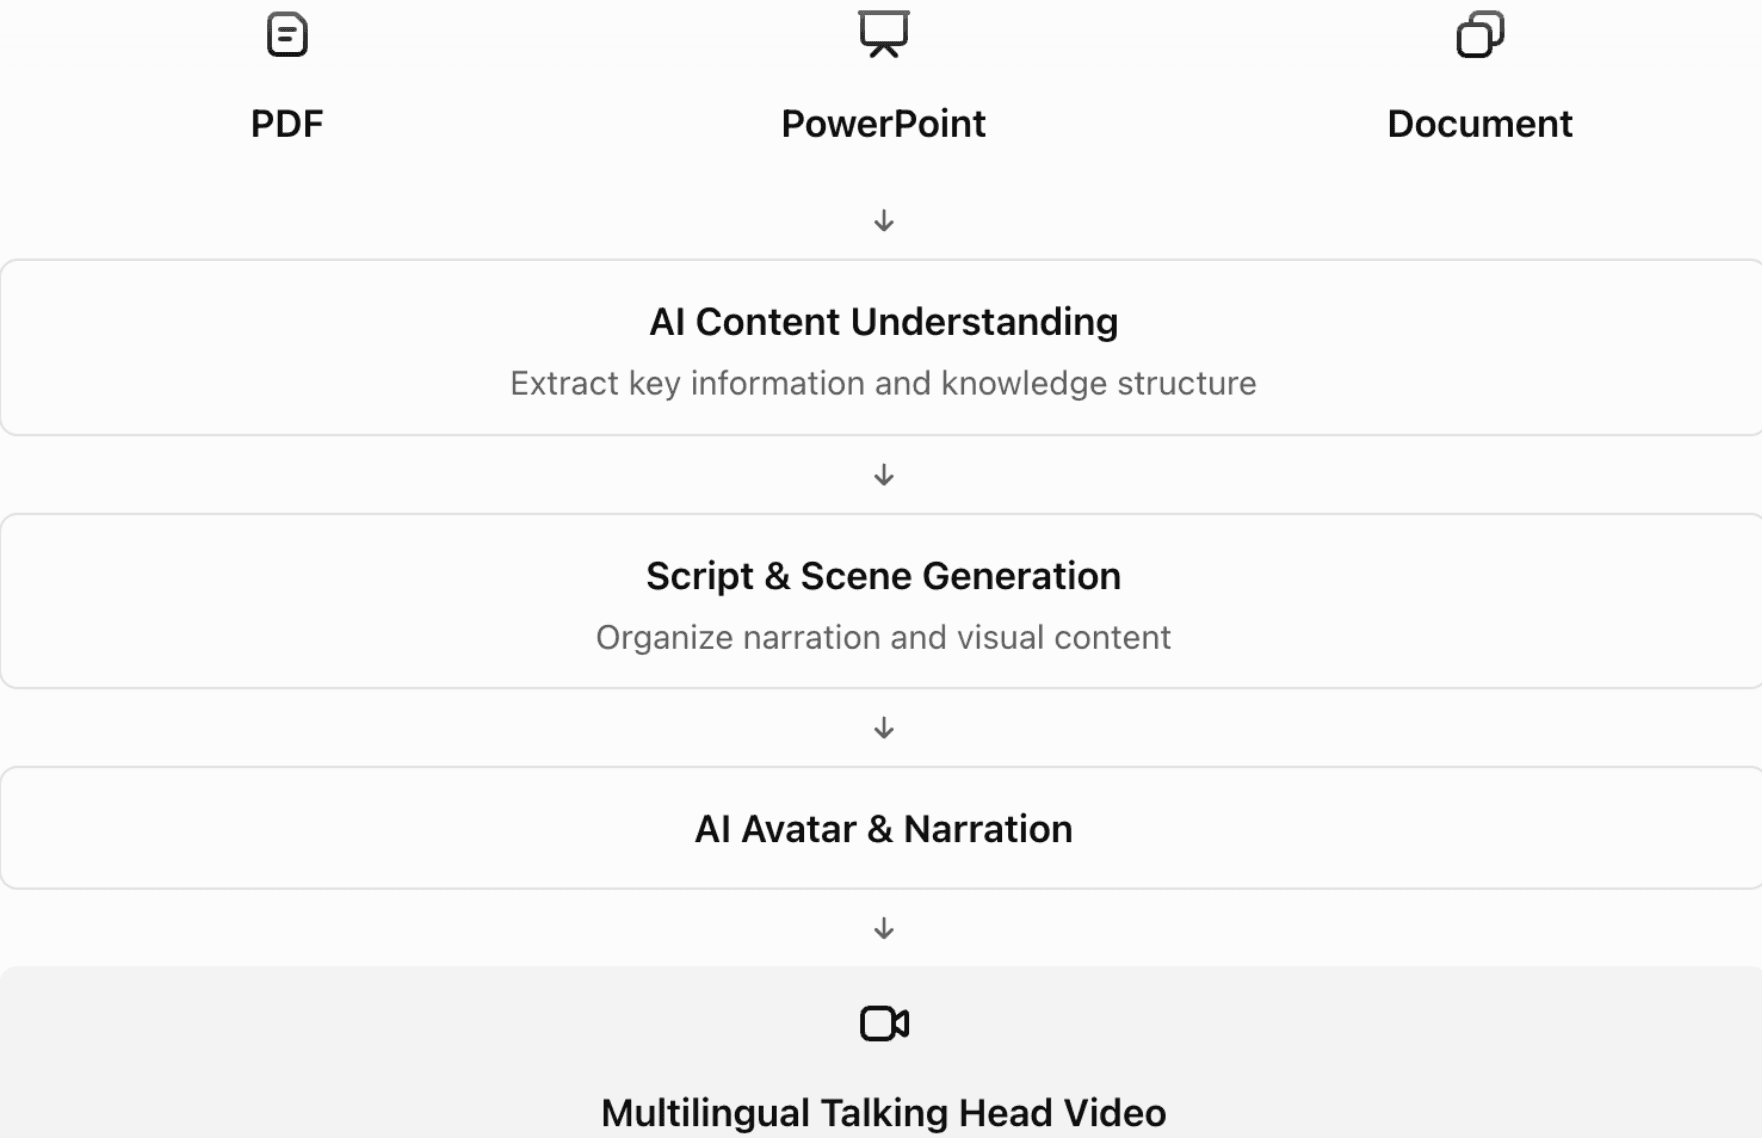
以人力资源团队将员工入职 PDF 转换为培训视频为例。团队无需手动重写文档、预约主持人并录制多个场景,而是可以直接使用 Leadde 从源材料中生成结构化的旁白和 AI 驱动的视觉讲解。
对于经常需要更新培训材料、教育资源和产品文档的组织而言,这种方法尤为实用。
立即尝试 Leadde,无需拍摄即可将现有文档变为 AI 口播视频。
AI 口播视频质量检查清单
在发布 AI 生成的视频之前,请从主持人的逼真度和沟通质量两个维度进行评估。
传统口播 vs. AI 口播视频:你应该选择哪一种?
正确的制作方法取决于你的沟通目标、可用资源以及内容更新的频繁程度。
传统口播与 AI 口播视频对比
| 特性 | 传统口播 | AI 口播 |
| 需要摄像机 | 是 | 否 |
| 真人主持人 | 必需 | 可选 |
| 情感真实度 | 自然的真人表情 | 取决于模型 |
| 制作流程 | 拍摄与剪辑 | AI 生成 |
| 内容更新 | 可能需要重新拍摄 | 可重新生成 |
| 本地化 | 配音或额外拍摄 | AI 辅助 |
| 可扩展性 | 受资源限制 | 具备更强的自动化潜力 |
| 最佳应用场景 | 访谈与客户证言 | 培训与知识视频 |
何时使用真人主持人、AI 虚拟人,或两者结合
当个人经历、情感真实度和个人公信力是信息的核心时,请选择真人主持人。
在制作可重复使用的教育内容、产品教程、员工培训或多语言视频时,选择 AI 虚拟人。
混合方法则可以将两种格式结合起来。例如,公司可以录制一张由首席执行官出镜的个人欢迎致辞,同时使用 AI 虚拟人来交付标准化的入职培训模块。
如何规模化、更新和本地化口播视频
对于管理大型视频库的组织而言,生产效率不仅体现在初创视频的制作上。
可持续的工作流应当能够保存源文档、将文稿组织为可复用的模块、追踪内容版本,并在分发前审查翻译术语。
像 Leadde 这样的文档转视频平台可以通过减少更新源信息与生成修订后视频内容之间的手动工作来支持这一流程。
在使用他人的肖像或声音时,请务必获得相应授权,并在必要时披露 AI 生成的演示说明。
结论
制作精彩的口播视频不再需要摄像机或录音棚。通过将清晰的文稿、有目的的视觉效果和 AI 虚拟人相结合,教育工作者和企业能够在简化内容更新和本地化的同时,产出引人入胜的视频。Leadde 通过将现有文档转化为结构化的多语言口播视频,将这一理念推向了新的高度。
常见问题解答
口播视频应该多长?
理想的长度取决于受众和沟通目标。简短的营销视频可能只需要 30–90 秒,而教育和培训视频则可以持续几分钟。对于复杂的受题,请将内容拆分为更短、更有针对性的学习模块。
我可以用手机制作口播视频吗?
可以。智能手机、稳定的机位、清晰的音频和充足的照明对于许多传统的口播视频来说已经足够了。或者,基于浏览器的 AI 虚拟人生成器允许你在不进行自我录制的情况下创建口播视频。
如何让口播视频不那么枯燥?
善用相关的 B-roll、图表、字幕、屏幕录像以及简洁的旁白。将复杂的想法拆分为易于消化的部分,并在主持人的出现能增添价值时将其展示出来。避免使用会分散观众对主要信息注意力的过度视觉特效。
AI 能从照片中创建逼真的口播视频吗?
可以。音频驱动的面部动画技术可以将静态肖像转化为会说话的数字主持人。不同模型的质量有所不同,特别是在唇形同步、面部表情和头部运动方面。请务必使用你拥有动画授权的图像。
什么是最好的 AI 口播视频生成器?
最好的工具取决于你的需求。对于虚拟人视频,HeyGen 值得评估;对于企业培训内容,Synthesia 是不错的选择;而对于将文档、PDF 和演示文稿转化为结构化教育与培训视频,Leadde 则是不二之选。
我可以制作多种语言的口播视频吗?
可以。AI 视频平台无需单独的拍摄即可生成不同语言的旁白。对于专业应用,翻译后的文稿、专业术语、发音以及文化适宜性应在发布前进行审核。
如何在不重新录制所有内容的情况下更新口播视频?
使用模块化文稿并妥善保存原始源文档。借助 AI 生成的视频,你可以修订过时的信息并重新生成相关内容。像 Leadde 这样的文档转视频平台还可以帮助简化将修订材料转化为更新视频的流程。
编辑说明:Leadde 的工作流程基于其提供的官方产品文档。人力资源示例仅具说明性质,决策框架和质量检查清单属于编辑建议,并非独立测试的产品结果。