MiniMax H3 Prompt Guide: Cómo escribir mejores prompts de video, Ref2VA, cámara, audio y referencia
Un buen prompt para MiniMax H3 debe definir mucho más que el estilo visual. Debe explicar qué sucede a lo largo del tiempo, cómo se mueve la cámara, qué detalles deben mantenerse constantes, qué aporta cada referencia y cómo encajan el diálogo, los efectos de sonido y la música en la secuencia. Para lograr un mayor control, la clave está en elegir el modo H3 adecuado, describir los cambios observables y asignar a cada referencia un rol claro.
Esta guía abarca T2VA, I2VA, FL2VA, L2VA, Ref2VA, el control de cámara, el audio, la consistencia de los personajes y la resolución práctica de problemas. Estos principios también se aplican a los flujos de trabajo de vídeo con IA estructurados como Leadde, donde los documentos, materiales de formación e información de productos se transforman en vídeos escalables con narración, avatares y resultados multilingües.
Guía de prompts para MiniMax H3: ¿Cuál es la mejor estructura de prompt?
La forma más útil de concebir un prompt para MiniMax H3 es como un guion de producción audiovisual. En lugar de acumular palabras como «cinematográfico», «realista» y «dramático», describe lo que el espectador puede ver y oír realmente a medida que avanza el clip para comprender cómo hacer vídeos con IA realistas.
La fórmula sencilla de prompts para H3
Para escribir prompts del día a día, empieza con:
Sujeto + Acción + Entorno + Cámara + Sincronización + Audio
Por ejemplo, «una mujer en una estación de tren lluviosa» establece una escena, pero aporta poca información temporal. Un prompt más sólido explica que ella camina hacia el andén, se detiene al oír un tren que se acerca, se gira hacia el sonido y es seguida por una cámara de seguimiento lenta.
La guía oficial de prompts base de MiniMax formaliza esta idea con tres campos: integrated_multimodal_description, overall_soundscape y non_diegetic_music. El primero contiene la línea de tiempo visual, las acciones, los planos, los oradores, los diálogos y el audio sincronizado de la escena; los otros dos separan el sonido ambiental/físico de la música de fondo destinada exclusivamente a la audiencia.
Escribe resultados observables, no solo adjetivos
Una regla útil es convertir las intenciones abstractas en comportamientos visibles.
En lugar de «parece segura de sí misma», describe cómo camina con firmeza, mantiene el contacto visual, se alisa la chaqueta y se detiene sin vacilar.
Este mismo enfoque ayuda con las restricciones. En lugar de repetir «no hagas zoom», describe el resultado deseado: «el sujeto mantiene aproximadamente el mismo tamaño en el fotograma de principio a fin». Una prueba de consistencia de H3 de la comunidad indicó que las restricciones de encuadre cuantificables funcionaban mejor en ese flujo de trabajo específico que repetir una instrucción de cámara negativa. Se trata de una observación empírica del flujo de trabajo, no de una garantía oficial de MiniMax.
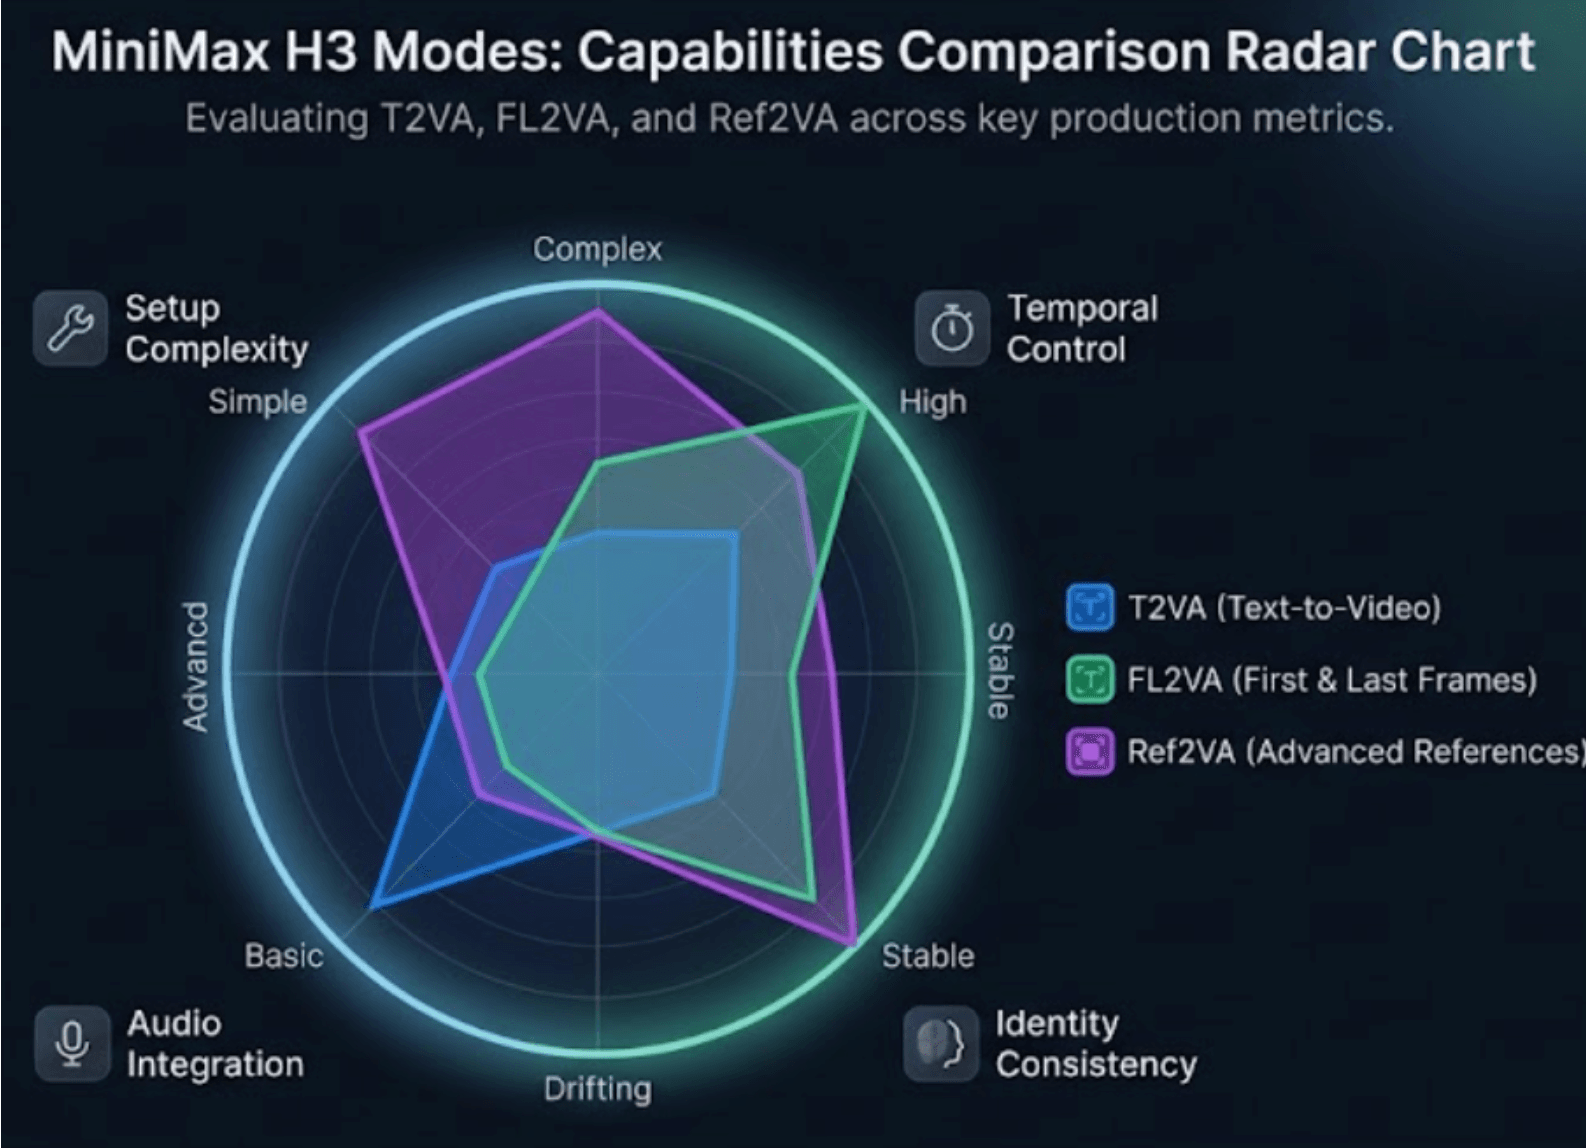
¿Qué modo de MiniMax H3 debes utilizar?
Elegir el modo correcto puede ser tan importante como reescribir el prompt. El flujo de trabajo Base de MiniMax admite la generación solo por texto, además de tareas de primer fotograma, último fotograma y primer y último fotograma, mientras que su punto de control Ref2VA independiente se encarga de la generación de referencias multimodales.
| Modo | Entrada | Mejor objetivo para el prompt |
| T2VA | Texto | Construir toda la escena audiovisual |
| I2VA | Primer fotograma | Conservar el inicio y desarrollar hacia adelante |
| FL2VA | Primer + último fotograma | Describir la transición entre los puntos finales |
| L2VA | Último fotograma | Construir la escena hacia el final proporcionado |
| Ref2VA | Imágenes/vídeo/audio | Combinar diferentes roles de referencia |
T2VA, I2VA, FL2VA y L2VA
El modo T2VA debe establecer la escena desde cero. I2VA trata la imagen proporcionada como el primer fotograma real, por lo que el prompt debe preservar la identidad, la ropa, los objetos, los colores y la composición antes de introducir el movimiento.
Con FL2VA, el prompt no debe limitarse a describir la Imagen 1 y la Imagen 2. MiniMax recomienda específicamente describir la ruta observable entre ambas: cómo se mueve el sujeto, cómo cambian las posturas, cómo se manipulan los objetos y cómo la composición o la iluminación convergen en el fotograma final. L2VA invierte el proceso de razonamiento al partir de un estado anterior verosímil para desembocar gradualmente en el último fotograma proporcionado.
¿Cuándo debes usar Ref2VA?
Utiliza Ref2VA cuando diferentes recursos cumplan funciones distintas; por ejemplo, una imagen define a un personaje, otra define la ropa, un vídeo aporta el movimiento al caminar y el ritmo de la cámara, y el audio aporta una referencia de voz.
Esto se entiende mejor como una generación basada en relaciones. El modelo necesita saber no solo qué contiene cada archivo, sino cómo la información de cada fuente debe influir en el vídeo final. El formato de referencia completa de MiniMax distingue explícitamente entre sujetos reutilizables, anclajes pictóricos concretos, fuentes temporales a nivel de vídeo y referencias de audio.
Usa el modo más sencillo que pueda resolver el plano
Una regla práctica de producción es: no añadas complejidad de referencias a menos que el plano lo requiera.
Si una transición solo necesita un inicio y un final precisos, FL2VA define la tarea de forma directa. Pásate a Ref2VA cuando necesites de verdad relaciones como identidad de la Imagen 1 + movimiento del Vídeo 1 + voz del Audio 1.
Esto también facilita la depuración de errores. Cuando hay menos restricciones independientes compitiendo entre sí, resulta más fácil identificar si el problema proviene del movimiento, la identidad, el encuadre o el audio.
¿Cómo se controlan los planos, el movimiento de cámara, la sincronización y las transiciones?
Los prompts de H3 resultan más fáciles de controlar cuando la línea de tiempo se trata como un montaje en lugar de como un párrafo.
Cortes de plano, marcas de tiempo y presupuesto temporal
El formato oficial de MiniMax no incluye marcas de tiempo como [Shot 1]. Los planos posteriores comienzan con tiempos de corte incrementales, por ejemplo, [Shot 2] At 00:03.500. Un plano nuevo debe introducir información nueva y relevante, como un punto de vista, ubicación, estado, sujeto o momento temporal diferentes. Un cambio pequeño de distancia o ángulo suele expresarse mejor como un movimiento de cámara que como un nuevo corte.
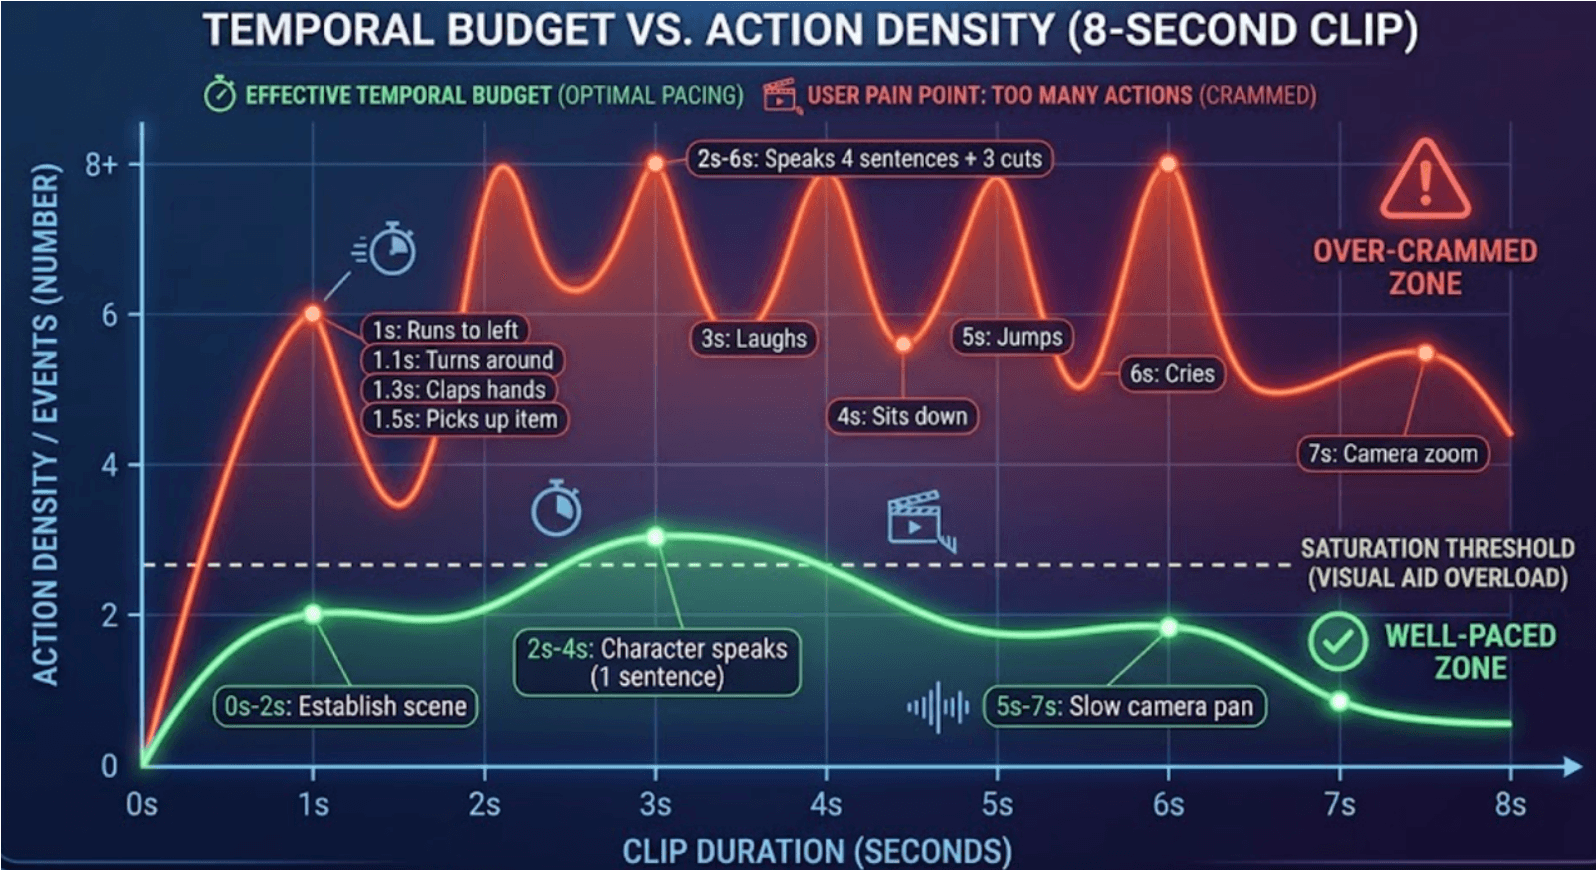
Esto genera un presupuesto temporal práctico. En un clip de 8 segundos, tres acciones, dos movimientos de cámara, una reacción, una frase hablada y dos cortes compiten por la misma y limitada duración. Cuando una generación se siente apresurada, eliminar eventos suele funcionar mejor que añadir más lenguaje descriptivo.
Lenguaje de cámara compatible con H3
MiniMax documenta operaciones de cámara que incluyen acercamiento/alejamiento (push/pull), paneo (pan), desplazamiento lateral (truck), inclinación (tilt), pedestal (pedestal), arco (arc), travelling (tracking), planos estáticos, subjetiva (POV), giro (roll) y movimiento de cámara (camera shake). Su lógica recomendada es básicamente:
Tipo de movimiento + amplitud opcional + velocidad opcional
Así que, en lugar de «cámara cinematográfica dinámica», escribe algo práctico como «la cámara se desplaza lentamente hacia la derecha mientras mantiene el producto centrado».
Separa lo que debe permanecer fijo de lo que puede cambiar
Antes de generar, haz un sencillo mapa mental de elementos fijos frente a variables.
Un vídeo de producto puede requerir que la forma de la botella, el texto de la etiqueta, el tapón y el color permanezcan fijos mientras cambian la posición de la cámara, los reflejos, el movimiento del agua y la iluminación. Una secuencia de personajes puede fijar la cara, el peinado y el conjunto de ropa, permitiendo al mismo tiempo que la postura y la expresión evolucionen.
Esto reduce las instrucciones contradictorias, ya que el prompt deja de exigir que todas las propiedades visuales cambien al mismo tiempo.
¿Cómo se utilizan las referencias sin perder la consistencia del personaje o del producto?
Los flujos de trabajo con referencias más sólidos asignan a cada recurso un propósito específico.
Asigna a cada referencia una única función clara
Una asignación práctica podría ser:
Imagen 1 → identidad del personaje Imagen 2 → ropa Imagen 3 → diseño del producto Vídeo 1 → movimiento al caminar y trayectoria de cámara Audio 1 → timbre de voz
El formato Ref2VA oficial de MiniMax admite exactamente este tipo de definición entre múltiples fuentes: un sujeto puede obtener su apariencia de una imagen y su movimiento de un vídeo, mientras que un solo archivo de referencia también puede proporcionar varios sujetos reutilizables.
Lo importante es evitar transferencias accidentales. Si el Vídeo 1 debe proporcionar el movimiento pero no su actor ni su entorno, indícalo explícitamente en el diseño de las relaciones.
Sujetos, imágenes, guiones gráficos y vídeos de referencia
En la terminología oficial, <Subject N> representa contenido visible reutilizable, mientras que <Picture N> se utiliza cuando una imagen sirve por sí misma como fotograma concreto, anclaje de composición o referencia de guion de vídeo y storyboard. <Video N> representa relaciones a nivel de vídeo como el montaje, la continuación, el movimiento de cámara, los cortes, el ritmo o la estructura temporal. <Audio N> gestiona la copia de audio o características como el timbre de voz, la dicción, el ritmo o el estilo musical.
Esta distinción evita un error conceptual común: una referencia de personaje no es automáticamente un fotograma clave, y un guion gráfico no es automáticamente un punto final exacto.
Economía de referencias y consistencia a nivel de plano
Tener más material de referencia no significa automáticamente aportar más información. En los flujos de trabajo de producción, recorta el vídeo de referencia para dejar solo la parte que muestre claramente el movimiento, la trayectoria de cámara o la calidad vocal que necesitas.
Evalúa también la identidad a lo largo de todo el plano y no solo en el primer fotograma. Una prueba de la comunidad descubrió una deriva de identidad sustancialmente más temprana en los primeros planos que en encuadres con rostros más pequeños bajo la configuración local específica de ese usuario. Los tiempos exactos no deben generalizarse, pero la lección para el flujo de trabajo es útil: comprueba la identidad del rostro, la ropa y los accesorios pequeños en varios puntos de cada plano importante.
¿Cómo funcionan el Ref2VA avanzado, los diálogos y los prompts de audio?
Ref2VA es el punto en el que el uso de prompts en H3 se parece más a la planificación de una producción multimodal que a los prompts convencionales de texto a vídeo.
La estructura de 6 partes para prompts de Ref2VA
La guía de referencia completa de MiniMax define seis secciones:
subject_definitions → summary → retention_analysis → detailed_description → overall_soundscape → non_diegetic_music.
El sistema define primero qué significan las referencias, luego resume la tarea, explica cómo se conserva o transfiere cada referencia y, finalmente, redacta el vídeo de destino en orden de reproducción.
Una capa de planificación útil antes de redactar el prompt formal es:
| Fuente | Conservar | Transferir | Ignorar |
| Imagen 1 | Rostro, cabello | — | Fondo |
| Vídeo 1 | — | Caminata, cámara | Identidad del actor |
| Audio 1 | Timbre de voz | Dicción | Diálogo original |
Esto convierte una solicitud ambigua como «usa todas estas referencias» en relaciones explícitas de origen a destino.
Diálogo, voz, efectos de sonido y música
Los personajes que hablan utilizan identificadores estables como (S1) y (S2), mientras que el diálogo se coloca dentro de <d>[Language] ...</d>. MiniMax también distingue entre el diálogo en pantalla y la locución fuera de campo, y recomienda mantener explícitamente cerrados los labios de un personaje en pantalla cuando este solo ejerce de narrador.
Los sonidos ambientales y los efectos físicos pertenecen al paisaje sonoro (soundscape), mientras que non_diegetic_music se reserva para la música que escucha la audiencia en lugar de los personajes. Si quieres pasos, lluvia y sonidos de objetos pero sin música de fondo, mantén el paisaje sonoro y configura non_diegetic_music: N/A.
Prompt en lenguaje natural frente a prompt estructurado oficial
Las instrucciones cortas en lenguaje natural siguen funcionando en el sistema alojado H3 porque MiniMax utiliza H3-Context-IR, una capa de preprocesamiento que interpreta las relaciones entre texto, imágenes, vídeo y audio antes de generar una representación estructurada para H3-Base. La ficha del modelo abierto describe el análisis sintáctico de instrucciones, la asociación multimodal, la comprensión temporal y el razonamiento lógico como parte de dicho proceso.
Esto explica una aparente contradicción: los prompts sencillos pueden ser adecuados para generaciones alojadas directas, mientras que los prompts estructurados ganan valor para tareas de producción precisas con múltiples referencias, diálogos, tiempos y resultados repetibles.
¿Por qué MiniMax H3 ignora los prompts y cuál es el mejor flujo de trabajo de pruebas?
Cuando una generación falla, reescribirlo todo de golpe dificulta la identificación de la causa.
Problemas habituales con los prompts de H3 y sus soluciones
| Problema | Causa probable | Primera prueba a realizar |
| Habla la persona equivocada | Asignación de oradores poco clara | Fijar (S1)/(S2) |
| El personaje cambia | Señales de identidad contradictorias | Simplificar referencias |
| Se ignora la referencia | El rol es ambiguo | Asignar una única función |
| Cortes aleatorios | Demasiadas instrucciones de plano | Usar movimiento de cámara |
| Se ignora la marca de tiempo | Se usó como temporización de acción | Reservarla para los cortes |
| Saltos en FL2VA | Falta la ruta de transición | Describir los cambios intermedios |
| El final no coincide | Convergencia débil | Fijar la composición final |
| Música no deseada | Capas de audio mezcladas | Configurar la música explícitamente |
| Cambios de texto | Texto exacto no preservado | Citar el texto visible exacto |
| El vídeo se siente apresurado | Demasiados eventos | Reducir los compases |
Un principio útil es realizar una comparativa controlada cuando two modos pueden resolver la misma tarea, en lugar de asumir que el modo más complejo producirá siempre el mejor clip.
Un flujo de trabajo de pruebas práctico para H3 paso a paso
Empieza definiendo el criterio de aceptación para la generación: tal vez la identidad del personaje sea lo más importante, o quizás la etiqueta del producto, la transición final, la asignación del diálogo o el movimiento de cámara sean innegociables.
A continuación, haz pruebas por capas: establece primero el personaje y la escena; añade después el movimiento y la cámara; incorpora la voz y el sonido una vez que el comportamiento visual sea estable; introduce cortes adicionales, guiones gráficos o más personajes solo cuando la versión más sencilla funcione. La regeneración a alta resolución debe realizarse después de que el resultado semántico sea correcto, ya que una mayor resolución no puede resolver relaciones de referencia contradictorias.
Este enfoque por fases resulta especialmente útil en las tuberías de vídeo escalables. Para flujos de trabajo que convierten conocimientos repetibles o contenido empresarial en vídeo, incluidas las herramientas de formación de documentos a vídeo como Leadde, separar la estructura del contenido, el comportamiento visual, la narración por IA y el renderizado final facilita aislar las revisiones en lugar de tener que reconstruir toda la producción cada vez.
Guarda los planos exitosos en lieu de regenerarlo todo
En proyectos más largos, trata cada clip exitoso como un recurso de producción validado. Si el Plano 1 y el Plano 2 funcionan pero el Plano 3 falla, regenera la sección fallida en lugar de descartar todo el trabajo anterior.
Los flujos de trabajo de la comunidad para H3 ya utilizan planos guardados en puntos de control por este motivo: una vez guardada una sección exitosa, los experimentos posteriores se pueden volver a ejecutar sin pagar repetidamente el coste computacional y creativo de recrear el material previo.
Esto conduce a un principio de producción más amplio:
Generar → validar → guardar → continuar.
En el vídeo con IA, la ingeniería de prompts termina convirtiéndose en ingeniería de flujos de trabajo.
Conclusión
El uso de prompts en MiniMax H3 funciona mejor cuando la tarea está estructurada con claridad en lugar de limitarse a describirse con más palabras. Elige el modo más sencillo que se adapte al plano, describe los cambios observables, separa los atributos fijos de los variables, asigna a cada referencia un rol específico y depura los errores capa por capa. Para flujos de trabajo avanzados con Ref2VA, la verdadera ventaja proviene de hacer explícitas las relaciones entre personajes, movimiento, cámara, audio y fotogramas clave para, a continuación, convertir las generaciones exitosas en bloques de construcción reutilizables para el siguiente plano.