Domina MiniMax H3: Guía completa de prompts, referencias, audio y ComfyUI
MiniMax H3 se aprovecha al máximo eligiendo primero el modo de generación adecuado y decidiendo después qué elementos controlarán el texto, los fotogramas, las referencias, el movimiento y el audio. Puedes generar a partir de texto, fijar el primer o el último fotograma, o utilizar imágenes, vídeos y audios para guiar la identidad, el movimiento, el comportamiento de la cámara y la voz.
Como H3 combina referencias multimodales con la generación audiovisual nativa, los mejores resultados suelen provenir de un control claro en lugar de prompts más largos. Esta guía explica cómo elegir el flujo de trabajo adecuado, escribir mejores prompts, usar referencias, gestionar los diálogos y el sonido, probar de forma eficiente y trabajar con ComfyUI o la API.
Si tu punto de partida es un PDF, una presentación, un SOP o un documento de formación en lugar de un prompt creativo, Leadde puede ser una mejor opción para convertir contenido estructurado de origen en un flujo de trabajo de vídeo antes o en lugar de dirigir manualmente cada escena en H3.
Cómo usar MiniMax H3: ¿Con qué flujo de trabajo deberías empezar?
La forma más rápida de usar MiniMax H3 es elegir el modo de generación antes de escribir el prompt. H3 admite texto, entradas de primer/último fotograma y referencias multimodales, pero cada entrada cumple una función diferente. La tarjeta de modelo oficial de MiniMax separa sus pesos abiertos en FL2VA para la generación basada en texto y fotogramas, y Ref2VA para la generación guiada por referencias con imágenes, vídeos o audios.
| Modo | Ideal para | Qué controla el vídeo |
| T2VA | Crear una escena desde cero | Prompt de texto |
| I2VA | Empezar a partir de una imagen exacta | Primer fotograma + prompt |
| L2VA | Llegar a un final específico | Último fotograma + prompt |
| FL2VA | Controlar tanto el inicio como el final | Primer y último fotograma |
| Ref2VA | Preservar identidad, movimiento, cámara, estilo o voz | Referencias multimodales + prompt |
¿Tu imagen es un fotograma o una referencia?
Esta distinción resuelve muchos problemas de control.
Un fotograma es un anclaje temporal. Si una imagen de producto cargada debe ser literalmente la primera que vean los espectadores, utilízala como primer fotograma.
Una referencia es información reutilizable. Si solo necesitas que el diseño del producto, el rostro del personaje, el conjunto o el estilo visual se mantengan coherentes mientras creas una nueva composición, trátala como una referencia.
La guía oficial de prompts de MiniMax hace explícita esta distinción: I2VA comienza a partir de la imagen proporcionada en el segundo 0,00, mientras que el modo de referencia completa rastrea por separado los sujetos, las imágenes, los vídeos y el audio según el papel que desempeña cada recurso.
La pila de control de H3
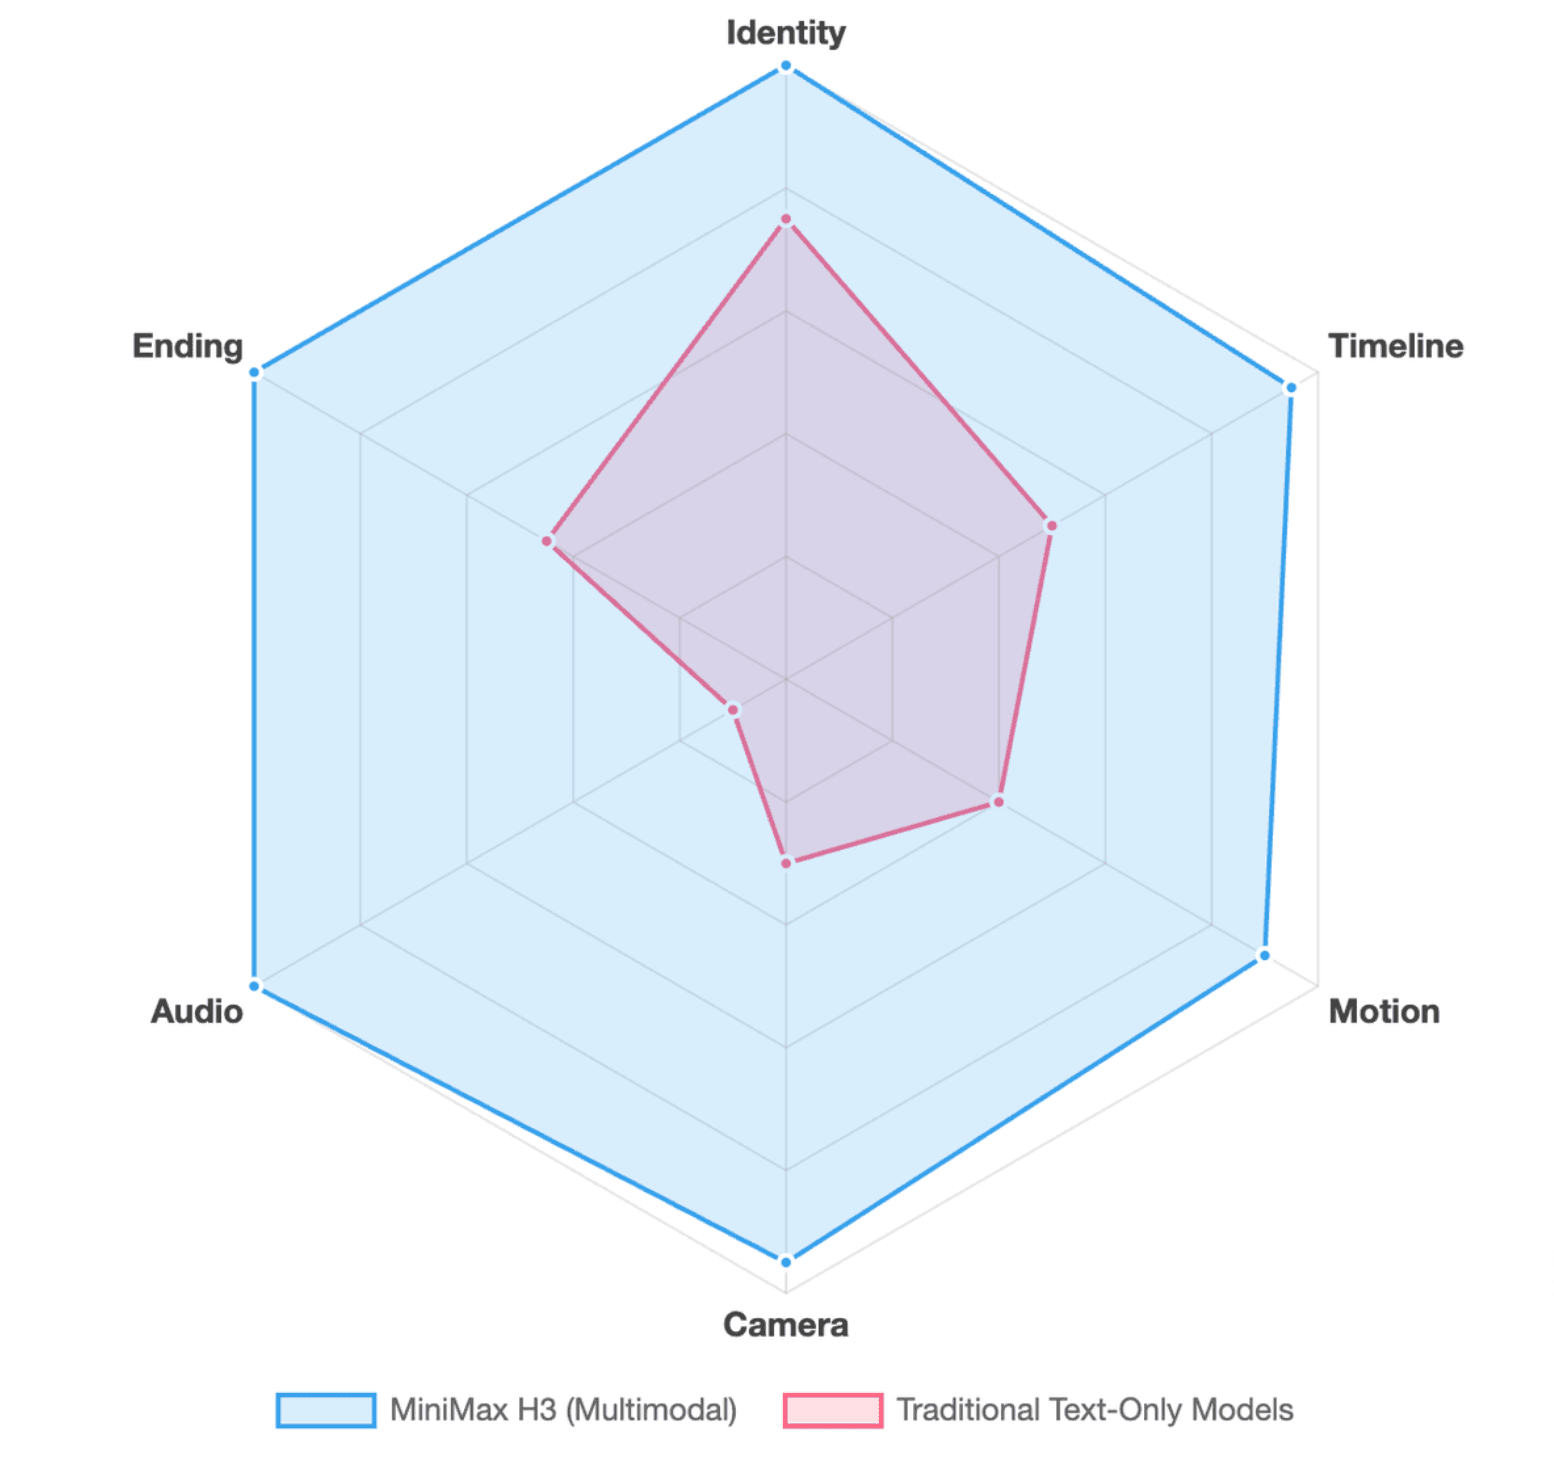
Antes de redactar el prompt, decide qué controlará seis partes del vídeo: identidad, línea de tiempo, movimiento, cámara, audio y final.
Por ejemplo, un vídeo comercial podría usar una imagen de referencia para la identidad del producto, texto para la acción del producto, un vídeo de referencia para el movimiento de cámara, instrucciones de audio nativo para el diseño de sonido y un último fotograma para la toma principal final.
Esto evita un error común: pedir que un único prompt de texto largo lo controle todo.
¿Cómo escribir un prompt para MiniMax H3 que te de más control?
Un prompt de H3 útil describe el vídeo en el orden de reproducción. Piensa como un director que describe lo que realmente se puede ver y oír, en lugar de un redactor publicitario que enumera adjetivos, de forma muy parecida a las mejores prácticas utilizadas para escribir un guion de vídeo eficaz.
Una estructura práctica es:
Escena → Sujeto → Acción → Cámara → Diálogo/Sonido → Final
El formato de prompt base oficial de MiniMax sigue la misma lógica subyacente. Su integrated_multimodal_description describe las tomas en secuencia, mientras que overall_soundscape y non_diegetic_music controlan por separado el sonido físico y la banda sonora.
Construye la escena en el orden de reproducción
En lugar de:
Un comercial de cuidado de la piel cinematográfico y prémium con un movimiento dramático.
Usa una secuencia observable:
Un frasco de sérum de vidrio se encuentra sobre un pedestal de piedra oscura. Una luz estrecha barre la etiqueta. El frasco gira lentamente en el sentido de las agujas del reloj mientras la cámara se acerca. La condensación capta la luz. El frasco se detiene con el logotipo orientado hacia la cámara.
La segunda versión le proporciona a H3 cambios de estado visibles para ejecutar.
Considera también un presupuesto de complejidad. Un clip de 10 segundos con tres personajes, cuatro cortes, una transformación, dos líneas de diálogo, una cámara en movimiento y varias referencias puede ser técnicamente descriptible, pero eso no significa que todos esos eventos encajen de forma natural en diez segundos.
Dirige el movimiento de cámara y los cortes con intención
Especifica el comportamiento de la cámara únicamente cuando aporte valor a la toma: avance (push in), retroceso (pull back), paneo, seguimiento (track), inclinación (tilt), arco o estática.
Evita convertir cada ajuste de encuadre en un nuevo corte. Un cambio lento de plano medio a primer plano a menudo se puede describir como un movimiento de cámara en lugar de una escena nueva.
Define el final, no solo la acción
Un prompt resulta más fácil de controlar cuando explica dónde termina la acción.
En lugar de terminar con "el personaje camina hacia la ventana", define el estado final: el personaje se detiene junto a la ventana, se gira hacia la cámara y permanece enmarcado contra el horizonte de la ciudad.
Esto es especialmente importante para vídeos de demostración de productos, tomas de logotipos, transiciones y flujos de trabajo de primer y último fotograma.
¿Cómo usar imágenes, vídeos, guiones gráficos y referencias de voz en MiniMax H3?
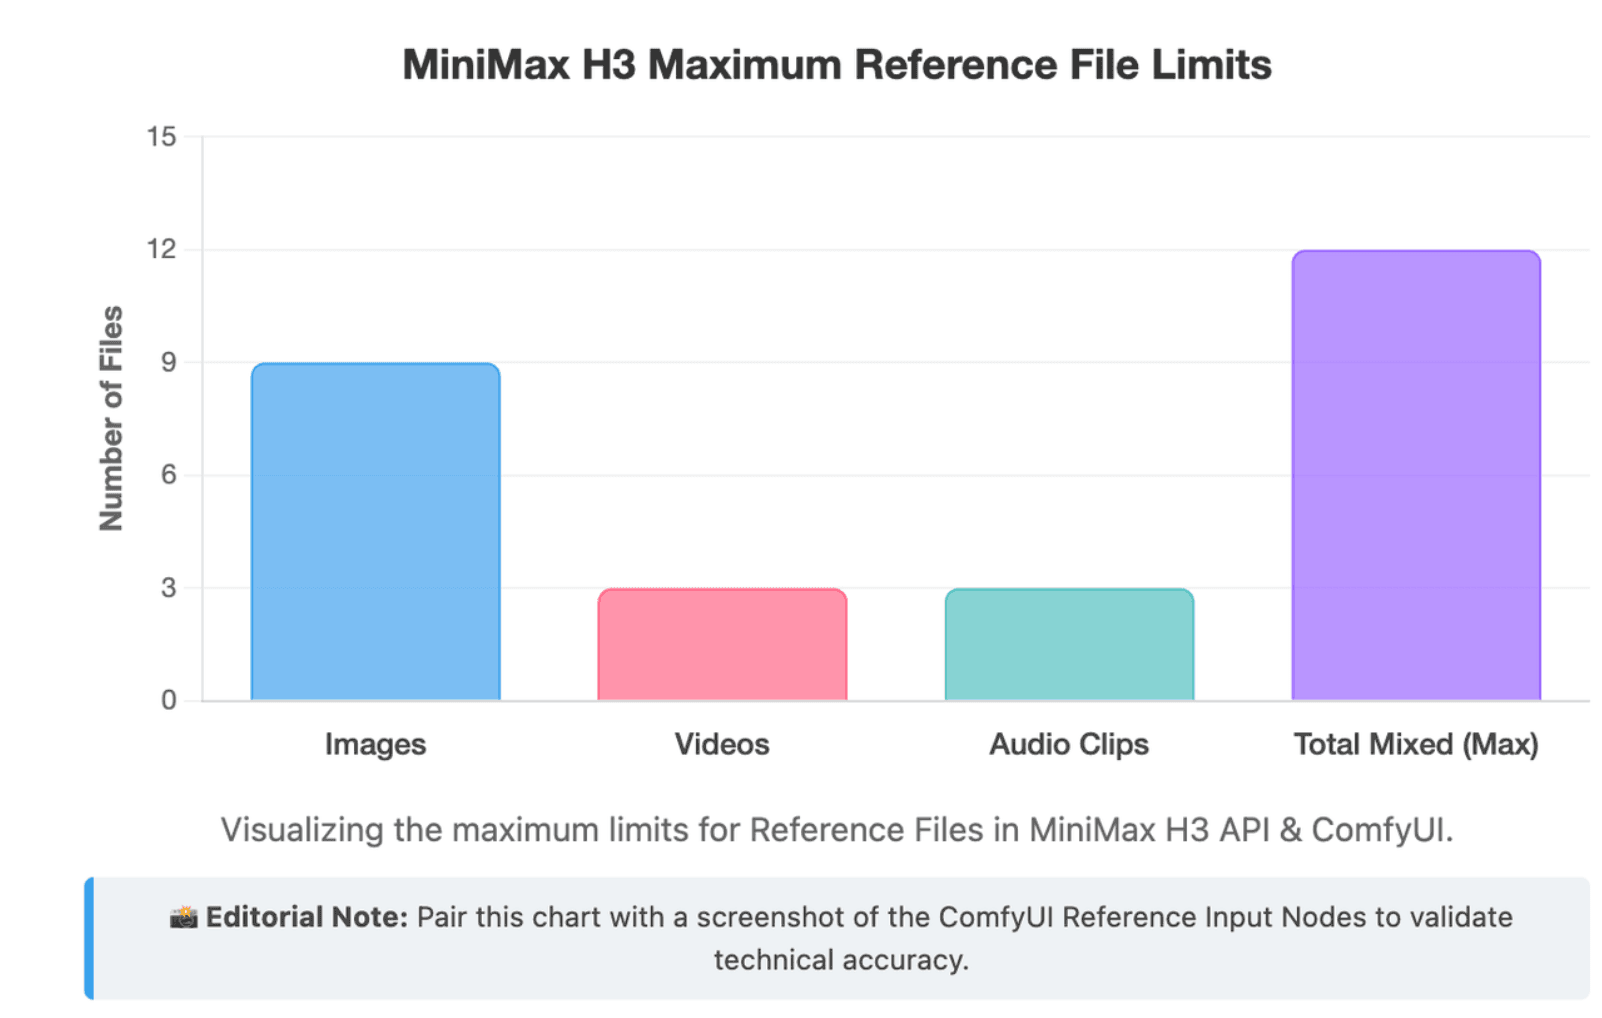
La función de referencia a vídeo es donde H3 se convierte en algo más que una herramienta convencional de imagen a vídeo. El modelo oficial Ref2VA acepta referencias multimodales y puede usarlas para influir en la identidad, el movimiento, el comportamiento de la cámara, el estilo y el audio. Actualmente, MiniMax documenta la compatibilidad con hasta nueve imágenes, tres vídeos de referencia, tres clips de audio y 12 archivos mixtos en total.
Asigna a cada referencia una tarea clara
Una configuración de referencia sólida podría asignar:
Imagen 1 → identidad del personaje; Imagen 2 → ropa; Vídeo 1 → movimiento corporal; Vídeo 2 → movimiento de cámara; Audio 1 → voz.
La documentación oficial de H3 para ComfyUI recomienda el mismo principio: hacer referencia a cada entrada en el orden de conexión y declarar explícitamente qué recurso controla la identidad, el estilo, el movimiento, la cámara o la voz.
Más referencias no crean automáticamente un mayor control. Crean más relaciones para que H3 las resuelva. Si dos imágenes sugieren conjuntos diferentes mientras un vídeo de referencia contiene la apariencia de otro personaje, el modelo debe decidir qué señal importa más a menos que el prompt deje claras esas responsabilidades.
<Subject> frente a <Picture>
En el formato de referencia completa de MiniMax, <Subject N> representa contenido visible reutilizable, como una persona, un objeto, un entorno u otro elemento abstraído de los recursos de referencia. <Picture N> representa una imagen concreta utilizada como anclaje de fotograma o composición. <Video N> y <Audio N> realizan el seguimiento de las referencias temporales o de audio.
Esto significa que un sujeto no tiene por qué equivaler a un único archivo. Un personaje podría combinar la identidad facial de una imagen con información sobre la ropa o el movimiento procedente de otra fuente.
¿Cuándo deberías usar un guion gráfico?
Cuando las relaciones espaciales se vuelven más difíciles de explicar que de mostrar, un guion gráfico puede actuar como una capa de planificación visual. Esto resulta especialmente útil para secuencias de múltiples tomas, presentaciones de productos, bloqueo de personajes o composiciones recurrentes.
Desde la perspectiva de un flujo de trabajo de vídeo con IA, la ventaja no es que un guion gráfico garantice cada fotograma. Reduce la cantidad de información espacial y de planificación de tomas que debe comunicarse únicamente mediante texto narrativo.
¿Cómo controlar los diálogos, los efectos de sonido y la música en MiniMax H3?
H3 genera audio estéreo nativo junto con el vídeo en lugar de tratar el audio como una capa de postproducción separada. MiniMax especifica una salida estéreo de 32 kHz, y su sistema de prompts admite diálogos, sonidos físicos y música no diegética como conceptos separados.
Escribe los diálogos como parte de la toma
El diálogo debe responder a cuatro preguntas: quién habla, qué dice, cuándo habla y cuánto tiempo en pantalla ocupa.
El formato estructurado de MiniMax puede utilizar identificadores de orador persistentes como (S1) y etiquetas de diálogo como <d>[English]...</d>. Sin embargo, los principiantes no necesitan empezar con la sintaxis. El principio más importante es la sincronización temporal.
Utiliza la presupuestación de diálogos
El diálogo consume segundos reales.
Si un personaje aparece durante cuatro segundos, evita escribir una frase que de manera realista requiera ocho segundos para pronunciarse. De lo contrario, el modelo se verá obligado a comprimir, acelerar, truncar o distorsionar el discurso.
Esto importa en la práctica porque los usuarios locales de H3 ya están iterando en la sincronización de tomas y diálogos junto con los prompts visuales en lugar de tratar el discurso como una capa independiente. Una prueba con una RTX 5080 utilizó un prompt estructurado de múltiples tomas y requirió ajustes repetidos en los prompts, mientras que la generación en sí seguía siendo computacionalmente costosa.
Separa el paisaje sonoro de la música de fondo
Utiliza el paisaje sonoro para los sonidos que existen físicamente en la escena: pasos, motores, viento, puertas, multitudes, movimiento de telas o maquinaria.
Utiliza la música no diegética para la música que escucha la audiencia pero no los personajes.
Separar ambos elementos le proporciona a H3 una dirección mucho más útil que una instrucción vaga como "añadir audio cinematográfico". El formato de prompt oficial de MiniMax mantiene deliberadamente separadas estas dos capas de audio.
¿Qué ajustes y flujo de trabajo de pruebas producen mejores resultados en MiniMax H3?
MiniMax documenta la salida de H3 a 4-15 segundos, 24 FPS, con múltiples relaciones de aspecto y un borde corto predeterminado de 768 píxeles para el flujo de trabajo abierto H3-Base. Su sistema completo puede producir resolución 2K a través de H3-Regenerate-2K.
Elige la duración, la relación de aspecto y la resolución según la toma
No elijas automáticamente la duración más larga. Adapta la duración a la cantidad de eventos significativos.
Usa 16:9 para la mayor parte del contenido horizontal, 9:16 para vídeo social vertical y 1:1 cuando una composición cuadrada sirva al canal de distribución. En ComfyUI, los flujos de trabajo oficiales de H3 exponen los controles de relación de aspecto y megapíxeles a través de un selector de resolución, donde un mayor recuento de píxeles incrementa el coste de generación.
Utiliza una escala de fidelidad de previsualización
Una previsualización de bajo coste es útil, pero solo para las preguntas correctas.
Las pruebas tempranas son buenas para comprobar la composición, el movimiento principal, la dirección de cámara, los cortes y la sincronización aproximada. Son menos fiables para evaluar texto pequeño, rostros distantes, logotipos o detalles finos de productos.
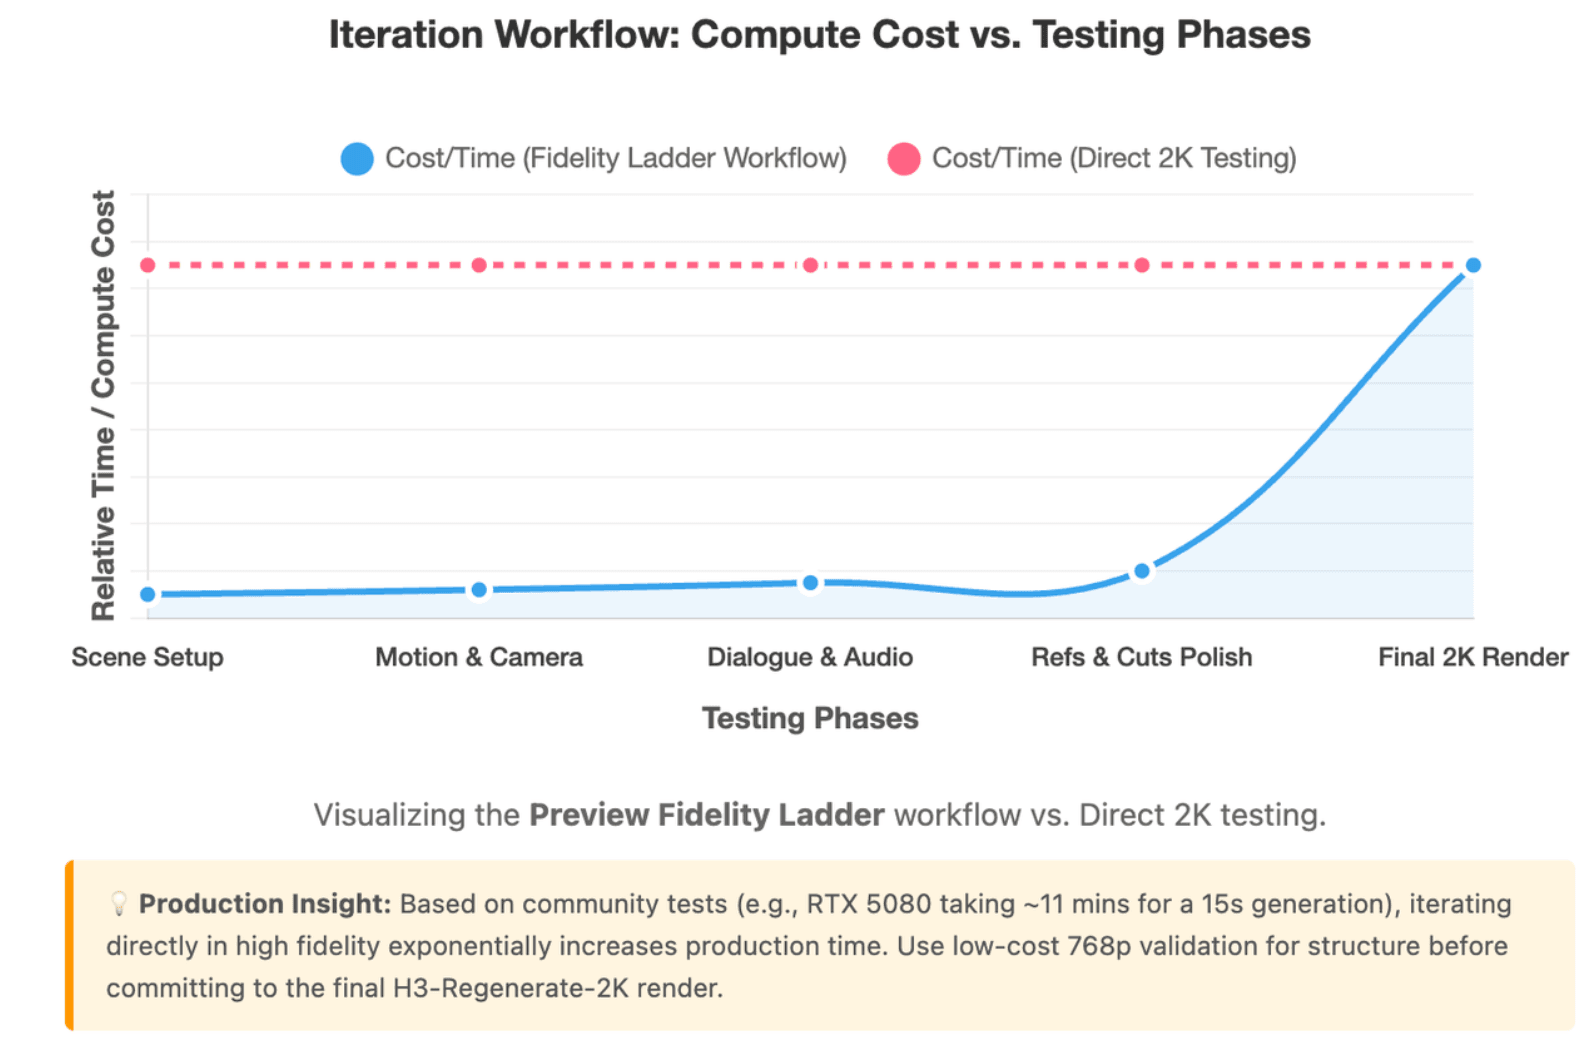
Por lo tanto, el objetivo no es simplemente "generar siempre a baja resolución primero". Consiste en utilizar generaciones más económicas para las decisiones estructurales y, a continuación, destinar potencia de cálculo a los detalles que solo se vuelven visibles con una mayor fidelidad.
Prueba una variable a la vez
Una secuencia de producción práctica consiste en validar primero la escena, luego el movimiento y la cámara, a continuación el diálogo y el audio, después las referencias adicionales o los cortes y, finalmente, la generación de alta calidad.
Esto importa porque el coste real del vídeo con IA suele ser coste de generación × recuento de iteraciones. En una prueba de la comunidad, un sistema con una RTX 5080 produjo una generación de H3 de 15 segundos, 0,4 MP y 10 pasos en unos 11 minutos, con un tiempo por paso que aumentaba sustancialmente a medida que crecía la duración del vídeo. El usuario también informó de la necesidad de aplicar soluciones alternativas para evitar fallos por falta de memoria. Trata esto como un caso real individual, no como un punto de referencia universal.
¿Cómo usar MiniMax H3 en ComfyUI, flujos de trabajo de API y solucionar problemas comunes?
ComfyUI proporciona actualmente plantillas oficiales de H3 para Text-to-Video, Image-to-Video y Reference-to-Video. Sus nodos nativos utilizan la familia FL2VA para los flujos de trabajo de texto/fotogramas y Ref2VA para las referencias multimodales.
La API de MiniMax adopta un camino diferente: las tareas de H3 son asíncronas. Envías una tarea de generación, Context-IR o regeneración, recibes un task_id y luego consultas esa tarea para obtener el resultado. Las tareas de generación exitosas devuelven el vídeo a través de content.url, mientras que Context-IR devuelve un prompt mejorado a través de content.prompt.
Tampoco se debe confundir el sistema H3 completo con los pesos abiertos de H3-Base. MiniMax describe tres módulos: H3-Context-IR → H3-Base → H3-Regenerate-2K. El módulo local H3-Base valida la generación a 768p, mientras que el flujo de trabajo completo en 2K combina el contexto original con el resultado a 768p para la regeneración.
Diagnostica los fallos en tres niveles
Antes de reescribir el prompt, identifica la capa del fallo.
| Capa | Problema típico | Qué cambiar |
| Prompt | Acción, sincronización, cámara o final incorrectos | Reescribir la línea de tiempo |
| Referencia | La identidad, la ropa, el movimiento o la voz se desvían | Aclarar o reducir los roles de referencia |
| Renderizado | Texto pequeño, rostros distantes, detalles finos | Probar ajustes o una salida de mayor fidelidad |
Esta es una distinción útil porque no todos los defectos visuales son un problema de prompts.
Problemas comunes de MiniMax H3 y soluciones prácticas
Si la identidad se desvía, simplifica las referencias conflictivas y define con claridad qué fuente controla la identidad. Si un producto o logotipo cambia, separa explícitamente los atributos que se deben conservar de los elementos que el modelo puede rediseñar.
Si el vídeo se siente apresurado, reduce las acciones, los cortes o los diálogos en lugar de añadir más detalles al prompt. Si el discurso suena comprimido, acorta el diálogo o dale más tiempo al orador.
Para la deformación entre el primer y el último fotograma, describe la transición física intermedia en lugar de especificar únicamente dos puntos finales. Si una referencia R2V tiene poca influencia, indica su papel exacto en lugar de limitarte a adjuntarla.
Los usuarios locales también deben abordar la optimización del rendimiento con cautela. ComfyUI documenta oficialmente el uso opcional de Sage Attention y afirma que sus flujos de trabajo de ejemplo pueden duplicar aproximadamente la velocidad de generación con una pérdida mínima de calidad, aunque otras técnicas de almacenamiento en caché, cuantización y optimización experimental pueden implicar compensaciones diferentes.
Conclusión
MiniMax H3 es más fácil de controlar cuando tratas la generación de vídeo como un flujo de trabajo de producción en lugar de un concurso de longitud de prompts. Elige el modo correcto, asigna a cada referencia una responsabilidad específica, presupuesta las acciones y los diálogos dentro del tiempo disponible, prueba las decisiones estructurales antes del renderizado de calidad final y diagnostica los fallos como problemas de prompt, referencia o renderizado. Ese enfoque se escala desde simples clips de texto a vídeo hasta configuraciones multimodales complejas, reflejando cómo la gente está creando vídeos con IA tan rápido hoy en día.