KI-Videodubbing: So funktioniert es und die besten Tools für 2026
Video-Dubbing mit KI ist der automatisierte Prozess der Video-Übersetzung, bei dem der originale gesprochene Dialog durch ein synchronisiertes, synthetisches Voiceover in einer Zielsprache ersetzt wird. Dabei bleiben die stimmliche Identität, die Kadenz und die emotionale Ausdrucksweise des Sprechers erhalten. Für globale Unternehmen und digitale Bildungsexperten entfallen dadurch die traditionellen Engpässe wie Studiobuchungen, das Casting von Sprechern und die manuelle Timeline-Bearbeitung.
Aus didaktischer Sicht wenden Schulungs- und Produktteams oft unverhältnismäßig viel Mühe dafür auf, bestehende Dokumente in Videoformate zu übertragen – nur um bei der Lokalisierung für internationale Märkte auf die nächste Hürde zu stoßen. Moderne KI-Video-Workflows schließen diese betriebliche Lücke: Plattformen wie Leadde ermöglichen es Teams, SOP-Dokumente in wenigen Minuten in Schulungsvideos zu verwandeln und Foliensätze automatisch in Basis-Assets zu verwandeln, während integriertes KI-Dubbing dabei hilft, die Videolokalisierung für ein globales Publikum in Minuten statt Wochen zu skalieren.
In diesem Leitfaden beleuchten wir die technische Architektur hinter moderner Sprachsynthese, vergleichen die führenden Dubbing-Plattformen für Unternehmens- und Bildungsinhalte und zeigen Ihnen, wie Sie einen automatisierten Lokalisierungs-Workflow implementieren, der die didaktische Klarheit in großem Maßstab bewahrt.
KI-Video-Dubbing: Was ist das und warum brauchen Content-Teams es?
Ein KI-Video-Dubbing-Tool ist eine Softwareplattform, die Künstliche Intelligenz nutzt, um das Voiceover für bestehende Video-Assets automatisch zu transkribieren, zu übersetzen und neu zu generieren. Fortgeschrittene Plattformen verwenden Voice-Cloning, um den ursprünglichen Tonfall, das Tempo und die stimmlichen Eigenschaften des Sprechers beizubehalten, sodass sich die lokalisierte Version für das Publikum vor Ort authentisch anfühlt.
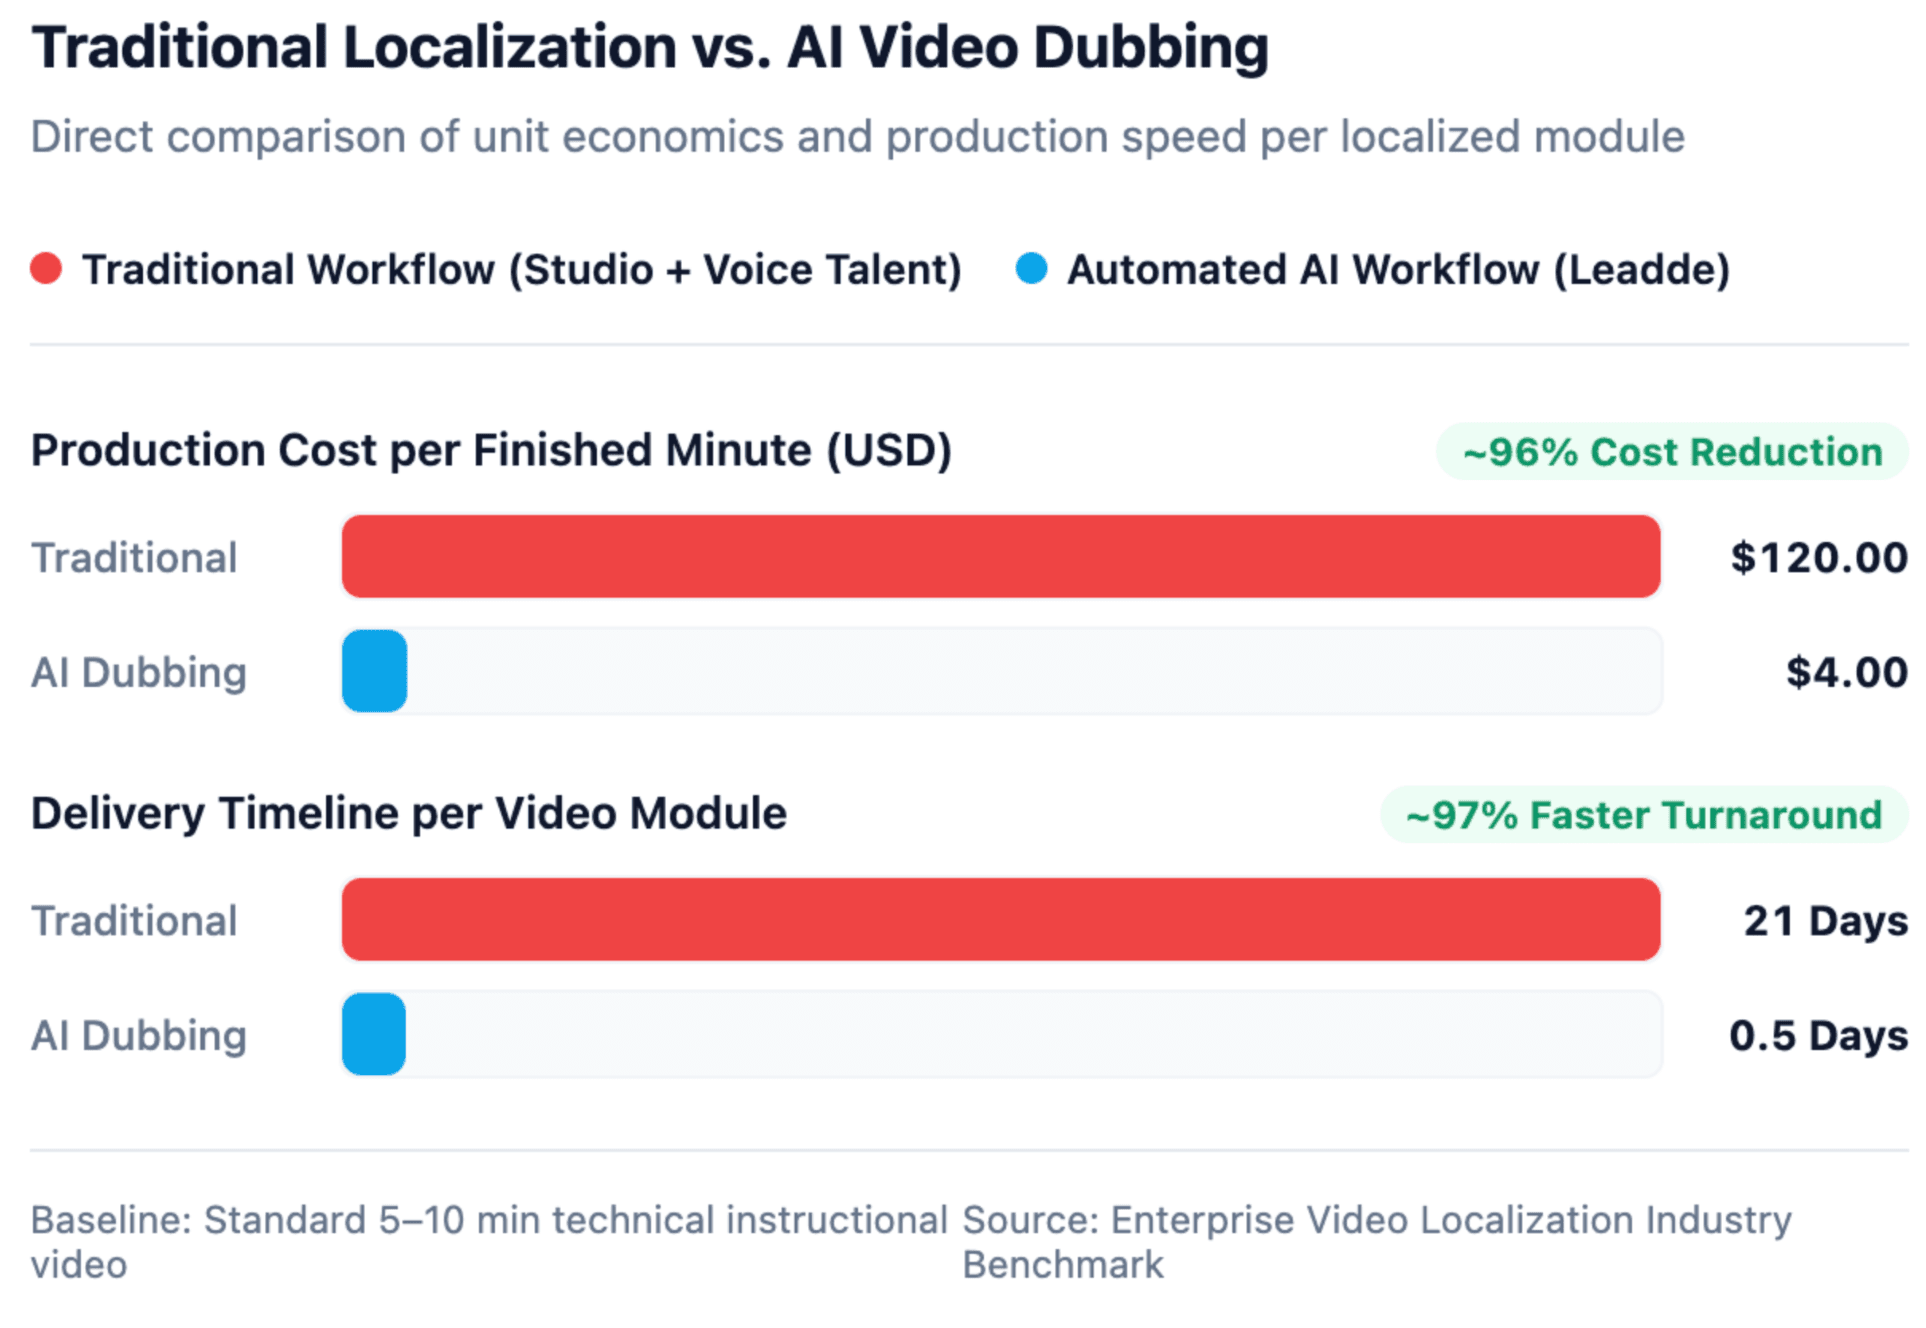
Aus Sicht des Instructional Designs stellt der traditionelle Lokalisierungszyklus – Transkribieren, Übersetzen, Aufnehmen und Nachbearbeiten – einen erheblichen Engpass für weltweite Schulungsinitiativen dar. Content-Teams stehen unter wachsendem Druck, lokalisierte Medien schnell bereitzustellen, ohne Abstriche bei der didaktischen Präzision zu machen. Während herkömmliche Methoden eine hohe emotionale Kontrolle gewährleisten, sind sie für die Skalierung moderner Videobibliotheken finanziell und organisatorisch nicht tragbar. KI-Video-Dubbing automatisiert diese repetitiven Produktionsschritte und versetzt Unternehmen in die Lage, Videoinhalte für globale Märkte anzupassen und die Markenkonsistenz zu einem Bruchteil der Kosten aufrechtzuerhalten.
Wie funktioniert der Prozess der KI-Videolokalisierung in der Praxis?
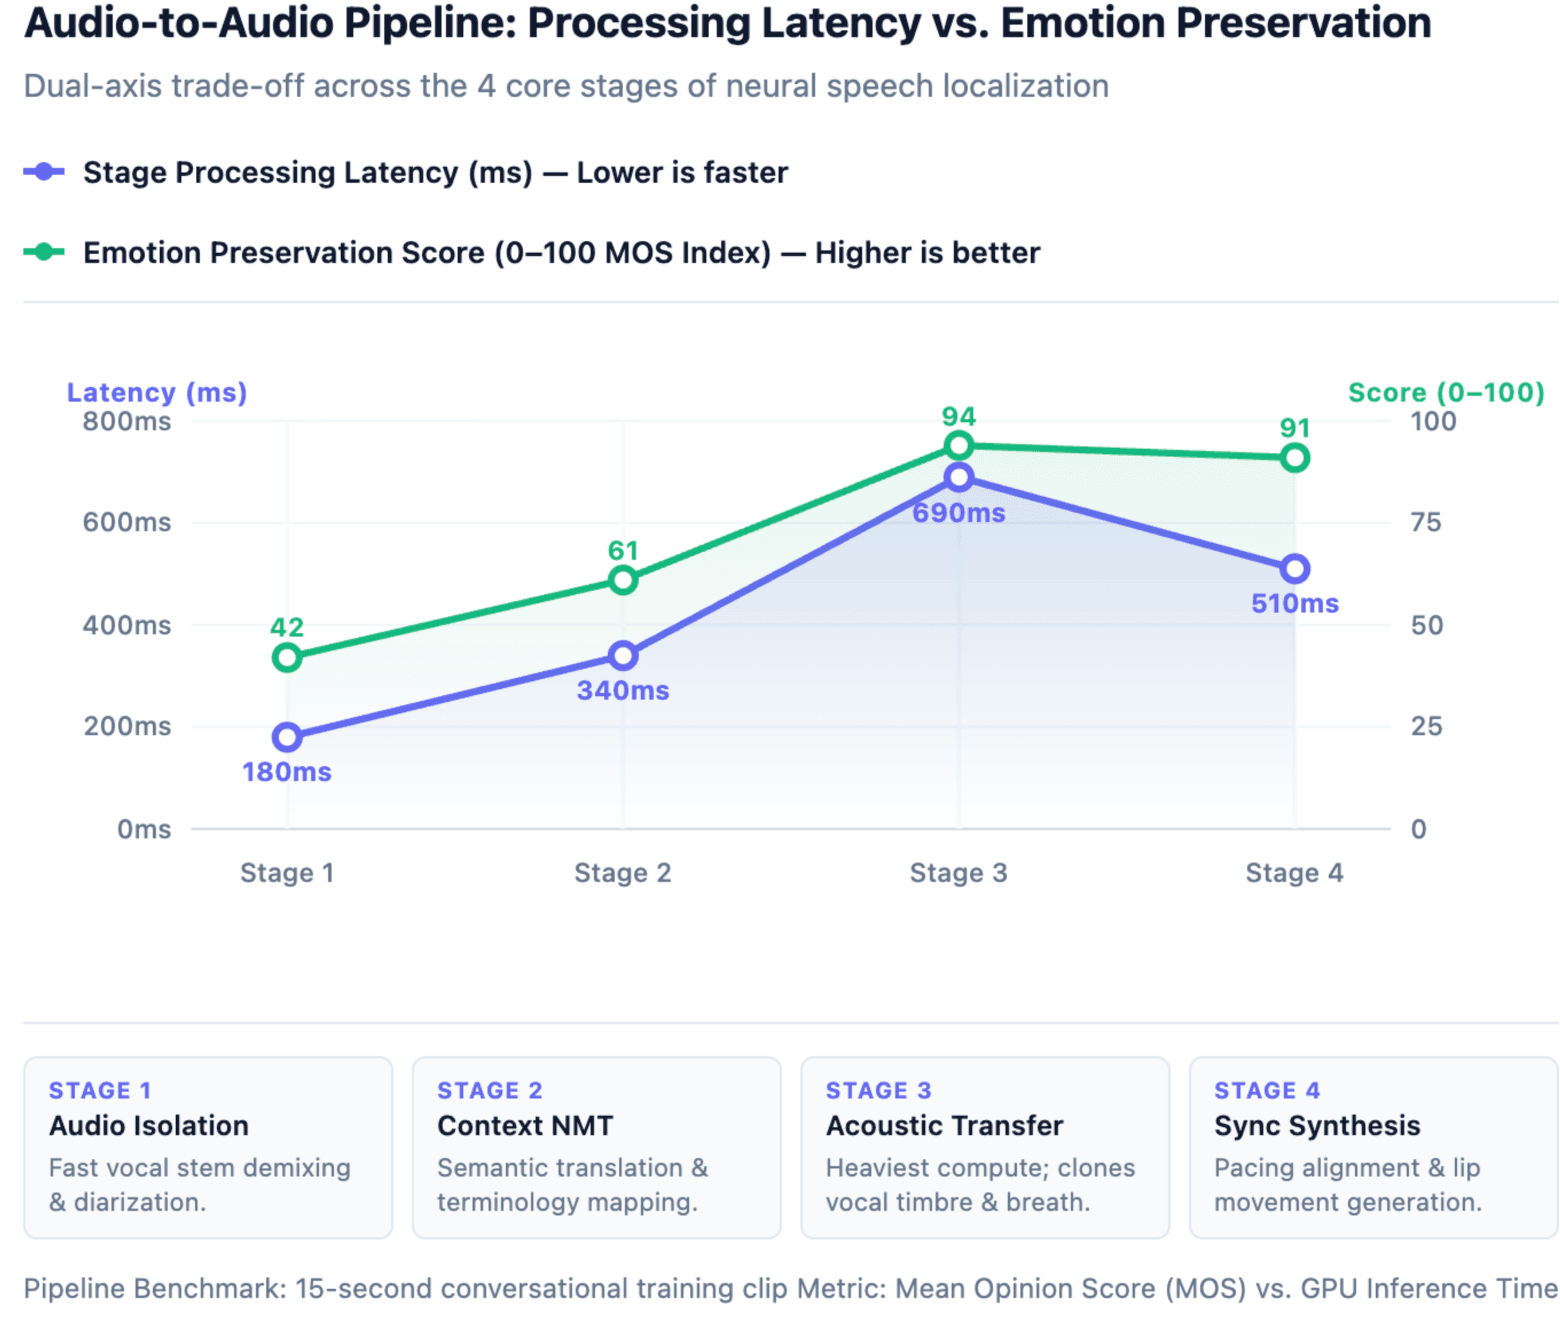
In professionellen Video-Workflows erfordert das nahtlose Ersetzen von Audioinhalten ohne Störung des visuellen Flusses eine synchronisierte technische Pipeline. Frühe Text-to-Speech-Tools klangen roboterhaft und überschrieben häufig wichtige Hintergrundgeräusche. Die heutigen KI-Modelle isolieren die Sprachebene und sorgen dafür, dass Hintergrundmusik und Umgebungsgeräusche intakt bleiben.
Spracherkennung und Sprechertrennung (Diarization)
Die KI-Engine trennt die primäre Sprachebene von Hintergrundgeräuschen, transkribiert die gesprochenen Wörter präzise und identifiziert mehrere verschiedene Sprecher (Diarization) im selben Video. Diese anfängliche Textextraktion bildet das grundlegende Transkript, das anschließend lokalisiert wird.
Kontextbezogene Lokalisierung
Anstatt einer wörtlichen Übersetzung passt eine fortschrittliche KI Formulierung, Redewendungen und Fachterminologie an, sodass das Ergebnis für ein muttersprachliches Publikum natürlich klingt. Professionelle Plattformen ermöglichen es Teams, diesen Text zu überprüfen und zu bearbeiten, um zu verhindern, dass sich didaktische Fehler fortpflanzen – wie ein dedizierter Video-Übersetzer für Unternehmens-Workflows.
Audio-zu-Audio-Stimmklonen (Voice Cloning)
Anstatt eine Stimme rein aus einem Texttranskript zu generieren, orientieren sich moderne generative Modelle direkt an der Performance des Quelldatei-Audios. Die KI erfasst Atemmuster, Mikropausen und die emotionale Kadenz, baut auf modernen Durchbrüchen beim Erstellen einer KI-Stimme auf und überträgt diese vokalen Nuancen auf die übersetzte Sprache.
Timing und visuelle Ausrichtung
Da übersetzte Sätze in ihrer Länge je nach Sprache variieren – deutsche Übersetzungen sind beispielsweise oft länger als englische –, passt die KI das Tempo des generierten Audios dynamisch an die visuellen Hinweise, Folienübergänge und Mundbewegungen des Originalvideos an.
Was sind die besten KI-Dubbing-Tools für Creator und Unternehmen?
Unternehmen und Creator haben unterschiedliche Kommunikationsziele und benötigen daher maßgeschneiderte Lokalisierungsstrategien. Ein Dozent, der ein statisches PDF in ein globales Compliance-Video umwandelt, hat ganz andere Softwareanforderungen als ein Social-Media-Manager, der einen kurzen Promo-Vlog synchronisiert.
| Option | Ideal für | Vorteile | Einschränkungen |
| Leadde | Bildungs- und Schulungsvideos | Speziell für Dokument-zu-Video-Workflows entwickelt; verwandelt PDFs, SOPs und Folien in strukturierte, lokalisierte Schulungsvideos in 88 Sprachen und 175 Dialekten. | Fokus liegt stark auf skalierbaren Unternehmens- und Schulungsinhalten statt auf isolierter Social-Media-Bearbeitung. |
| ElevenLabs | Emotionale Audiolokalisierung | Branchenführendes, natürliches Stimmklonen und Audio-zu-Audio-Emotionsübertragung; unterstützt über 90 Sprachen und Akzente. | Primär eine auf Audio fokussierte Pipeline; erfordert externe Tools, falls visuelles Lipsyncing benötigt wird. |
| HeyGen | Visuelle Sprecher-Lokalisierung | Hochpräzises visuelles Lipsyncing und robuste Erstellung benutzerdefinierter KI-Avatare für Talking-Head-Videos. | Premium-Dubbing- und Lipsync-Funktionen verbrauchen separate Guthaben-Kontingente; bei längeren Videos kann es zu Verzögerungen (Drift) kommen. |
| Canva (EasyDubbing) | Schnelle Marketingvideos | Direkt in den Canva-Editor integriert; schnelle Übersetzung mit einem Klick und Stimmklonen für Social-Media-Inhalte. | Am besten für Kurzform-Clips geeignet; bietet keine tiefen Integrationen in Lernmanagementsysteme von Unternehmen. |
Wie implementieren Sie einen skalierbaren Dokument-zu-Video-Dubbing-Workflow?
Schulungsteams verbringen oft viel Zeit damit, Dokumente und Präsentationen in Videos umzuwandeln, bevor die Lokalisierung überhaupt beginnen kann. Sich für jede Sprachvariante auf manuelle Aufnahmen zu verlassen, ist veraltet und nicht skalierbar.
Generierung des Basisvideos aus Dokumenten
Anstatt einen menschlichen Präsentator komplett von Grund auf neu aufzunehmen, können Sie einen KI-Videogenerator wie Leadde verwenden, um vorhandenes Unternehmenswissen zu nutzen – zum Beispiel um zu erfahren, wie man ein PDF-Handbuch in ein Schulungsvideo umwandelt oder Word-SOPs einbindet. Die Plattform strukturiert das Dokument automatisch in logische Szenen, generiert ein didaktisches Skript und wendet einen initialen KI-Präsentator sowie ein Voiceover an.
Prüfung des Quelltranskripts
Bevor der Dubbing-Prozess gestartet wird, sollten Content-Teams das Basistranskript manuell überprüfen. Die Korrektur eines falsch verstandenen Fachbegriffs oder firmeninternen Akronyms in der Quellsprache verhindert, dass sich dieser Fehler in mehreren Zielsprachen multipliziert.
Anwendung der geklonten Stimme und Lokalisierung im großen Stil
Verarbeiten Sie das freigegebene Basisvideo über die Dubbing-Engine und stellen Sie sicher, dass das Tool die Stimme des KI-Trainers und dessen emotionalen Tonfall beibehält. Überprüfen Sie die lokalisierten Ergebnisse und exportieren Sie die finalen Videos zusammen mit generierten, mehrsprachigen Untertiteln (SRT-Dateien), um die Barrierefreiheit vollständig zu gewährleisten. So lässt sich das globale Training mit KI-Videotools synchronisieren und über verteilte Teams hinweg skalieren.
Was sind die häufigsten Herausforderungen bei der Skalierung mehrsprachiger Videos?
Während die KI-Videogenerierung immer breitere Anwendung findet, beschäftigen sich viele Creator und Pädagogen mit der Frage, wie realistische KI-Videos erstellt werden, während sie gleichzeitig darum kämpfen, eine natürliche Darbietung und visuelle Konsistenz zu wahren. Das Verständnis dieser Grenzen ist entscheidend für den Aufbau skalierbarer Workflows.
Vermeidung von Lipsync-Drift bei Langform-Inhalten
Viele KI-Tools für visuelles Dubbing haben bei langen, durchgehenden Einstellungen Schwierigkeiten, was nach einigen Minuten oft zu visuellem Drift oder einer Diskrepanz zwischen Audio und Mundbewegungen führt. Um dem entgegenzuwirken, verarbeiten Profis lange Videos in überschaubaren Abschnitten oder nutzen B-Roll-Material und Präsentationsfolien gezielt, um vom Gesicht des Präsentators wegzuschneiden.
Umgang mit Textexpansion und kognitiver Belastung
Bei der Übersetzung technischer Inhalte aus dem Englischen in Sprachen wie Deutsch oder Spanisch kommt es naturgemäß zu einer Textexpansion (Texterweiterung). Wenn ein KI-Tool eine längere Übersetzung in ein komprimiertes Zeitfenster presst, wird die Sprache unnatürlich schnell, was die kognitive Belastung der Lernenden drastisch erhöht. Didaktiker müssen lokalisierte Skripte kürzer und prägnanter fassen, anstatt das Audio künstlich zu beschleunigen.
Handhabung von Sprechertrennung (Diarization) bei mehreren Personen
Obwohl automatisierte Tools praktisch für die schnelle Bereitstellung sind, scheitern sie oft daran, verschiedene Stimmen zu erkennen oder beizubehalten, wenn mehrere Personen sprechen. Bei Podiumsdiskussionen oder Interviewvideos müssen Content-Teams spezielle KI-Plattformen nutzen, die in der Lage sind, mehrere verschiedene Sprecher gleichzeitig zu klonen und zu trennen, ohne die Stimmprofile zu vermischen.
Häufig gestellte Fragen (FAQ)
Behält das KI-Dubbing die Emotionen des ursprünglichen Sprechers bei?
Ja. Moderne KI-Dubbing-Systeme nutzen Audio-zu-Audio-Modellierung. Anstatt nur ein übersetztes Texttranskript vorzulesen, analysiert die KI die emotionale Ausdrucksweise, die Tonhöhe und die Atemmuster des Originalaudios und wendet dieselben Intonationen auf die Zielsprache an.
Wie verwandelt man Schulungsdokumente in synchronisierte Videos?
Plattformen wie Leadde sind auf Dokument-zu-Video-Workflows spezialisiert. Nutzer können bestehende PDFs oder Präsentationen hochladen, erfahren, wie man mehrsprachige Videovorträge mit KI Schritt für Schritt erstellt, und den Text in ein strukturiertes Bildungsvideo mit KI-Voiceover umwandeln, das sich anschließend problemlos in mehrere Sprachen übersetzen und synchronisieren lässt.
Kann KI-Dubbing Hintergrundgeräusche und Musik erhalten?
Ja. Moderne KI-Dubbing-Tools isolieren die primäre Sprachebene vom Hintergrundaudio. Sie ersetzen lediglich die gesprochenen Wörter durch das übersetzte Voiceover, während originale Musik, Soundeffekte und Umgebungsgeräusche vollständig intakt bleiben.
Warum reicht das Auto-Dubbing von YouTube für das Unternehmens-Training nicht aus?
Obwohl die integrierte Übersetzung von YouTube für den alltäglichen Gebrauch effizient ist, gelingt es ihr oft nicht, die emotionale Intonation des Sprechers beizubehalten. Zudem hat sie Probleme mit der Sprechertrennung bei mehreren Personen und klont nicht die Originalstimme, was die professionelle Qualität mindert, die für Unternehmensschulungen erforderlich ist.
Ist die KI-Videolokalisierung für geschützte Unternehmensdaten sicher?
KI-Video-Plattformen auf Enterprise-Niveau bieten robuste Datenschutzvorgaben, die sicherstellen, dass proprietäre Schulungsmaterialien und geklonte Stimmdaten nicht zum Training öffentlicher KI-Modelle verwendet werden. Überprüfen Sie vor dem Hochladen interner Dokumente stets die Compliance- und Sicherheitsstandards der jeweiligen Plattform für Unternehmen.
KI-Video-Dubbing hat die Art und Weise, wie sich Unternehmen der globalen Kommunikation nähern, grundlegend verändert. Es verwandelt einen ehemals teuren und zeitaufwendigen Lokalisierungszyklus in einen agilen, automatisierten Workflow. Durch die Kombination aus intelligenter Dokument-zu-Video-Generierung, modernem Stimmklonen und sorgfältiger Qualitätskontrolle können Content-Teams ansprechende, mehrsprachige Schulungsbibliotheken erfolgreich über internationale Märkte hinweg skalieren.