Guide des Prompts MiniMax H3 : Rédigez des prompts vidéo, Ref2VA, caméra, audio et de référence plus efficaces
Un prompt MiniMax H3 efficace ne doit pas se limiter au style visuel. Il doit expliciter le déroulement temporel, les mouvements de caméra, les éléments constants, le rôle de chaque référence, ainsi que l'intégration des dialogues, des bruitages et de la musique. Pour un contrôle optimal, le secret réside dans le choix du bon mode H3, la description de faits observables et l'attribution d'un rôle précis à chaque référence.
Ce guide aborde le T2VA, l'I2VA, le FL2VA, l'L2VA, le Ref2VA, le contrôle de la caméra, l'audio, la cohérence des personnages et les aspects pratiques du dépannage. Ces principes s'appliquent également aux workflows vidéo IA structurés, comme sur Leadde, où les documents, supports de formation et informations produits sont transformés en vidéos évolutives avec narration, avatars et génération multilingue.
Guide des prompts MiniMax H3 : quelle est la structure idéale ?
La meilleure façon d'aborder un prompt MiniMax H3 est de le voir comme une note de production audiovisuelle. Plutôt que d'accumuler des mots-clés tels que « cinématique », « réaliste » et « dramatique », décrivez ce que le spectateur voit et entend concrètement à mesure que le clip progresse, afin de comprendre comment créer des vidéos réalistes par IA.
La formule simple pour un prompt H3
Pour des requêtes courantes, partez de cette base :
Sujet + Action + Environnement + Caméra + Temporalité + Audio
Par exemple, « une femme dans une gare pluvieuse » pose le décor, mais n'apporte que peu d'informations temporelles. Un prompt plus percutant précisera qu'elle s'avance vers le quai, s'arrête au bruit d'un train qui approche, se tourne vers la source du son, tandis qu'une caméra en travelling lent la suit.
Le guide officiel des prompts de base de MiniMax formalise cette approche autour de trois champs : integrated_multimodal_description, overall_soundscape et non_diegetic_music. Le premier intègre la chronologie visuelle, les actions, les plans, les locuteurs, les dialogues et l'audio synchronisé de la scène ; les deux autres séparent l'environnement sonore physique de la musique de fond réservée au public.
Rédigez des résultats observables, pas de simples adjectifs
Une règle d'or consiste à traduire les intentions abstraites en comportements visibles.
Au lieu de « elle a l'air sûre d'elle », décrivez une démarche assurée, un regard fixe, un geste pour remonter sa veste et un arrêt net, sans hésitation.
La même méthode s'applique aux contraintes. Plutôt que de répéter « pas de zoom », décrivez le résultat escompté : « le sujet conserve approximativement la même taille dans le cadre du début à la fin ». Un test de cohérence H3 mené par la communauté H3 consistency test a montré que des limites de cadrage mesurables fonctionnaient mieux dans ce type de workflow que des interdictions de mouvements de caméra répétées en boucle. Il s'agit d'une observation empirique issue des usages, et non d'une garantie officielle de MiniMax.
Quel mode MiniMax H3 devez-vous utiliser ?
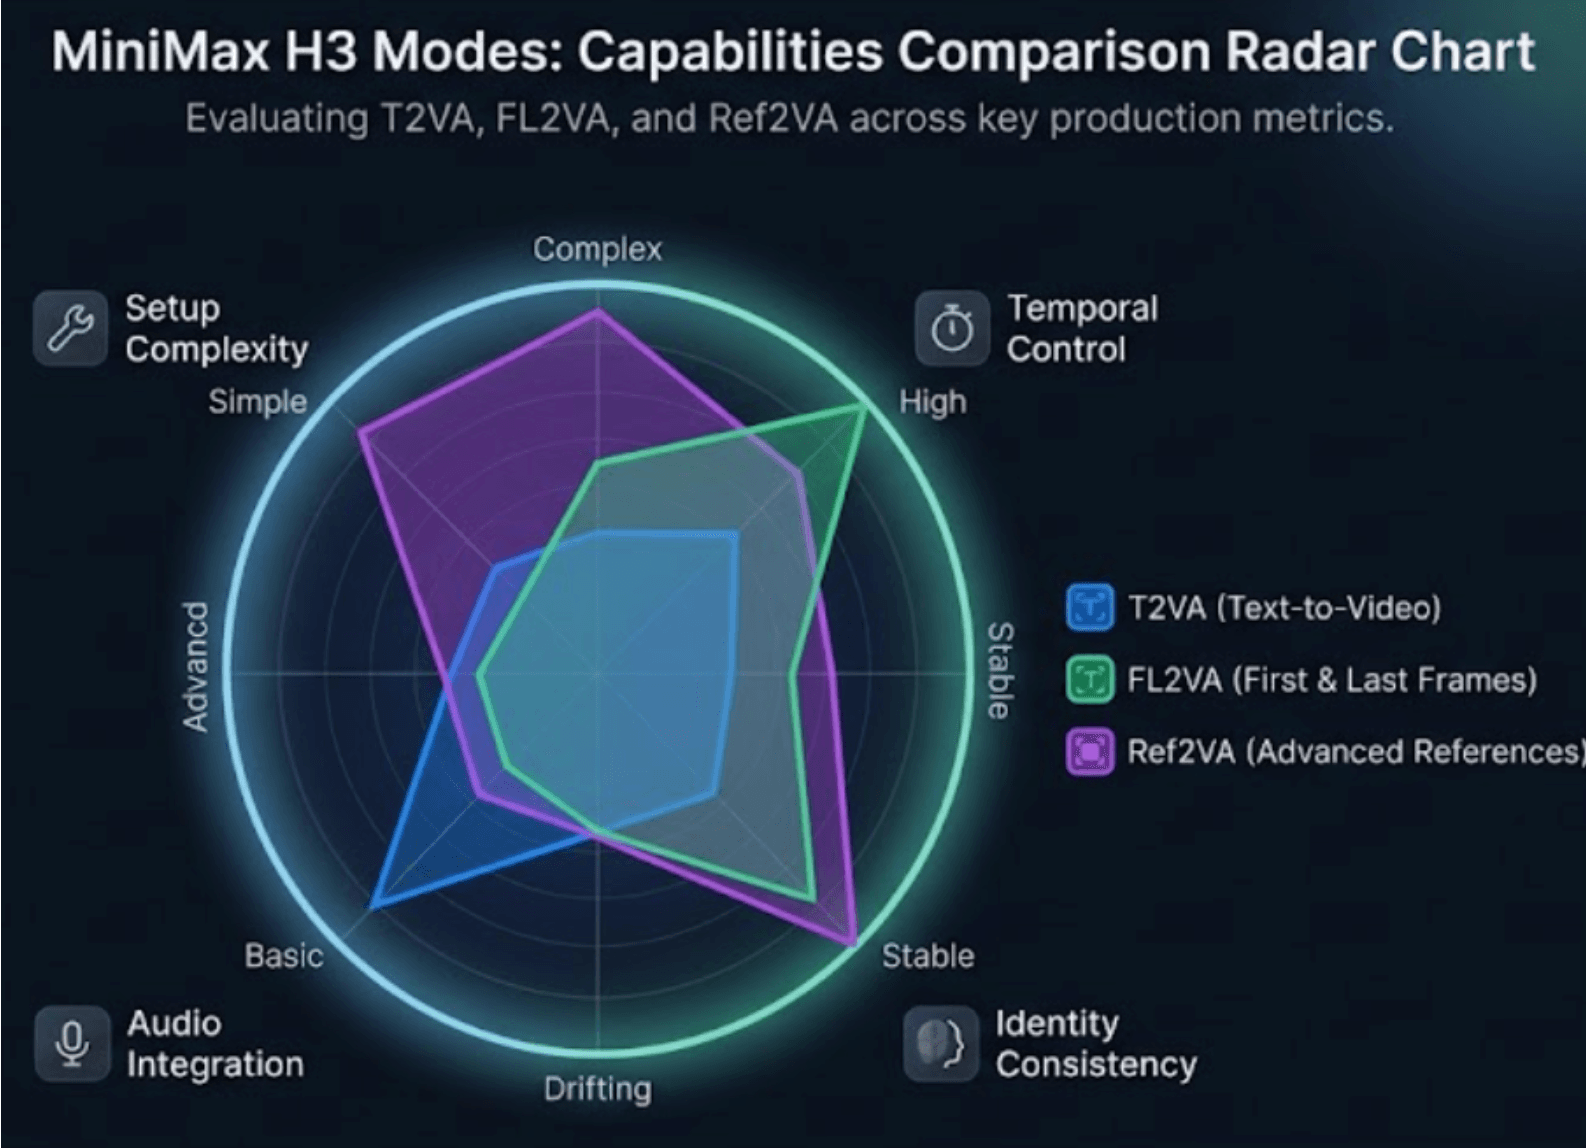
Le choix du bon mode peut s'avérer tout aussi crucial que la réécriture du prompt. Le workflow de base de MiniMax gère la génération textuelle simple ainsi que les tâches basées sur la première image, la dernière image, ou les deux à la fois (première et dernière), tandis que son point de contrôle Ref2VA gère la génération à partir de références multimodales.
| Mode | Entrée | Objectif de prompt idéal |
| T2VA | Texte | Créer la scène audiovisuelle complète |
| I2VA | Première image | Conserver l'ouverture et développer la suite |
| FL2VA | Première + dernière image | Décrire la transition entre les deux points clés |
| L2VA | Dernière image | Construire la scène pour aboutir à l'image finale |
| Ref2VA | Images / vidéo / audio | Combiner différents types de références |
T2VA, I2VA, FL2VA et L2VA
Le T2VA doit concevoir la scène à partir d'une page blanche. L'I2VA considère l'image fournie comme le premier plan effectif ; le prompt doit donc préserver l'identité, la tenue, les objets, les teintes et la composition avant d'introduire le mouvement.
Avec le FL2VA, le prompt ne doit pas se contenter de décrire l'image 1 et l'image 2. MiniMax recommande spécifiquement de décrire le parcours observable entre les deux : l'évolution des mouvements du sujet, la transformation des poses, la manipulation d'objets, ainsi que la convergence de la composition ou de l'éclairage vers le cadre final. L'L2VA inverse la logique en partant d'un état initial plausible pour aboutir progressivement à l'image finale fournie.
Quand faut-il utiliser le Ref2VA ?
Utilisez le Ref2VA lorsque plusieurs sources jouent des rôles distincts — par exemple, une image définit un personnage, une autre ses vêtements, une vidéo fournit le mouvement de marche et le rythme de la caméra, et un fichier audio sert de référence vocale.
Il s'agit plutôt d'une génération pilotée par les interactions. Le modèle doit comprendre non seulement ce que contient chaque fichier, mais aussi comment les données de chaque source doivent influencer la vidéo finale. Le format de référence complète de MiniMax distingue clairement les sujets réutilisables, les ancrages visuels concrets, les sources temporelles issues de vidéos et les références audio.
Privilégiez le mode le plus simple pour chaque plan
Une règle de production pragmatique s'impose : n'ajoutez de la complexité dans les références que si le plan l'exige vraiment.
Si une transition nécessite simplement un point de départ et d'arrivée précis, le FL2VA offre une définition directe. Passez au Ref2VA lorsque vous avez réellement besoin de combiner des paramètres croisés, tels que l'identité de l'image 1 + le mouvement de la vidéo 1 + la voix de l'audio 1.
Cela simplifie également le diagnostic en cas de bug. Avec moins de contraintes indépendantes en concurrence, il est plus facile de déterminer si le problème vient du mouvement, de l'identité, du cadrage ou du son.
Comment contrôler les plans, les mouvements de caméra, le timing et les transitions ?
Les prompts H3 s'avèrent plus faciles à maîtriser lorsque l'on traite la timeline comme un montage plutôt que comme un paragraphe de texte.
Coupes de plans, repères temporels et budget temporel
Le format officiel de MiniMax n'utilise pas de repère temporel du type [Shot 1]. Les plans suivants débutent avec des temps de coupe croissants, par exemple [Shot 2] At 00:03.500. Un nouveau plan doit introduire un élément nouveau et significatif — comme un angle de vue différent, un autre lieu, un changement d'état, un nouveau sujet ou un saut dans le temps. Une variation minime de distance ou d'angle s'exprime généralement mieux par un mouvement de caméra que par une coupe franche.
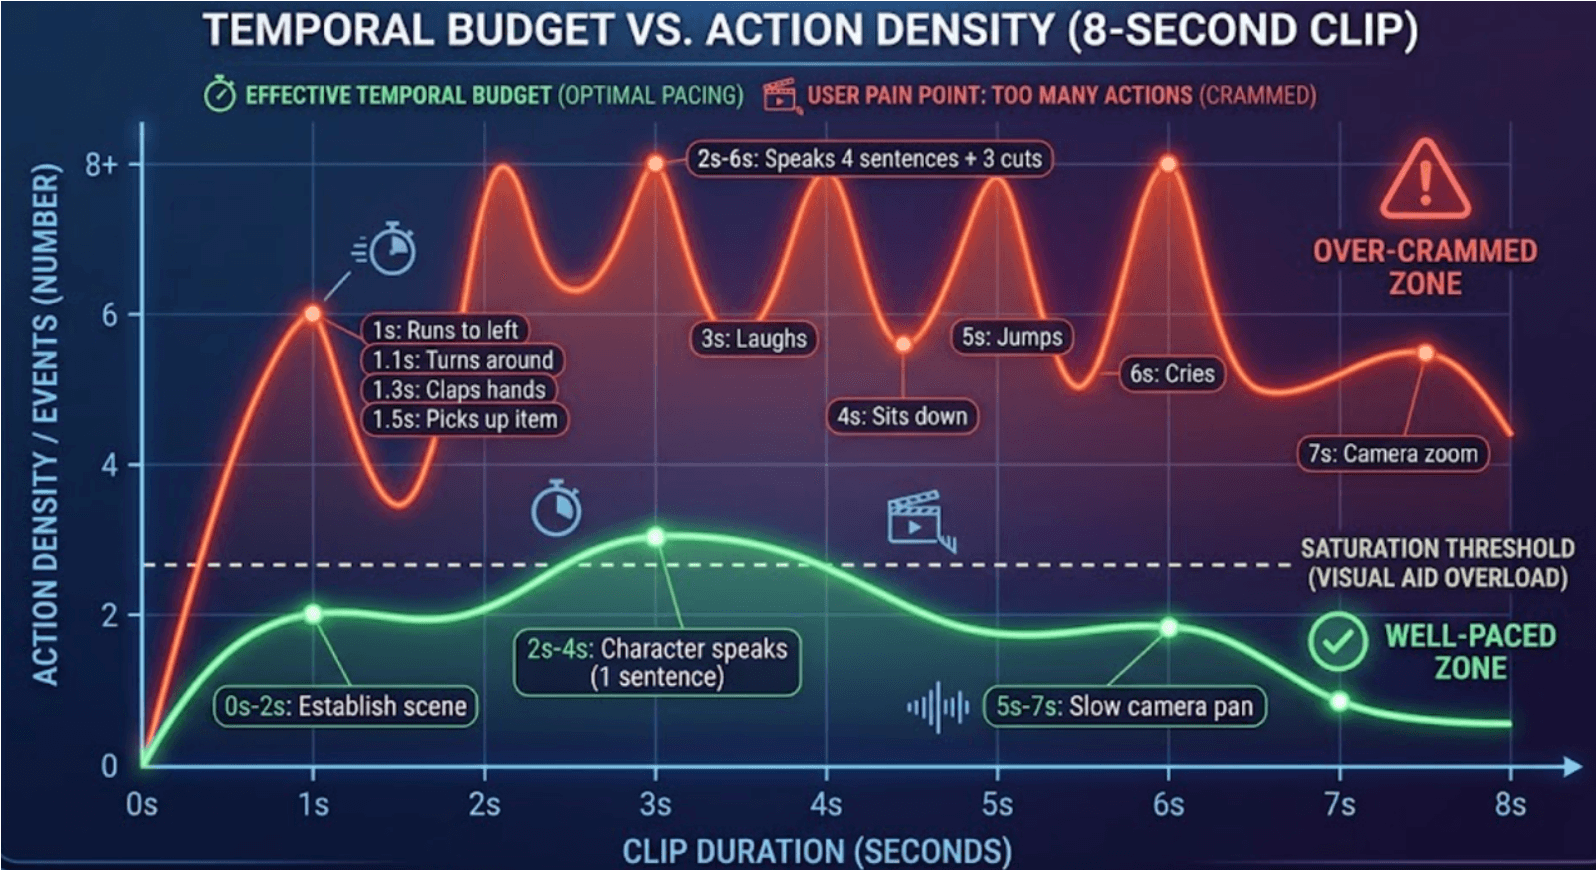
Cela instaure un budget temporel concret. Dans un clip de 8 secondes, trois actions, deux mouvements de caméra, une réaction, une phrase parlée et deux coupes se disputent la même durée limitée. Lorsqu'une génération donne une impression de précipitation, supprimer des actions s'avère souvent plus efficace que d'alourdir la description.
Le vocabulaire de caméra pris en charge par H3
La documentation de MiniMax prend en charge divers mouvements de caméra : zooms avant/arrière (push/pull), panoramas (pan), déplacements latéraux (truck), inclinaisons (tilt), élévations (pedestal), arcs, travellings, plans fixes, subjectif (POV), rotations (roll) et tremblements de caméra. La logique recommandée suit pour l'essentiel ce schéma :
Type de mouvement + Amplitude (optionnelle) + Vitesse (optionnelle)
Ainsi, au lieu d'un « plan cinématique dynamique », écrivez une consigne exploitable, telle que « la caméra effectue un lent travelling vers la droite tout en maintenant le produit au centre ».
Séparez ce qui doit rester figé de ce qui peut évoluer
Avant de lancer la génération, établissez une cartographie mentale simple des éléments fixes et variables.
Une vidéo produit peut exiger que la forme de la bouteille, le texte de l'étiquette, le bouchon et la couleur restent inchangés, tandis que la position de la caméra, les reflets, les mouvements d'eau et l'éclairage évoluent. Une séquence narrative peut figer le visage, la coupe de cheveux et la tenue d'un personnage tout en laissant sa posture et son expression se modifier.
Cette approche réduit les instructions contradictoires, car le prompt ne demande plus à toutes les propriétés visuelles de changer en même temps.
Comment utiliser les références sans perdre en cohérence sur le personnage ou le produit ?
Les workflows de référence les plus performants attribuent à chaque élément un rôle bien défini.
Attribuez à chaque référence une fonction unique
Une répartition opérationnelle type ressemble à ceci :
Image 1 → identité du personnage Image 2 → vêtements Image 3 → design du produit Video 1 → mouvement de marche et trajectoire de caméra Audio 1 → timbre de voix
Le format Ref2VA officiel de MiniMax prend précisément en charge ce type de définition croisée : un sujet peut emprunter son apparence à une image et ses mouvements à une vidéo, tandis qu'un fichier de référence unique peut également fournir plusieurs entités réutilisables.
L'essentiel est d'éviter les transferts fortuits. Si la vidéo 1 doit fournir le mouvement mais ni son acteur ni son environnement, exprimez-le clairement dans la configuration des relations.
Sujets, images, storyboards et vidéos de référence
Dans la terminologie officielle, <Subject N> représente le contenu visible réutilisable, tandis que <Picture N> intervient lorsqu'une image fait office de plan concret, de repère de composition, ou de référence pour un scénario et un storyboard vidéo. <Video N> couvre les interactions à l'échelle de la vidéo entière (montage, continuité, mouvements de caméra, coupes, rythme ou structure temporelle). <Audio N> gère la reproduction audio ou des caractéristiques spécifiques comme le timbre vocal, le phrasé, le rythme ou le style musical.
Cette distinction évite une erreur conceptuelle fréquente : une référence de personnage ne constitue pas automatiquement une image clé, et un storyboard ne fixe pas forcément un point final exact.
Économie des références et cohérence au niveau du plan
Multiplier les ressources de référence n'apporte pas nécessairement plus de pertinence. Dans le cadre de la production, veillez à ne conserver de la vidéo de référence que la portion qui illustre clairement le mouvement, le trajet de caméra ou la qualité vocale recherchés.
Évaluez également la constance de l'identité tout au long du plan plutôt que sur la seule première image. Un test communautaire a mis en évidence une dérive d'identité nettement plus précoce sur les gros plans que sur les plans larges dans le cadre de la configuration locale de cet utilisateur. S'il ne faut pas généraliser ces repères temporels stricts, la leçon pratique reste précieuse : vérifiez le visage, la tenue et les accessoires secondaires à plusieurs moments clés de chaque plan important.
Comment fonctionnent le Ref2VA avancé, les dialogues et le prompt audio ?
Le Ref2VA rapproche la rédaction de prompts H3 d'une planification de production multimédia que d'une simple requête texte-vers-vidéo.
La structure en six parties d'un prompt Ref2VA
Le guide complet des références de MiniMax définit six sections :
subject_definitions → summary → retention_analysis → detailed_description → overall_soundscape → non_diegetic_music.
Le système définit d'abord le sens des références, résume la tâche, explique comment chaque ressource est conservée ou convertie, pour enfin rédiger la vidéo cible dans l'ordre de lecture.
Une étape de planification utile en amont de la rédaction formelle du prompt s'articule ainsi :
| Source | Conserver | Transférer | Ignorer |
| Image 1 | Visage, cheveux | — | Arrière-plan |
| Video 1 | — | Marche, caméra | Identité de l'acteur |
| Audio 1 | Timbre vocal | Phonétique / phrasé | Dialogue d'origine |
Cette méthode transforme une demande floue comme « utilise toutes ces références » en des relations explicites entre source et cible.
Dialogues, voix, effets sonores et musique
Les personnages qui parlent utilisent des identifiants stables tels que (S1) et (S2), tandis que les dialogues s'insèrent entre les balises <d>[Langue] ...</d>. MiniMax distingue également les dialogues audibles à l'écran d'une voix off hors champ, et recommande de maintenir explicitement la bouche fermée d'un personnage à l'écran lorsque celui-ci assure uniquement la narration.
Les sons ambiants et les effets physiques relèvent de l'environnement sonore (soundscape), tandis que non_diegetic_music est réservé à la musique perçue par le public et non par les protagonistes. Si vous souhaitez des bruits de pas, de la pluie et des sons d'objets sans bande originale, conservez l'ambiance sonore et attribuez la valeur non_diegetic_music: N/A.
Prompt en langage naturel vs prompt structuré officiel
Les instructions courtes en langage naturel conservent toute leur efficacité sur la plateforme MiniMax, car celle-ci s'appuie sur H3-Context-IR, une couche de pré-traitement qui analyse les interactions entre texte, images, vidéo et audio avant de générer une représentation structurée pour H3-Base. La fiche technique du modèle ouvert cite d'ailleurs l'analyse des instructions, l'association multimodale, la compréhension temporelle et le raisonnement logique parmi ces mécanismes.
Cela explique une apparente contradiction : les prompts simples conviennent aux générations hébergées directes, tandis que les prompts structurés gagnent en pertinence pour la gestion multi-références, les dialogues, le minutage et les processus de production répétitifs.
Pourquoi MiniMax H3 ignore-t-il les prompts, et quel est le meilleur workflow de test ?
Face à un échec de génération, tout réécrire en même temps complexifie l'identification de la cause.
Problèmes fréquents avec les prompts H3 et solutions
| Problème | Cause probable | Premier test à effectuer |
| Mauvaise personne qui parle | Assignation des locuteurs ambiguë | Verrouiller (S1)/(S2) |
| Le personnage change | Signaux d'identité conflictuels | Simplifier les références |
| Référence ignorée | Rôle ambigu | Attribuer un rôle unique |
| Coupes aléatoires | Trop d'instructions de plans | Utiliser les mouvements de caméra |
| Repère temporel ignoré | Utilisé comme timing d'action | Le réserver aux coupes |
| Sauts en FL2VA | Chemin de transition manquant | Décrire les étapes intermédiaires |
| Fin ratée | Convergence trop faible | Fixer la composition finale |
| Musique indésirable | Pistes audio mélangées | Définir explicitement la musique |
| Modifications du texte | Texte non préservé à l'identique | Citer textuellement les éléments visibles |
| Impression de précipitation | Trop d'événements | Réduire les actions (beats) |
Un principe utile consiste à mener un test comparatif lorsque deux modes peuvent résoudre une même tâche, plutôt que de supposer par défaut que le mode le plus complexe générera systématiquement le meilleur clip.
Un workflow de test H3 méthodique, étape par étape
Commencez par définir le critère de validation de la génération : l'identité du personnage prime peut-être, ou bien l'étiquette du produit, la transition finale, l'attribution des dialogues ou le mouvement de caméra qui doivent impérativement être respectés.
Procédez ensuite par couches successives : validez d'abord le personnage et le décor ; intégrez ensuite le mouvement et la caméra ; ajoutez la voix et le son une fois le comportement visuel stabilisé ; introduisez de nouvelles coupes, des storyboards ou des personnages supplémentaires seulement lorsque la version simplifiée fonctionne. La régénération en haute résolution doit intervenir après validation du résultat sémantique, car une résolution accrue ne peut résoudre des relations de référence contradictoires.
Cette approche par étapes s'avère particulièrement pertinente pour les pipelines vidéo industriels. Pour les workflows qui convertissent des connaissances récurrentes ou du contenu professionnel en vidéos — à l'instar des outils de formation de document à vidéo comme Leadde —, dissocier la structure du contenu, le comportement visuel, la narration par IA et le rendu final simplifie l'isolation des corrections, évitant d'avoir à reconstruire l'ensemble de la production à chaque modification.
Conservez les plans réussis au lieu de tout régénérer
Sur les projets de plus grande envergure, traitez chaque clip réussi comme un actif de production validé. Si le plan 1 et le plan 2 fonctionnent mais que le plan 3 échoue, régénérez uniquement la portion défaillante au lieu de jeter tout ce qui a été fait en amont.
Les workflows communautaires H3 adoptent déjà cette approche par points de contrôle (checkpoints) : dès qu'une séquence satisfaisante est enregistrée, les expérimentations suivantes peuvent être relancées sans réitérer systématiquement le coût informatique et créatif de la recréation des éléments initiaux.
Cette logique mène à un principe de production plus global :
Générer → valider → sauvegarder → continuer.
En matière de vidéo par IA, le prompt engineering finit par se transformer en workflow engineering.
Conclusion
L'art du prompt sur MiniMax H3 donne sa pleine mesure lorsque la tâche est structurée avec rigueur plutôt que simplement développée au fil de descriptions textuelles pléthoriques. Sélectionnez le mode le plus simple adapté au plan, décrivez les variations observables, séparez les attributs fixes des variables, attribuez un rôle précis à chaque référence et dépannez le processus couche par couche. Dans le cadre de workflows Ref2VA avancés, la vraie valeur ajoutée réside dans la clarté des relations entre personnages, mouvements, caméra, audio et images clés — pour ensuite convertir les générations réussies en briques réutilisables pour le plan suivant.