Guida ai Prompt MiniMax H3: Come Scrivere Prompt Migliori per Video, Ref2VA, Fotocamera, Audio e Riferimenti
Un prompt efficace per MiniMax H3 deve definire molto più del semplice stile visivo. Deve spiegare cosa succede nel tempo, come si muove la macchina da presa, quali dettagli devono rimanere coerenti, cosa apporta ciascun elemento di riferimento e come dialoghi, suoni e musica si integrano nella sequenza. Per un controllo superiore, la chiave sta nello scegliere la modalità H3 giusta, descrivere i cambiamenti osservabili e assegnare a ogni riferimento un ruolo chiaro.
Questa guida analizza T2VA, I2VA, FL2VA, L2VA, Ref2VA, il controllo della camera, l'audio, la coerenza dei personaggi e la risoluzione pratica dei problemi. Questi principi si applicano anche ai flussi di lavoro video basati su IA strutturata come Leadde, in cui documenti, materiali di formazione e informazioni sui prodotti vengono trasformati in video scalabili completi di narrazione, avatar e output multilingue.
Guida ai prompt per MiniMax H3: qual è la struttura ideale?
Il modo migliore per concepire un prompt per MiniMax H3 è considerarlo come un briefing di produzione audiovisiva. Invece di accumulare parole come "cinematografico", "realistico" e "drammatico", descrivi ciò che lo spettatore può effettivamente vedere e sentire man mano che la clip si sviluppa, per capire come realizzare video realistici con l'IA.
La formula semplice per i prompt H3
Per i prompt di tutti i giorni, parti da:
Soggetto + Azione + Ambiente + Camera + Tempistica + Audio
Ad esempio, "una donna in una stazione ferroviaria piovosa" definisce una scena, ma non fornisce molte informazioni temporali. Un prompt più efficace spiega che la donna cammina verso la banchina, si ferma quando sente un treno in arrivo, si gira verso il suono mentre una telecamera in lento tracking la segue.
La Guida ufficiale ai prompt di base di MiniMax formalizza questo concetto con tre campi: integrated_multimodal_description, overall_soundscape e non_diegetic_music. Il primo contiene la timeline visiva, le azioni, le inquadrature, i parlanti, i dialoghi e l'audio di scena sincronizzato; gli altri due separano i suoni ambientali/fisici dalla musica di sottofondo riservata al pubblico.
Scrivi risultati osservabili, non solo aggettivi
Una regola utile consiste nel convertire le intenzioni astratte in comportamenti visibili.
Invece di "appare sicura di sé", descrivila mentre cammina con passo deciso, mantiene il contatto visivo, si sistema la giacca e si ferma senza esitazione.
Lo stesso approccio aiuta a gestire i vincoli. Invece di ripetere "non fare zoom in", descrivi il risultato desiderato: "il soggetto mantiene approssimativamente le stesse dimensioni nell'inquadratura dall'inizio alla fine". Un test di coerenza H3 della community ha evidenziato che i vincoli di inquadratura misurabili funzionano meglio in quel particolare flusso di lavoro rispetto al ripetere un'istruzione negativa per la camera. Questa è un'osservazione pratica basata sull'esperienza, non una garanzia ufficiale di MiniMax.
Quale modalità MiniMax H3 dovresti usare?
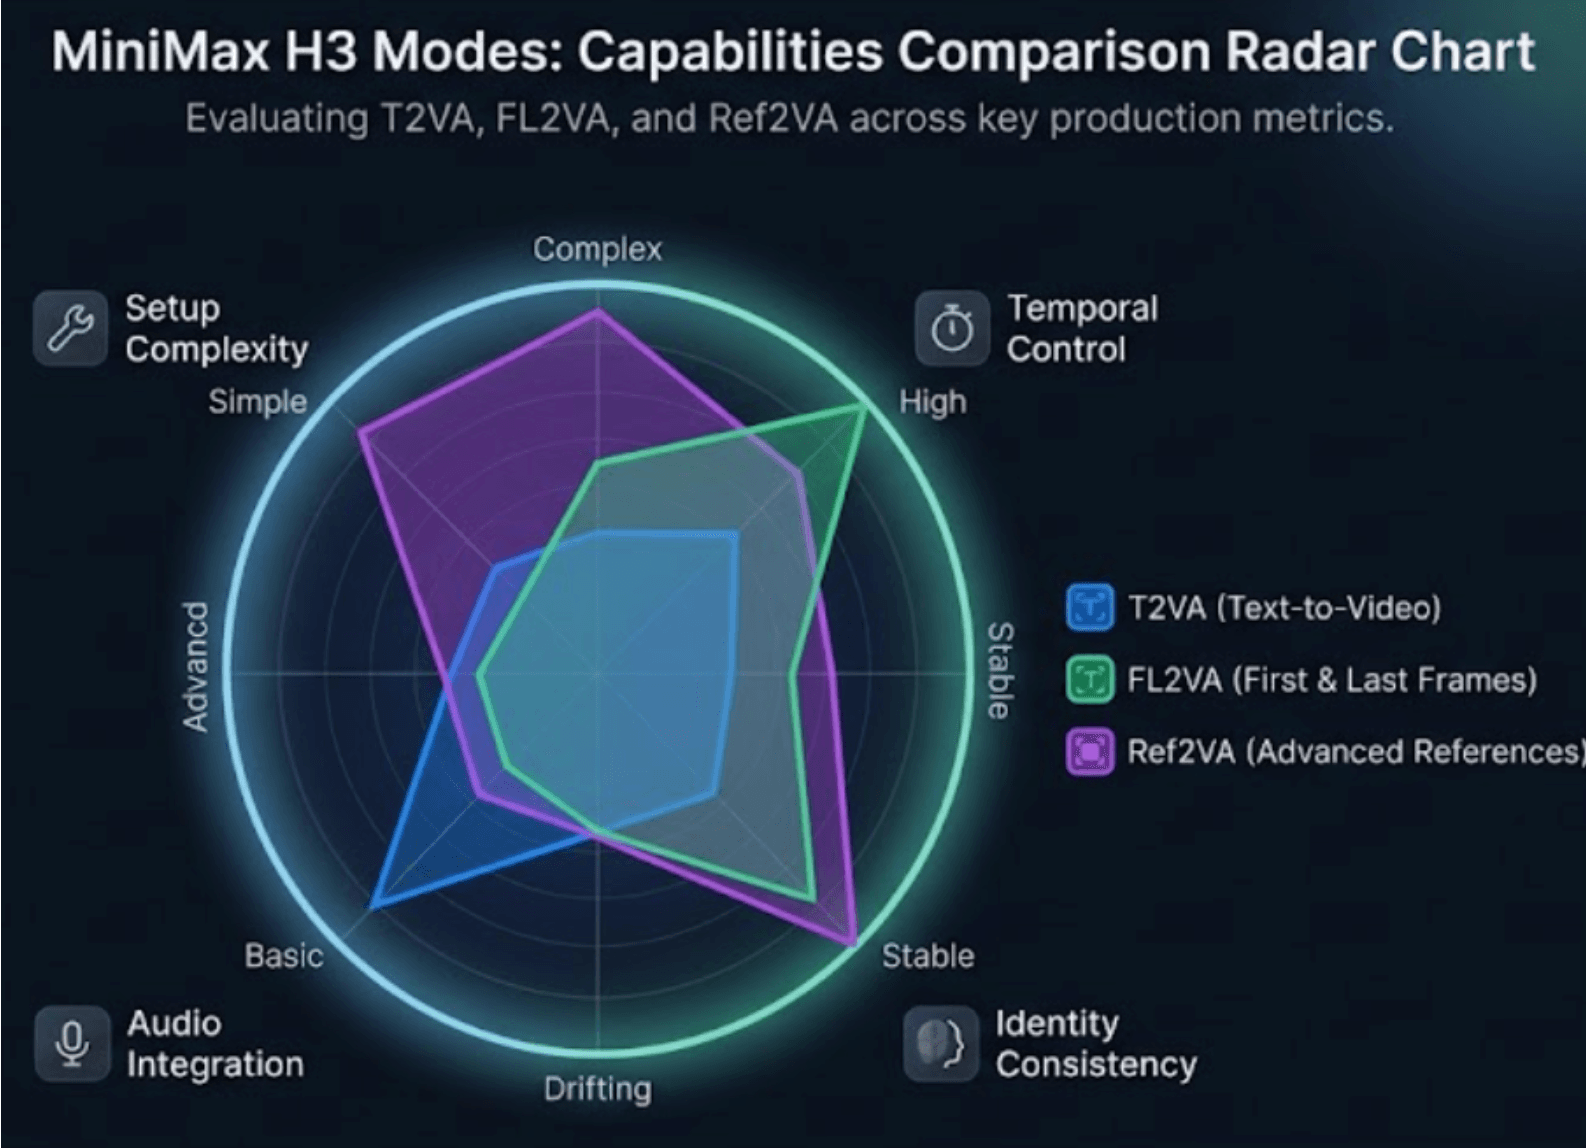
Scegliere la modalità corretta può essere tanto importante quanto riscrivere il prompt. Il flusso di lavoro di base di MiniMax supporta la generazione solo testo e le attività basate su primo fotogramma, ultimo fotogramma e primo e ultimo fotogramma, mentre il checkpoint separato Ref2VA gestisce la generazione da riferimenti multimodali.
| Modalità | Input | Obiettivo principale del prompt |
| T2VA | Testo | Costruire l'intera scena audiovisiva |
| I2VA | Primo fotogramma | Preservare l'apertura e sviluppare l'azione in avanti |
| FL2VA | Primo + ultimo fotogramma | Descrivere la transizione tra i punti finali |
| L2VA | Ultimo fotogramma | Costruire la scena a partire dal finale fornito |
| Ref2VA | Immagini/video/audio | Combinare diversi ruoli di riferimento |
T2VA, I2VA, FL2VA e L2VA
T2VA deve costruire la scena da zero. I2VA considera l'immagine fornita come il primo fotogramma effettivo, quindi il prompt deve preservare identità, abbigliamento, oggetti, colori e composizione prima di introdurre il movimento.
Con FL2VA, il prompt non deve limitarsi a descrivere la Prima e la Seconda Immagine. MiniMax consiglia specificamente di descrivere il percorso osservabile tra di esse: come si muove il soggetto, come cambiano le pose, come vengono manipolati gli oggetti e come la composizione o l'illuminazione convergono sul fotogramma finale. L2VA inverte il processo di ragionamento partendo da uno stato precedente plausibile per arrivare gradualmente all'ultimo fotogramma fornito.
Quando dovresti usare Ref2VA?
Usa Ref2VA quando risorse diverse svolgono compiti differenti: ad esempio, un'immagine definisce un personaggio, un'altra l'abbigliamento, un video fornisce il movimento della camminata e il ritmo della telecamera, e l'audio fornisce un riferimento vocale.
Questo concetto è meglio inteso come generazione basata sulle relazioni. Il modello deve sapere non solo cosa contiene ciascun file, ma anche come le informazioni di ogni sorgente debbano influenzare il video finale. Il formato di riferimento completo di MiniMax distingue esplicitamente soggetti riutilizzabili, àncore visive concrete, sorgenti temporali a livello di video e riferimenti audio.
Usa la modalità più semplice in grado di risolvere l'inquadratura
Una regola pratica di produzione è: non aggiungere complessità di riferimento a meno che l'inquadratura non lo richieda.
Se una transizione necessita solo di un'apertura e di una chiusura precise, FL2VA fornisce una definizione diretta per il compito. Passa a Ref2VA quando hai realmente bisogno di relazioni come identità dall'Immagine 1 + movimento dal Video 1 + voce dall'Audio 1.
Questo rende anche il debugging più semplice. Quando ci sono meno vincoli indipendenti in competizione tra loro, è più facile capire se il problema deriva dal movimento, dall'identità, dall'inquadratura o dall'audio.
Come controllare inquadrature, movimenti di camera, tempistiche e transizioni?
I prompt H3 diventano più facili da controllare quando la timeline viene trattata come un montaggio anziché come un paragrafo.
Tagli di inquadratura, timestamp e budget temporale
Il formato ufficiale di MiniMax non utilizza i timestamp del tipo [Shot 1]. Le inquadrature successive iniziano con tempi di taglio crescenti, ad esempio [Shot 2] At 00:03.500. Una nuova inquadratura dovrebbe introdurre nuove informazioni significative, come un punto di vista, una posizione, uno stato, un soggetto o un momento differenti. Una piccola variazione di distanza o angolazione si esprime solitamente meglio tramite un movimento di camera anziché con un altro stacco.
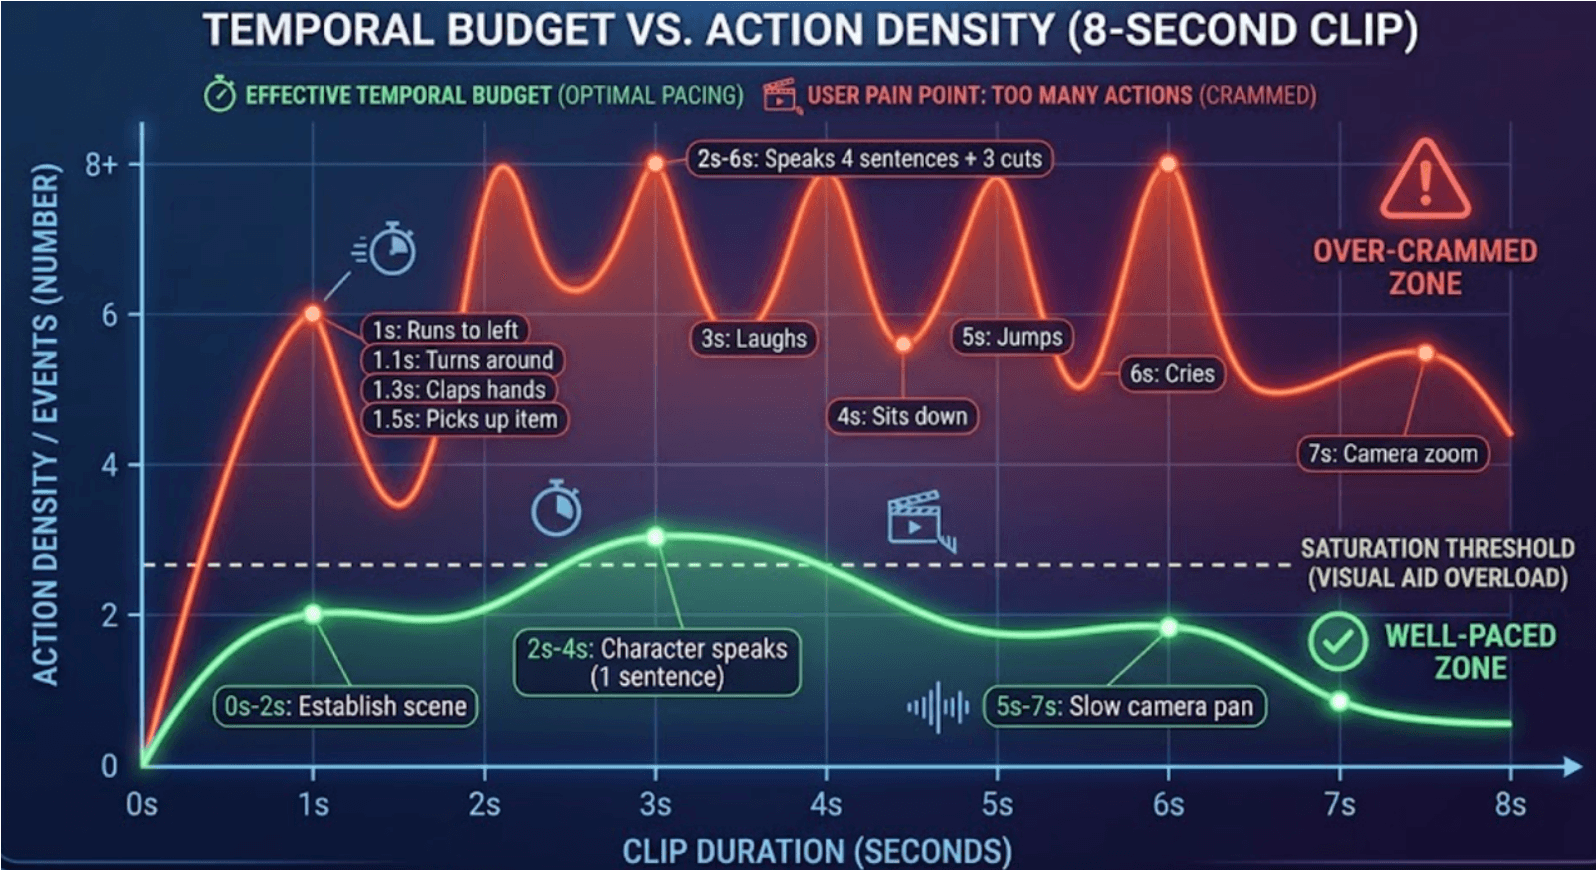
Questo crea un budget temporale pratico. In una clip di 8 secondi, tre azioni, due movimenti di camera, una reazione, una frase parlata e due tagli competono tutti per la stessa durata limitata. Quando una generazione risulta frenetica, rimuovere eventi funziona spesso meglio che aggiungere ulteriore linguaggio descrittivo.
Linguaggio di camera supportato da H3
I documenti di MiniMax descrivono operazioni di camera tra cui push/pull, pan, truck, tilt, pedestal, arc, tracking, inquadrature fisse, POV, roll e camera shake. La logica consigliata è essenzialmente:
Tipo di movimento + Ampiezza opzionale + Velocità opzionale
Quindi, anziché "dinamica macchina da presa cinematografica", scrivi qualcosa di azionabile, come "la telecamera si sposta lentamente a destra mantenendo il prodotto al centro".
Separa ciò che deve rimanere fisso da ciò che può cambiare
Prima di procedere con la generazione, crea una semplice mappa mentale di elementi fissi e variabili.
Un video di prodotto potrebbe richiedere che la forma della bottiglia, il testo dell'etichetta, il tappo e il colore rimangano fissi, mentre la posizione della telecamera, i riflessi, il movimento dell'acqua e l'illuminazione cambiano. Una sequenza con un personaggio può bloccare volto, acconciatura e abbigliamento, consentendo però a postura ed espressione di evolversi.
Questo riduce le istruzioni contraddittorie, poiché il prompt non chiede più a ogni proprietà visiva di cambiare contemporaneamente.
Come usare i riferimenti senza perdere la coerenza di personaggi o prodotti?
I flussi di lavoro di riferimento più efficaci assegnano a ciascuna risorsa uno scopo specifico.
Assegna a ogni riferimento un ruolo chiaro
Una mappatura pratica potrebbe essere la seguente:
Immagine 1 → identità del personaggio Immagine 2 → abbigliamento Immagine 3 → design del prodotto Video 1 → movimento della camminata e percorso della telecamera Audio 1 → timbro vocale
Il formato ufficiale Ref2VA di MiniMax supporta esattamente questo tipo di definizione multi-sorgente: un soggetto può acquisire l'aspetto da un'immagine e il movimento da un video, mentre un singolo file di riferimento può anche fornire più soggetti riutilizzabili.
La parte importante è evitare trasferimenti accidentali. Se il Video 1 deve fornire il movimento ma non il suo attore o l'ambiente, dillo esplicitamente nella progettazione delle relazioni.
Soggetti, immagini, storyboard e video di riferimento
Nella terminologia ufficiale, <Subject N> rappresenta il contenuto visibile riutilizzabile, mentre <Picture N> viene utilizzato quando un'immagine funge direttamente da fotogramma concreto, àncora di composizione o riferimento per sceneggiatura e storyboard video. <Video N> rappresenta relazioni a livello di intero video come montaggio, continuazione, movimento di camera, tagli, ritmo o struttura temporale. <Audio N> gestisce la copia audio o caratteristiche come il timbro vocale, l'intonazione, il ritmo o lo stile musicale.
Questa distinzione previene un errore concettuale comune: un riferimento di personaggio non è automaticamente un fotogramma chiave e uno storyboard non è automaticamente un punto finale esatto.
Economia dei riferimenti e coerenza a livello di inquadratura
Una maggiore quantità di materiale di riferimento non è automaticamente sinonimo di maggiori informazioni. Nei flussi di lavoro di produzione, taglia un video di riferimento limitandolo alla porzione che mostra chiaramente il movimento, il percorso della telecamera o la qualità vocale di cui hai bisogno.
Valuta inoltre l'identità nel corso dell'intera inquadratura e non solo nel primo fotogramma. Un test della community ha riscontrato una deriva dell'identità notevolmente più precoce nei primi piani rispetto alle inquadrature a figura intera o con volti più piccoli, nell'ambito della specifica configurazione locale di quell'utente. Le tempistiche esatte non dovrebbero essere generalizzate, ma la lezione per il flusso di lavoro è utile: verifica l'identità del volto, l'abbigliamento e i piccoli oggetti di scena in diversi punti di ogni inquadratura importante.
Come funzionano Ref2VA avanzato, dialoghi e prompt audio?
Ref2VA è il punto in cui la creazione di prompt H3 si avvicina di più alla pianificazione di una produzione multimodale rispetto ai tradizionali prompt da testo a video.
La struttura in sei parti del prompt Ref2VA
La guida di riferimento completo di MiniMax definisce sei sezioni:
subject_definitions → summary → retention_analysis → detailed_description → overall_soundscape → non_diegetic_music.
Il sistema definisce prima il significato dei riferimenti, poi riassume l'attività, spiega come ciascun riferimento viene preservato o trasferito e infine scrive il video di destinazione nell'ordine di riproduzione.
Un livello di pianificazione utile prima di scrivere il prompt formale è il seguente:
| Sorgente | Preserva | Trasferisci | Ignora |
| Immagine 1 | Volto, capelli | — | Sfondo |
| Video 1 | — | Camminata, camera | Identità dell'attore |
| Audio 1 | Timbro vocale | Espressione | Dialogo originale |
Questo trasforma una richiesta vaga come "usa tutti questi riferimenti" in relazioni esplicite da sorgente a destinazione.
Dialoghi, voce, effetti sonori e musica
I personaggi che parlano utilizzano ID stabili come (S1) e (S2), mentre i dialoghi sono racchiusi tra i tag <d>[Language] ...</d>. MiniMax distingue anche tra dialoghi in-screen e voce fuori campo (voiceover), e consiglia di mantenere esplicitamente chiuse le labbra di un personaggio sullo schermo quando quel personaggio sta solo narrando.
I suoni ambientali e gli effetti fisici appartengono al paesaggio sonoro (soundscape), mentre non_diegetic_music è riservata alla musica ascoltata dal pubblico anziché dai personaggi. Se desideri passi, pioggia e suoni di oggetti ma nessuna colonna sonora, mantieni il paesaggio sonoro e imposta non_diegetic_music: N/A.
Prompt in linguaggio naturale vs Prompt strutturato ufficiale
Le brevi istruzioni in linguaggio naturale possono comunque funzionare nel sistema H3 ospitato, poiché MiniMax utilizza H3-Context-IR, un livello di pre-elaborazione che interpreta le relazioni tra testo, immagini, video e audio prima di produrre una rappresentazione strutturata per H3-Base. La scheda del modello aperto descrive l'analisi delle istruzioni, l'associazione multimodale, la comprensione temporale e il ragionamento logico come parte di tale processo.
Questo spiega un'apparente contraddizione: i prompt semplici possono essere adatti per generazioni ospitate e lineari, mentre i prompt strutturati diventano più preziosi per attività di produzione precise che coinvolgono più riferimenti, dialoghi, tempistiche e risultati ripetibili.
Perché MiniMax H3 ignora i prompt e qual è il flusso di test ideale?
Quando una generazione fallisce, riscrivere tutto in una volta rende più difficile individuarne la causa.
Problemi comuni dei prompt H3 e relative soluzioni
| Problema | Causa probabile | Primo test da effettuare |
| Parla la persona sbagliata | Mappatura dei parlanti non chiara | Blocca (S1)/(S2) |
| Il personaggio cambia | Segnali di identità in conflitto | Semplifica i riferimenti |
| Riferimento ignorato | Il ruolo è ambiguo | Assegna un solo ruolo |
| Tagli casuali | Troppe istruzioni di inquadratura | Usa il movimento di camera |
| Timestamp ignorato | Usato come tempistica delle azioni | Riservalo esclusivamente ai tagli |
| Salti in FL2VA | Percorso di transizione mancante | Descrivi i cambiamenti intermedi |
| Il finale non torna | Convergenza debole | Blocca la composizione finale |
| Musica indesiderata | Livelli audio mescolati | Imposta la musica in modo esplicito |
| Il testo cambia | La dicitura non è stata preservata | Cita esattamente il testo visibile |
| Il video risulta frenetico | Troppi eventi contemporanei | Riduci i passaggi chiave |
Un principio utile consiste nell'eseguire un confronto controllato quando due modalità possono risolvere lo stesso compito, invece di dare per scontato che la modalità più complessa produca sempre la clip migliore.
Un flusso di lavoro per i test H3 pratico e graduale
Inizia definendo il criterio di accettazione per la generazione: forse l'identità del personaggio è l'aspetto più importante, oppure l'etichetta del prodotto, la transizione finale, la proprietà del dialogo o il movimento della telecamera sono elementi non negoziabili.
Procedi quindi per livelli: stabilisci prima il personaggio e la scena; aggiungi successivamente il movimento e la telecamera; inserisci voce e suono solo dopo che il comportamento visivo è stabile; introduci tagli extra, storyboard o personaggi aggiuntivi solo dopo che la versione più semplice funziona. La rigenerazione ad alta risoluzione dovrebbe avvenire dopo che il risultato semantico è corretto, poiché una risoluzione più elevata non può risolvere relazioni di riferimento contraddittorie.
Questo approccio graduale è particolarmente utile nelle pipeline video scalabili. Per i flussi di lavoro che trasformano conoscenze ripetibili o contenuti aziendali in video, inclusi gli strumenti di formazione da documento a video come Leadde, separare la struttura dei contenuti, il comportamento visivo, la narrazione IA e il rendering finale rende le revisioni più facili da isolare, evitando di dover ricostruire l'intera produzione ogni volta.
Salva le inquadrature riuscite invece di rigenerare tutto
Per i progetti più lunghi, tratta ogni clip riuscita come un asset di produzione validato. Se l'Inquadratura 1 e l'Inquadratura 2 funzionano ma l'Inquadratura 3 fallisce, rigenera solo la sezione difettosa anziché scartare tutto il lavoro precedente.
I flussi di lavoro H3 della community utilizzano già inquadrature basate su checkpoint proprio per questo motivo: una volta salvata una sezione riuscita, è possibile rieseguire gli esperimenti successivi senza dover pagare ripetutamente il costo computazionale e creativo di ricreare il materiale precedente.
Ciò porta a un principio di produzione più ampio:
Genera → valida → salva → continua.
Nel campo dei video generati con l'IA, il prompt engineering si trasforma col tempo in workflow engineering.
Conclusione
La creazione di prompt per MiniMax H3 offre i risultati migliori quando il compito è chiaramente strutturato anziché semplicemente descritto con un numero maggiore di parole. Scegli la modalità più semplice adatta all'inquadratura, descrivi i cambiamenti osservabili, separa gli attributi fissi da quelli variabili, assegna a ogni riferimento un ruolo specifico ed effettua il debug un livello alla volta. Per i flussi di lavoro Ref2VA avanzati, il vero vantaggio deriva dal rendere esplicite le relazioni tra personaggi, movimento, telecamera, audio e fotogrammi chiave, trasformando poi le generazioni riuscite in blocchi di costruzione riutilizzabili per l'inquadratura successiva.