AI 동영상 더빙: 작동 원리와 2026년 최고의 추천 툴
AI 영상 더빙은 영상을 번역하여 원래의 음성을 타겟 언어의 동기화된 합성 보이스오버로 대체하는 자동화 프로세스로, 화자의 목소리 고유 특성, 말하기 속도, 감정선까지 그대로 유지합니다. 글로벌 기업과 디지털 교육 전문가들에게 이는 스튜디오 예약, 성우 캐스팅, 수동 타임라인 편집 등 전통적인 제작 과정의 병목 현상을 완전히 없애줍니다.
교육 설계 관점에서, 교육 및 제품 팀은 기존 문서를 영상 자산으로 변환하는 데 엄청난 노력을 쏟지만, 이를 해외 시장에 현지화할 때 또다시 장벽에 부딪히곤 합니다. 현대의 AI 비디오 워크플로우는 이러한 운영상의 공백을 메워줍니다. Leadde 같은 플랫폼을 활용하면 팀은 SOP 문서를 몇 분 만에 교육 영상으로 전환하고 슬라이드 덱을 기본 자산으로 자동 변환할 수 있으며, 통합된 AI 더빙 기능을 통해 몇 주가 아닌 몇 분 만에 글로벌 청중을 위한 영상 현지화를 확장할 수 있습니다.
이 가이드에서는 최신 음성 합성 기술의 이면을 이루는 기술 아키텍처를 살펴보고, 기업 및 교육 콘텐츠를 위한 주요 더빙 플랫폼을 비교하며, 교육적 명확성을 대규모로 유지하면서 자동화된 현지화 워크플로우를 구현하는 방법을 알아봅니다.
AI 영상 더빙: 무엇이며 콘텐츠 팀에 왜 필요한가?
AI 영상 더빙 툴은 인공지능을 활용해 기존 영상 자산의 오디오를 자동으로 전사, 번역하고 새로운 보이스오버를 생성해 주는 소프트웨어 플랫폼입니다. 고급 플랫폼은 음성 복제 기술을 활용해 화자의 원래 어조, 속도, 음성적 특징을 유지하며, 이를 통해 현지 시청자에게 이질감 없는 자연스러운 콘텐츠를 제공합니다.
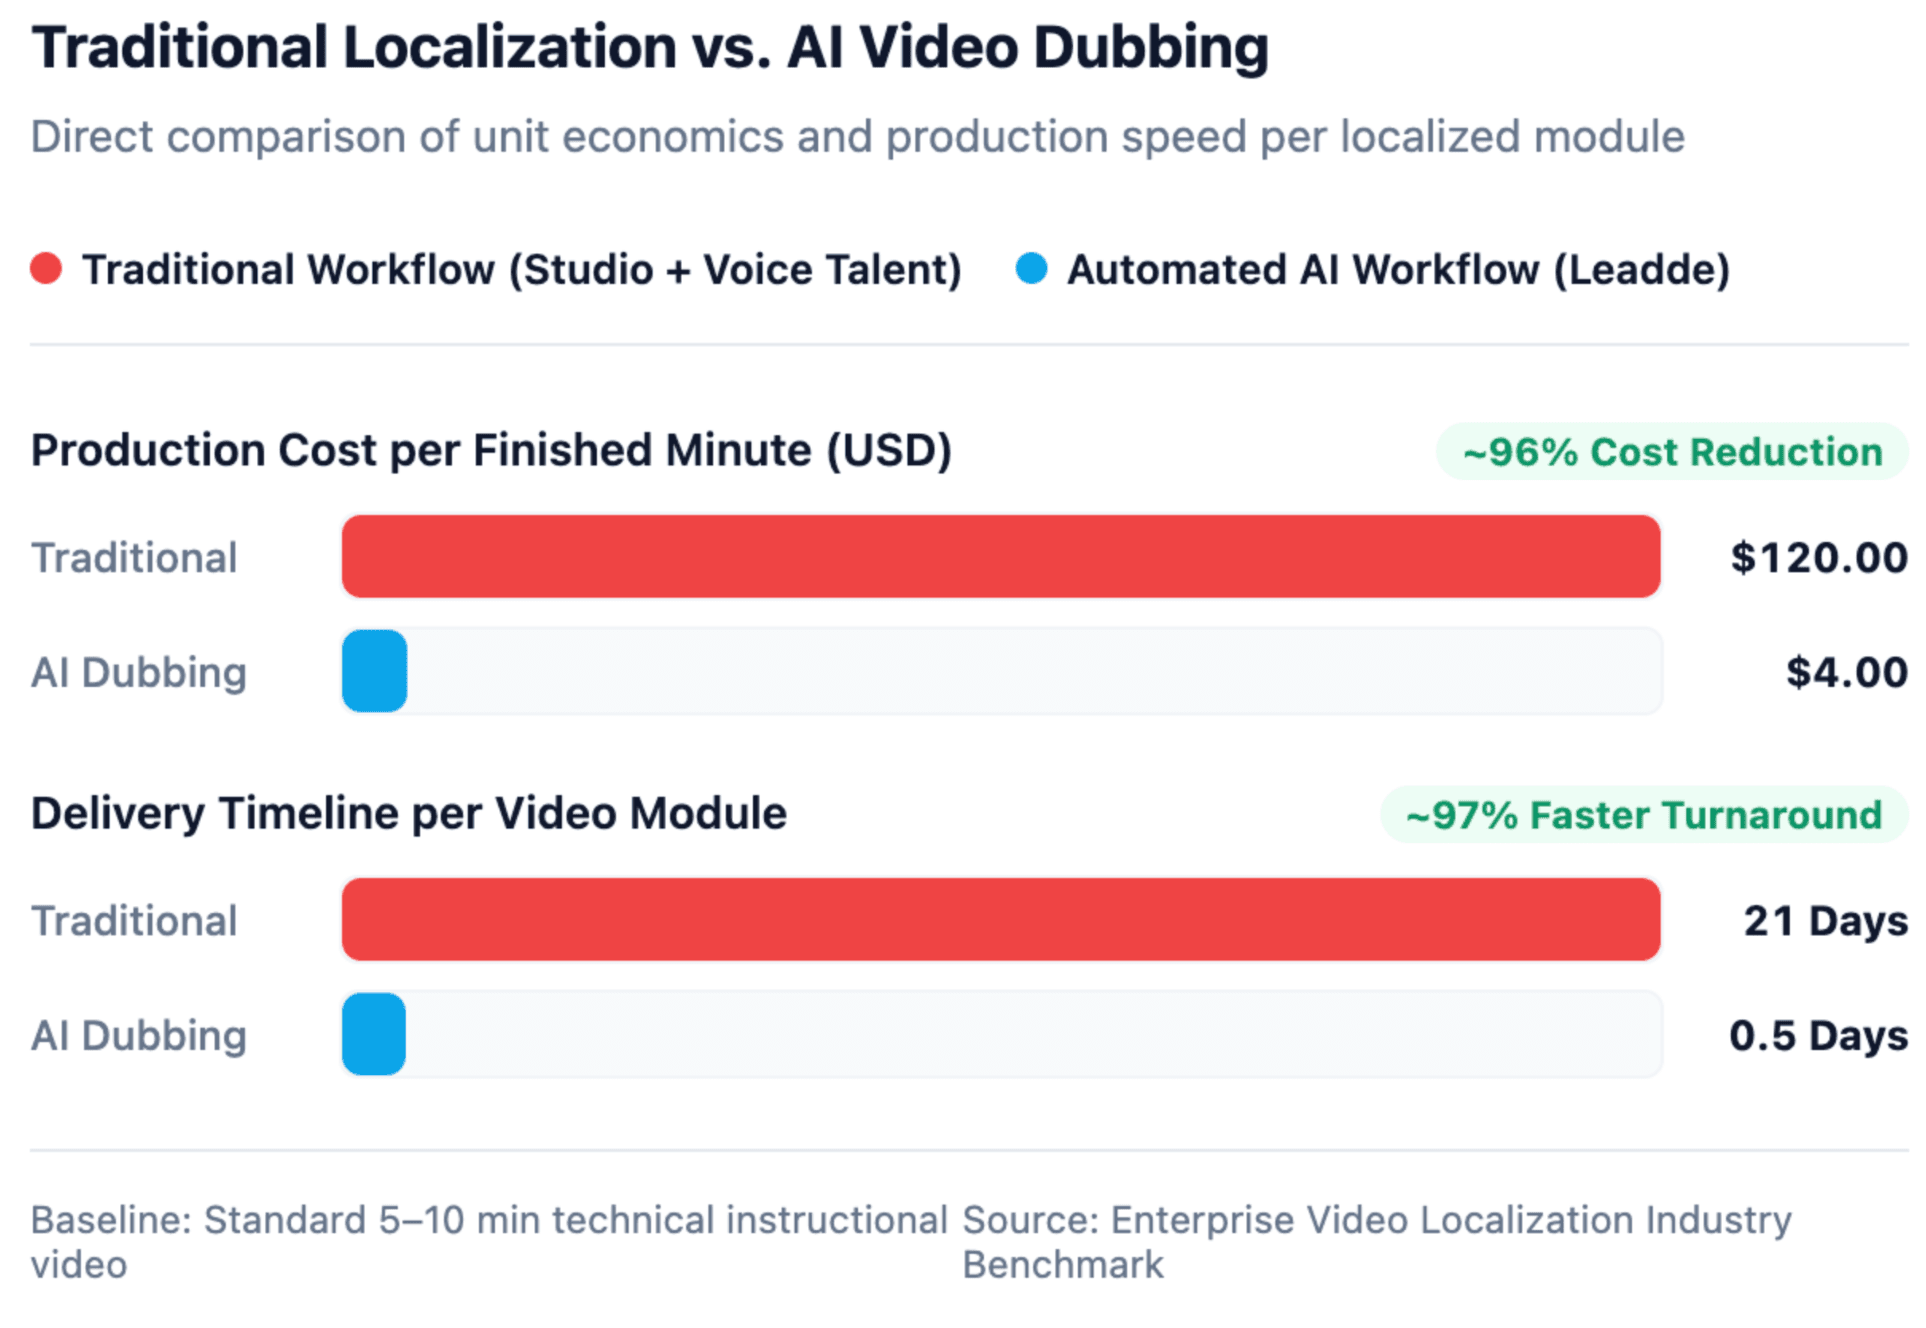
교육 설계 관점에서 볼 때, 전사·번역·녹음·재편집으로 이어지는 기존의 현지화 주기는 글로벌 교육 배포에 있어 심각한 병목 현상을 야기합니다. 콘텐츠 팀은 교육적 정확성을 희생하지 않으면서도 현지화된 미디어를 신속하게 제공해야 한다는 압박에 직면해 있습니다. 전통적인 방식은 높은 감정 제어력을 보장하지만, 현대의 방대한 비디오 라이브러리를 확장하는 데는 비용 및 운영 측면에서 지속 가능하지 않습니다. AI 영상 더빙은 이러한 반복적인 제작 단계를 자동화하여 조직이 글로벌 시장에 맞게 영상 콘텐츠를 조정하고 적은 비용으로 브랜드 일관성을 유지할 수 있도록 지원합니다.
AI 영상 현지화 프로세스는 실제로 어떻게 작동할까?
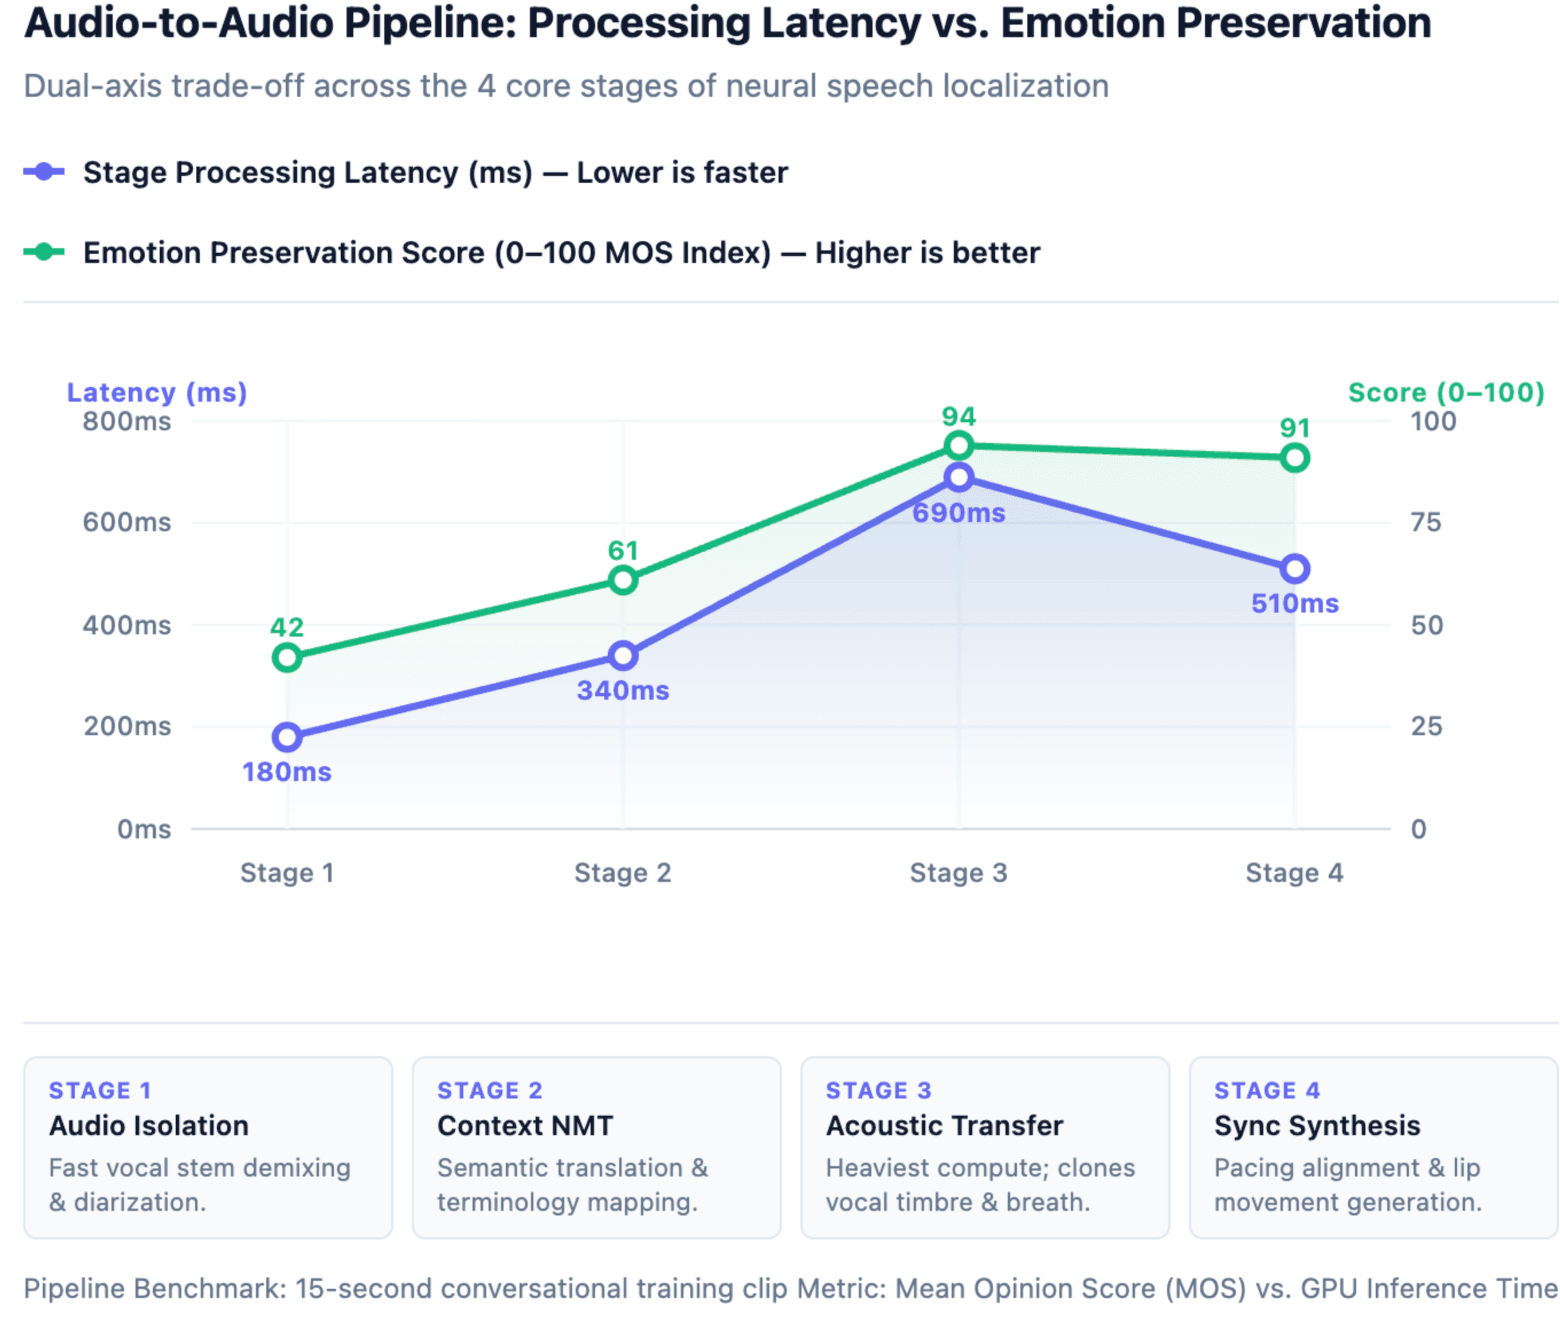
전문적인 영상 워크플로우에서 시각적 흐름을 방해하지 않고 오디오를 매끄럽게 교체하려면 동기화된 기술 파이프라인이 필수적입니다. 초기 텍스트 음성 변환 툴은 로봇 같은 소리를 냈으며, 중요한 배경 오디오를 자주 덮어쓰곤 했습니다. 하지만 오늘날의 AI 모델은 음성 레이어만 정밀하게 분리하여 배경 음악과 주변 소음이 그대로 유지되도록 보장합니다.
음성 인식 및 화자 분리(Diarization)
AI 엔진은 배경 소음에서 주 음성 레이어를 분리하고, 음성을 정확하게 전사하며, 동일 영상 내에 등장하는 여러 명의 서로 다른 화자를 정확히 식별(화자 분리)합니다. 이렇게 추출된 초기 텍스트가 현지화의 기초가 되는 대본을 형성합니다.
맥락 인지형 현지화
단순한 직역에서 벗어나, 첨단 AI는 현지 청중에게 자연스럽게 들리도록 표현, 관용구, 전문 용어를 유연하게 조정합니다. 전문 플랫폼을 통해 팀은 이 텍스트를 검토하고 편집하여 교육적 오류가 연쇄적으로 발생하는 것을 방지할 수 있으며, 이는 기업 워크플로우를 위한 전용 영상 번역기 역할을 합니다.
오디오-투-오디오 음성 복제
텍스트 대본만으로 목소리를 생성하는 대신, 최신 생성 모델은 소스 오디오의 실제 연기 데이터를 바탕으로 결과물을 도출합니다. AI는 숨소리 패턴, 미세한 일시 정지, 감정적 억양을 포착하여 AI 목소리를 만드는 방법에 대한 최신 기술적 혁신을 기반으로 구축되며, 이러한 음성적 뉘앙스를 번역된 언어에 그대로 매핑합니다.
타이밍 및 시각적 동기화
번역된 문장은 언어별로 길이가 다릅니다(예: 독일어 번역은 보통 영어보다 깁니다). 따라서 AI는 원본 영상의 시각적 단서, 슬라이드 전환, 입모양에 맞춰 생성된 오디오의 속도를 동적으로 조절합니다.
크리에이터와 기업을 위한 최고의 AI 더빙 툴은 무엇인가요?
커뮤니케이션 목표에 따라 필요한 현지화 전략은 다릅니다. 정적 PDF를 글로벌 컴플라이언스 영상으로 변환하려는 교육자의 소프트웨어 요구사항은 짧은 홍보용 브이로그를 더빙하는 소셜 미디어 매니저의 요구사항과 판이하게 다릅니다.
| 옵션 | 최적 용도 | 장점 | 한계 |
| Leadde | 교육 및 트레이닝 영상 | 문서-영상 워크플로우에 특화; PDF, SOP, 슬라이드를 88개 언어와 175개 방언의 구조화된 현지화 교육 영상으로 변환합니다. | 단독 소셜 미디어 편집보다는 확장 가능한 기업 및 교육 콘텐츠에 집중되어 있습니다. |
| ElevenLabs | 감성 오디오 현지화 | 업계 최고 수준의 자연스러운 음성 복제 및 오디오-투-오디오 감정 전달; 90개 이상의 언어와 억양 지원. | 오디오 중심 파이프라인으로, 시각적 립싱크가 필요한 경우 외부 툴이 필요합니다. |
| HeyGen | 프레젠터 시각 현지화 | 토킹 헤드 영상을 위한 고정밀 시각적 립싱크 및 강력한 맞춤형 AI 아바타 생성 기능. | 프리미엄 더빙 및 립싱크 기능은 별도의 크레딧을 소모하며, 긴 영상에서는 싱크가 틀어질 수 있습니다. |
| Canva (EasyDubbing) | 빠른 마케팅 영상 | Canva 에디터에 직접 통합됨; 소셜 미디어 콘텐츠를 위한 빠른 원클릭 번역 및 음성 복제. | 숏폼 클립에 가장 적합하며, 심층적인 기업 학습 관리 시스템 연동 기능이 부족합니다. |
확장 가능한 문서-영상 더빙 워크플로우를 구현하는 방법은?
교육 팀은 현지화를 시작하기도 전에 문서와 프레젠테이션을 영상으로 변환하는 데 상당한 시간을 쏟습니다. 언어 변환마다 수동으로 녹음하는 방식은 시대에 뒤떨어지며 확장 불가능한 접근 방식입니다.
문서로부터 기본 영상 생성
사람 프레젠터가 처음부터 녹음하는 대신, Leadde와 같은 AI 영상 생성기를 사용하여 PDF 매뉴얼을 교육 영상으로 변환하는 방법이나 Word SOP 같은 기존 조직 지식을 불러옵니다. 플랫폼은 문서를 논리적 장면에 맞게 자동으로 구조화하고, 교육용 스크립트를 생성하며, 초기 AI 프레젠터와 보이스오버를 적용합니다.
소스 대본 검토하기
더빙 프로세스를 시작하기 전에, 콘텐츠 팀은 기본 대본을 수동으로 검토해야 합니다. 소스 언어에서 잘못 인식된 전문 용어나 고유 약어를 미리 바로잡으면 여러 타겟 언어로 오류가 증폭되는 것을 막을 수 있습니다.
복제된 목소리 적용 및 대규모 현지화
승인된 기본 영상을 더빙 엔진에 통과시켜 AI 강사의 목소리와 감정적 어조가 유지되도록 합니다. 현지화된 결과물을 검토하고, 완전한 접근성 준수를 위해 생성된 다국어 자막(SRT 파일)과 함께 최종 영상을 내보냅니다. 이를 통해 분산된 팀 전반에서 AI 영상 툴로 글로벌 교육을 동기화할 수 있습니다.
다국어 영상 확장의 흔한 과제는 무엇인가요?
AI 영상 생성의 채택이 늘고 있지만, 많은 크리에이터와 교육자들은 자연스러운 전달력과 시각적 일관성을 유지하는 어려움 속에서 사람들이 현실적인 AI 영상을 만드는 방법을 모색하고 있습니다. 이러한 한계를 이해하는 것은 확장 가능한 워크플로우를 구축하는 데 매우 중요합니다.
롱폼 콘텐츠의 립싱크 싱크 어긋남 해결
많은 AI 시각적 더빙 툴은 긴 롱테이크 샷에서 어려움을 겪으며, 몇 분이 지나면 시각적 싱크가 어긋나거나 오디오와 입모양이 일치하지 않는 현상이 발생합니다. 이를 완화하기 위해 전문가들은 긴 영상을 관리 가능한 단위로 나누어 처리하거나, B-롤 및 프레젠테이션 슬라이드를 전략적으로 활용하여 프레젠터의 얼굴에서 화면을 전환합니다.
언어 확장 및 인지 부하 관리
기술 콘텐츠를 영어에서 독일어 또는 스페인어로 번역할 때 텍스트 확장은 자연스럽게 발생합니다. AI 툴이 압축된 시간 창에 더 긴 번역을 억지로 우겨넣으면 발화가 부자연스럽게 빨라져 학습자의 인지 부하가 크게 증가합니다. 교육 디자이너는 오디오를 인위적으로 빠르게 재생하는 대신 현지화된 스크립트를 더 간결하게 편집해야 합니다.
다중 화자 분리 처리
자동화된 툴은 빠른 배포에 편리하지만, 여러 사람이 말할 때 서로 다른 목소리를 인식하거나 유지하지 못하는 경우가 많습니다. 패널 토론이나 인터뷰 영상의 경우, 콘텐츠 팀은 보이스 프로필을 병합하지 않고도 여러 고유 화자를 동시에 복제할 수 있는 전용 AI 플랫폼의 화자 분리 기능을 사용해야 합니다.
자주 묻는 질문 (FAQ)
AI 더빙은 원래 화자의 감정을 유지하나요?
네. 현대의 AI 더빙 시스템은 오디오-투-오디오 모델링을 사용합니다. AI는 번역된 텍스트 대본을 기계적으로 읽는 대신, 원본 오디오의 감정적 전달력, 음고, 숨소리 패턴을 분석하여 타겟 언어에도 동일한 억양을 적용합니다.
교육 문서를 더빙된 영상으로 어떻게 변환하나요?
Leadde와 같은 플랫폼은 문서-영상 워크플로우에 특화되어 있습니다. 사용자는 기존 PDF나 프레젠테이션을 업로드하고, AI로 다국어 영상 강의를 단계별로 만드는 방법을 학습한 뒤, 텍스트를 AI 보이스오버가 포함된 구조화된 교육 영상으로 변환하여 여러 언어로 쉽게 번역하고 더빙할 수 있습니다.
AI 더빙은 배경 소음과 음악을 보존할 수 있나요?
네. 최신 AI 더빙 툴은 배경 오디오에서 주 음성 레이어를 분리합니다. 원본 음악, 음향 효과, 주변 소음은 완전히 그대로 유지한 채 음성 단어만 번역된 보이스오버로 교체합니다.
기업 교육에 유튜브 자동 더빙만으로는 부족한 이유는 무엇인가요?
유튜브의 내장 번역 기능은 캐주얼한 배포에는 효율적이지만, 화자의 감정적 억양을 살리지 못하고, 다중 화자 분리에 취약하며, 원본 목소리를 복제하지 못해 기업 교육에 요구되는 전문적 품질을 충족하지 못합니다.
AI 영상 현지화는 기업의 민감한 데이터 관점에서 안전한가요?
엔터프라이즈급 AI 영상 플랫폼은 독점 교육 자료와 복제된 음성 데이터가 공공 AI 모델 학습에 사용되지 않도록 강력한 데이터 프라이버시 통제 기능을 제공합니다. 내부 문서를 업로드하기 전에 항상 플랫폼의 기업 보안 준수 여부를 확인하세요.
AI 영상 더빙은 조직의 글로벌 커뮤니케이션 방식을 완전히 바꾸어 놓았으며, 과거에 비용과 시간이 많이 소모되던 현지화 주기를 민첩하고 자동화된 워크플로우로 탈바꿈시켰습니다. 지능형 문서-영상 생성과 고급 음성 복제, 세심한 품질 검수를 결합함으로써 콘텐츠 팀은 전 세계 시장을 대상으로 매력적인 다국어 교육 라이브러리를 성공적으로 확장할 수 있습니다.