MiniMax H3 Prompt-Leitfaden: So schreiben Sie bessere Video-, Ref2VA-, Kamera-, Audio- und Referenz-Prompts
Ein starker MiniMax H3-Prompt sollte mehr definieren als nur den visuellen Stil. Er muss erklären, was im Laufe der Zeit passiert, wie sich die Kamera bewegt, welche Details konsistent bleiben müssen, was die einzelnen Referenzen beitragen und wie Dialoge, Sound und Musik in die Sequenz passen. Für eine bessere Kontrolle ist es entscheidend, den richtigen H3-Modus zu wählen, beobachtbare Veränderungen zu beschreiben und jeder Referenz eine klare Rolle zuzuweisen.
Dieser Leitfaden behandelt T2VA, I2VA, FL2VA, L2VA, Ref2VA, Kamerasteuerung, Audio, Charakterkonsistenz und praktische Fehlerbehebung. Diese Prinzipien gelten auch für strukturierte KI-Video-Workflows wie Leadde, bei denen Dokumente, Schulungsmaterialien und Produktinformationen in skalierbare Videos verwandelt werden – inklusive Sprachausgabe, Avataren und mehrsprachiger Ausgabe.
MiniMax H3-Prompt-Leitfaden: Was ist die beste Prompt-Struktur?
Am besten betrachtet man einen MiniMax H3-Prompt wie ein audiovisuelles Produktionsbriefing. Anstatt Wörter wie „cinematisch“, „realistisch“ und „dramatisch“ aneinanderzureihen, sollten Sie beschreiben, was der Zuschauer im Laufe des Clips tatsächlich sieht und hört, um zu verstehen, wie man realistische KI-Videos erstellt.
Die einfache H3-Prompt-Formel
Für alltägliche Prompts beginnen Sie mit:
Subjekt + Aktion + Umgebung + Kamera + Timing + Audio
Beispielsweise legt „eine Frau an einem regnerischen Bahnhof“ zwar die Szene fest, liefert jedoch kaum zeitliche Informationen. Ein stärkerer Prompt erklärt stattdessen, dass sie auf den Bahnsteig zugeht, beim Geräusch eines herannahenden Zuges stehen bleibt, sich dem Geräusch zuwendet und von einer langsamen Verfolgungskamera begleitet wird.
Der offizielle Base Prompt Guide von MiniMax formalisiert diesen Ansatz in drei Feldern: integrated_multimodal_description, overall_soundscape und non_diegetic_music. Das erste Feld enthält die visuelle Zeitachse, Aktionen, Einstellungen, Sprecher, Dialoge und synchronisierten Szenensound; die anderen beiden trennen Umgebungs- und physische Geräusche von der rein für das Publikum bestimmten Hintergrundmusik.
Schreiben Sie beobachtbare Ergebnisse statt bloßer Adjektive
Eine nützliche Regel besagt, abstrakte Absichten in sichtbares Verhalten zu übersetzen.
Anstatt „sie sieht selbstbewusst aus“, beschreiben Sie, wie sie zielstrebig geht, den Blickkontakt hält, ihre Jacke richtet und ohne Zögern stehen bleibt.
Derselbe Ansatz hilft bei Einschränkungen. Anstatt immer wieder zu betonen „nicht heranzoomen“, beschreiben Sie das gewünschte Ergebnis: „Das Subjekt behält von Anfang bis Ende ungefähr dieselbe Größe im Bild.“ Ein Community-Test zur H3-Konsistenz ergab, dass messbare Bildausschnitt-Vorgaben in jenem spezifischen Workflow besser funktioniert haben als die ständige Wiederholung einer negativen Anweisung für die Kamera. Dies ist eine anekdotische Workflow-Beobachtung und keine offizielle MiniMax-Garantie.
Welchen MiniMax H3-Modus sollten Sie verwenden?
Die Wahl des richtigen Modus kann genauso wichtig sein wie das Umschreiben des Prompts. Der Base-Workflow von MiniMax unterstützt reine Textgenerierung sowie Aufgaben für das erste Bild (First-Frame), das letzte Bild (Last-Frame) und beide (First- und Last-Frame), während ein separater Ref2VA-Checkpoint multimodale Referenzgenerierungen handhabt.
| Modus | Eingabe | Bestes Prompt-Ziel |
| T2VA | Text | Die gesamte audiovisuelle Szene aufbauen |
| I2VA | Erstes Bild | Den Einstieg bewahren und vorwärts entwickeln |
| FL2VA | Erstes + letztes Bild | Den Übergang zwischen den Endpunkten beschreiben |
| L2VA | Letztes Bild | Auf das vorgegebene Ende hinarbeiten |
| Ref2VA | Bilder/Video/Audio | Verschiedene Referenzrollen kombinieren |
T2VA, I2VA, FL2VA und L2VA
T2VA muss die Szene komplett von Grund auf neu erstellen. I2VA behandelt das bereitgestellte Bild als tatsächliches erstes Bild, daher sollte der Prompt Identität, Kleidung, Objekte, Farben und Komposition bewahren, bevor Bewegungen eingeführt werden.
Bei FL2VA sollte der Prompt nicht einfach Bild 1 und Bild 2 beschreiben. MiniMax empfiehlt ausdrücklich, den beobachtbaren Pfad dazwischen zu beschreiben: wie sich das Subjekt bewegt, wie sich Posen verändern, wie Objekte manipuliert werden und wie Komposition oder Beleuchtung auf das finale Bild zulaufen. L2VA kehrt diesen Denkprozess um, indem es von einem plausiblen früheren Zustand ausgeht und sich schrittweise dem gelieferten letzten Bild annähert.
Wann sollten Sie Ref2VA verwenden?
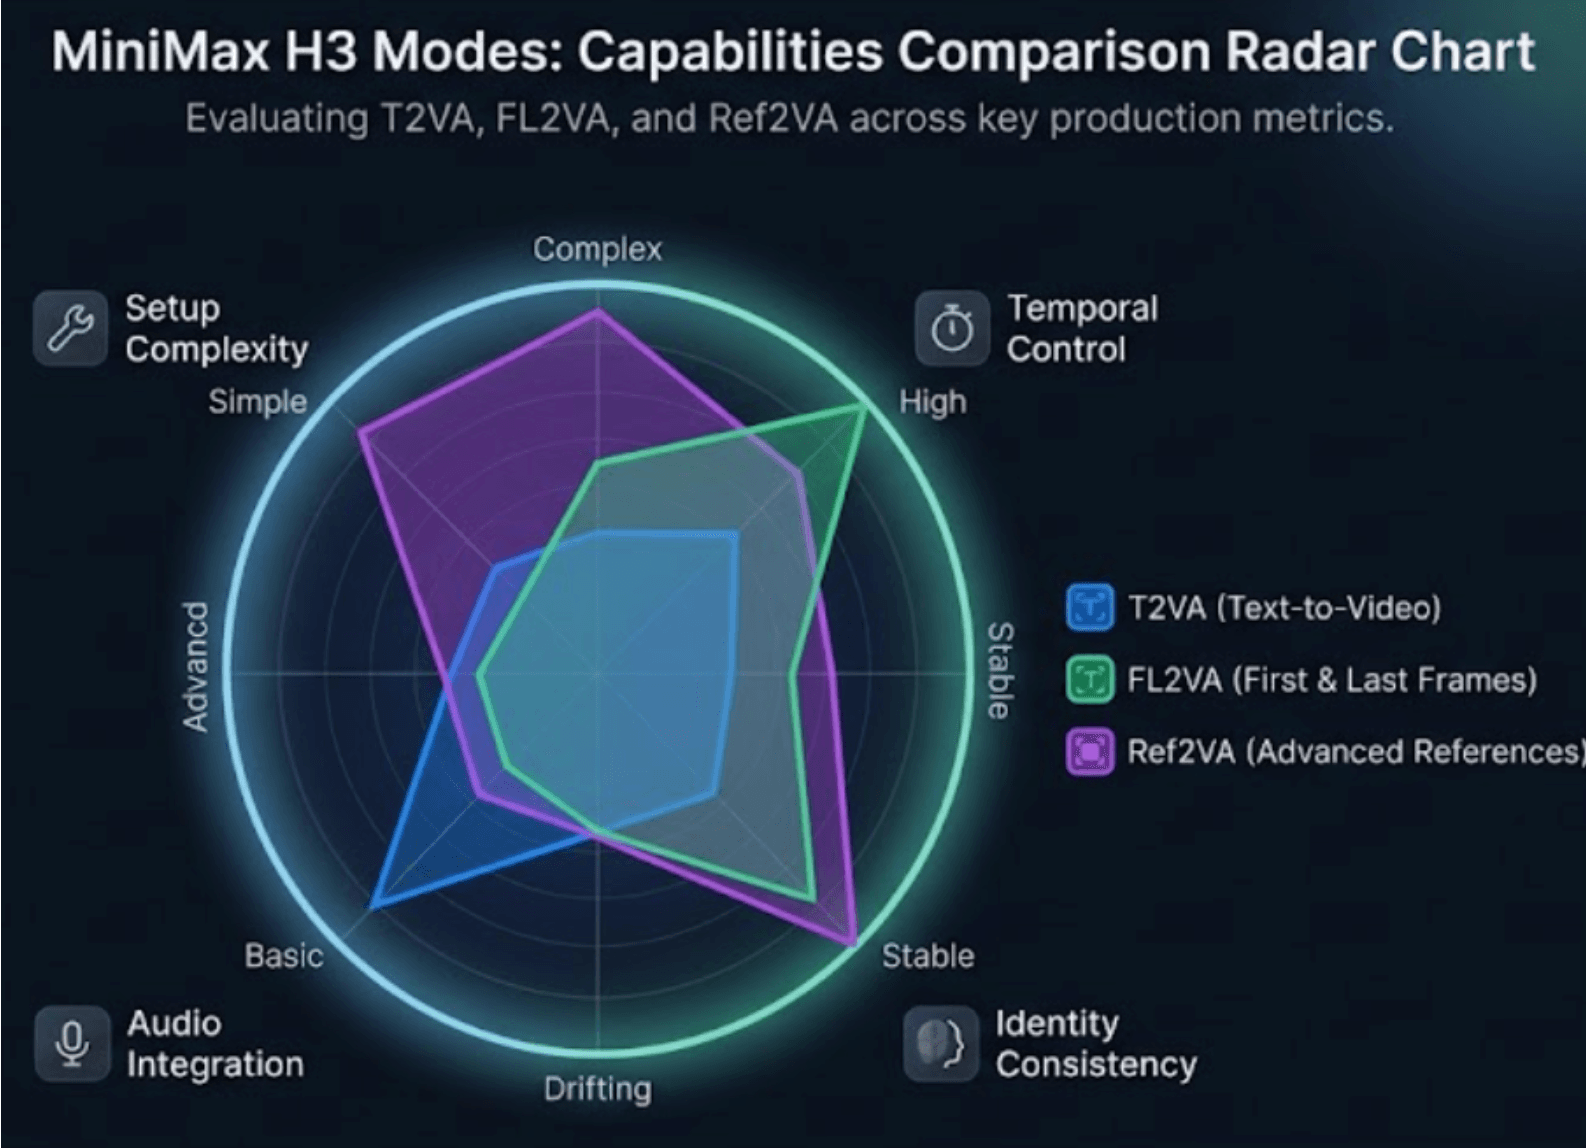
Nutzen Sie Ref2VA, wenn verschiedene Assets unterschiedliche Aufgaben erfüllen – zum Beispiel ein Bild für den Charakter, ein weiteres für die Kleidung, ein Video für Gehbewegung und Rhythmus der Kamera und Audio für eine Stimmreferenz.
Das lässt sich am besten als beziehungsbasierte Generierung verstehen. Das Modell muss nicht nur wissen, was in jeder Datei enthalten ist, sondern auch, wie Informationen aus den einzelnen Quellen das finale Video beeinflussen sollen. Das Full-Reference-Format von MiniMax unterscheidet explizit zwischen wiederverwendbaren Subjekten, konkreten Bildankern, zeitbasierten Videoquellen und Audioreferenzen.
Nutzen Sie den einfachsten Modus, der die Einstellung lösen kann
Eine praktische Produktionsregel lautet: Fügen Sie keine Referenzkomplexität hinzu, es sei denn, die Einstellung erfordert es.
Wenn ein Übergang lediglich einen präzisen Anfang und ein präzises Ende benötigt, bietet FL2VA eine direkte Definition für diese Aufgabe. Wechseln Sie zu Ref2VA, wenn Sie echte Beziehungen benötigen, wie etwa Identität aus Bild 1 + Bewegung aus Video 1 + Stimme aus Audio 1.
Das erleichtert auch die Fehlersuche. Wenn weniger unabhängige Einschränkungen miteinander konkurrieren, lässt sich leichter feststellen, ob ein Problem von Bewegung, Identität, Bildausschnitt oder Audio herrührt.
Wie steuern Sie Einstellungen, Kamerabewegungen, Timing und Übergänge?
H3-Prompts lassen sich wesentlich leichter kontrollieren, wenn man die Zeitachse wie einen Filmschnitt anstelle eines Fließtexts behandelt.
Schnitte, Zeitstempel und Zeitbudget
Das offizielle Format von MiniMax verwendet keine Zeitstempel für [Shot 1]. Spätere Einstellungen beginnen mit ansteigenden Schnittzeiten, wie zum Beispiel [Shot 2] At 00:03.500. Eine neue Einstellung sollte sinnvolle neue Informationen einbringen – etwa einen anderen Blickwinkel, Ort, Zustand, ein neues Subjekt oder eine andere Zeit. Eine geringfügige Distanz- oder Winkeländerung lässt sich meist besser durch eine Kamerabewegung als durch einen erneuten Schnitt ausdrücken.
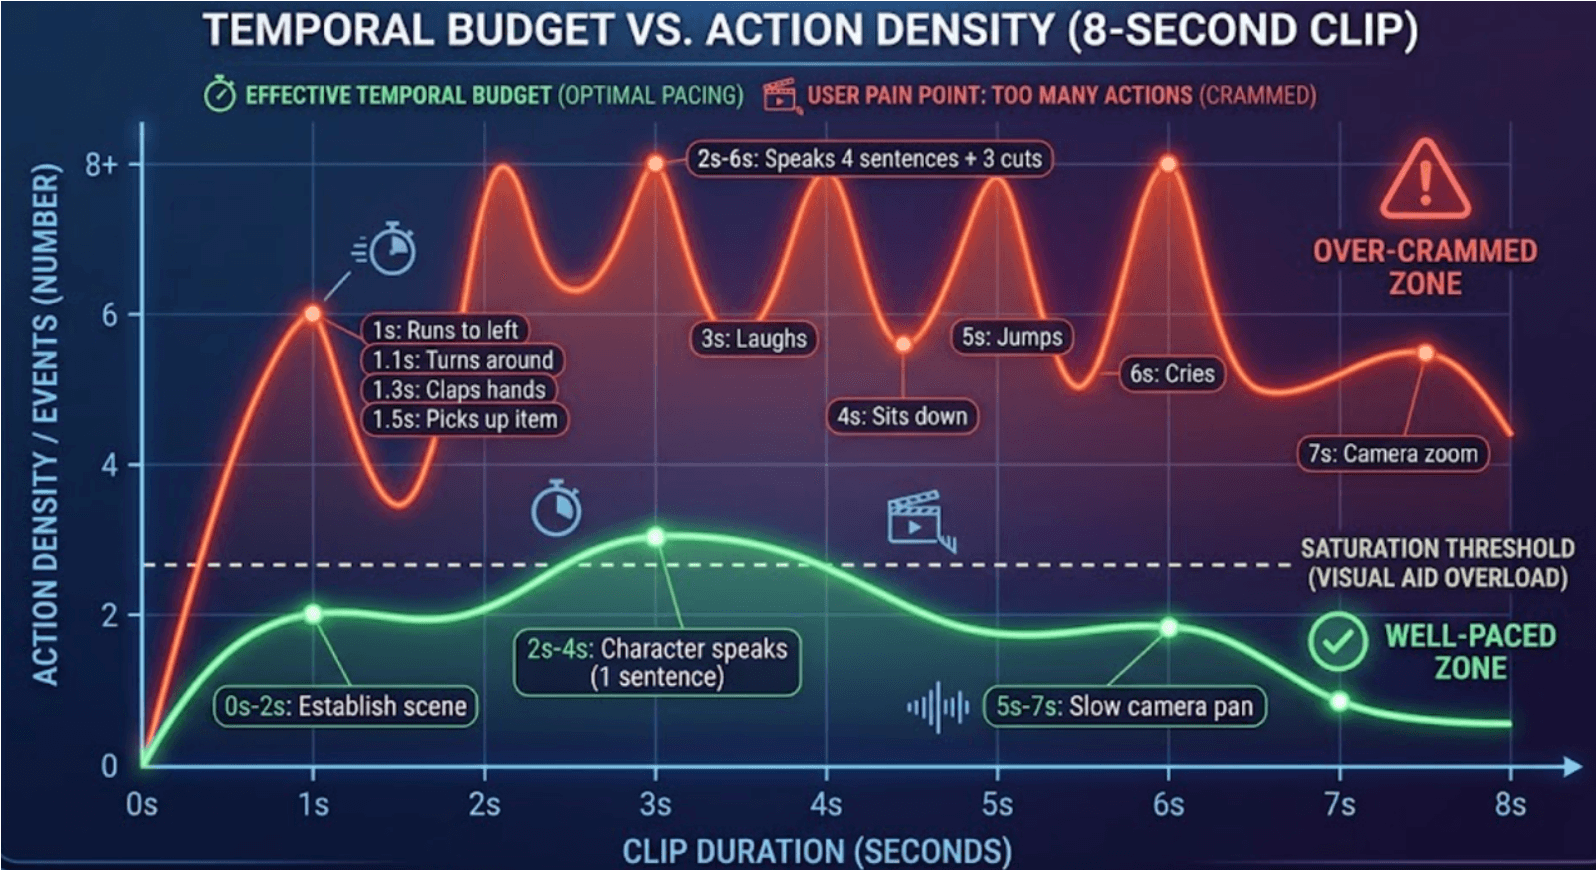
Dies führt zu einem praktischen Zeitbudget. In einem 8-Sekunden-Clip konkurrieren drei Aktionen, zwei Kamerabewegungen, eine Reaktion, ein gesprochener Satz und zwei Schnitte um dieselbe begrenzte Dauer. Wenn sich eine Generierung gehetzt anfühlt, hilft es oft mehr, Ereignisse zu streichen, als beschreibende Sprache hinzuzufügen.
Kamerasprache, die H3 verstehen kann
MiniMax dokumentiert Kameraoperationen wie Push/Pull, Pan, Truck, Tilt, Pedestal, Arc, Tracking, statische Einstellungen, POV, Roll und Kamerawackeln (Shake). Die empfohlene Logik folgt im Wesentlichen diesem Schema:
Bewegungstyp + optionale Amplitude + optionale Geschwindigkeit
Schreiben Sie also statt „dynamische, cineastische Kamera“ etwas Handfestes wie: „Die Kamera fährt langsam nach rechts und hält dabei das Produkt zentriert.“
Trennen Sie Fixes von Variablem
Erstellen Sie vor der Generierung eine einfache mentale Karte der festen und variablen Elemente.
Ein Produktvideo erfordert möglicherweise, dass Flaschenform, Etikettentext, Verschluss und Farbe unverändert bleiben, während sich Kameraposition, Reflexionen, Wasserbewegung und Beleuchtung verändern. Eine Charaktersequenz hingegen sperrt Gesicht, Frisur und Outfit, lässt aber Pose und Ausdruck Spielraum für die Weiterentwicklung.
Das reduziert widersprüchliche Anweisungen, da der Prompt nicht länger verlangt, dass sich alle visuellen Eigenschaften gleichzeitig verändern.
Wie nutzen Sie Referenzen, ohne Charakter- oder Produktkonsistenz zu verlieren?
Die stärksten Referenz-Workflows weisen jedem Asset einen klaren Zweck zu.
Geben Sie jeder Referenz genau eine Aufgabe
Eine praktische Zuordnung könnte so aussehen:
Bild 1 → Charakteridentität Bild 2 → Kleidung Bild 3 → Produktdesign Video 1 → Gehbewegung und Kamerapfad Audio 1 → Stimmklang
Das offizielle Ref2VA-Format von MiniMax unterstützt genau diese Art quellenübergreifender Definition: Ein Subjekt kann sein Aussehen aus einem Bild und seine Bewegung aus einem Video beziehen, während eine einzelne Referenzdatei auch mehrere wiederverwendbare Subjekte bereitstellen kann.
Das Wichtigste ist, eine versehentliche Übertragung zu vermeiden. Wenn Video 1 zwar die Bewegung, aber weder den Schauspieler noch die Umgebung liefern soll, formulieren Sie dies in der Beziehungsdefinition ausdrücklich.
Subjekte, Bilder, Storyboards und Referenzvideos
In der offiziellen Terminologie repräsentiert <Subject N> wiederverwendbare sichtbare Inhalte, während <Picture N> verwendet wird, wenn ein Bild selbst als konkreter Frame, Kompositionsanker oder Referenz für Videoskript und Storyboard dient. <Video N> steht für ganzheitliche Video-Beziehungen wie Schnitt, Kontinuität, Kamerabewegung, Schnitte, Rhythmus oder zeitliche Struktur. <Audio N> steuert Audiokopien oder Charakteristika wie Stimmfarbe, Intonation, Rhythmus oder Musikstil.
Diese Unterscheidung verhindert einen häufigen konzeptionellen Fehler: Eine Charakterreferenz ist nicht automatisch ein Keyframe, und ein Storyboard ist nicht automatisch ein exakter Endpunkt.
Referenz-Ökonomie und Konsistenz auf Einstellungsebene
Mehr Referenzmaterial bedeutet nicht automatisch mehr Informationsgehalt. Schneiden Sie in Produktions-Workflows ein Referenzvideo genau auf den Teil zu, der die gewünschte Bewegung, den Kamerapfad oder die Stimmqualität klar demonstriert.
Überprüfen Sie außerdem die Identität im Verlauf der gesamten Einstellung statt nur im ersten Frame. Ein Community-Test ergab bei Nahaufnahmen unter den spezifischen lokalen Einstellungen dieses Nutzers deutlich frühere Abweichungen der Identität als bei Einstellungen mit kleinerem Gesicht. Die genauen Zeitangaben lassen sich zwar nicht verallgemeinern, aber die Lektion für den Workflow ist nützlich: Überprüfen Sie Gesichtsidentität, Kleidung und kleine Requisiten an mehreren Punkten jeder wichtigen Einstellung.
Wie funktionieren fortgeschrittenes Ref2VA, Dialoge und Audio-Prompts?
Ref2VA ist der Punkt, an dem H3-Prompting mehr einer multimodalen Produktionsplanung gleicht als dem herkömmlichen Text-to-Video-Prompting.
Die sechsteilige Ref2VA-Prompt-Struktur
Der Leitfaden für vollständige Referenzen von MiniMax definiert sechs Abschnitte:
subject_definitions → summary → retention_analysis → detailed_description → overall_soundscape → non_diegetic_music.
Das System definiert zuerst, was Referenzen bedeuten, fasst dann die Aufgabe zusammen, erklärt, wie jede Referenz beibehalten oder übertragen wird, und schreibt schließlich das Zielvideo in Wiedergabereihenfolge auf.
Eine nützliche Planungsebene vor dem Verfassen des formalen Prompts ist:
| Quelle | Beibehalten | Übertragen | Ignorieren |
| Bild 1 | Gesicht, Haare | — | Hintergrund |
| Video 1 | — | Gehen, Kamera | Schauspieleridentität |
| Audio 1 | Stimmklang | Sprechweise | Originaldialog |
Dies verwandelt eine vage Anfrage wie „Nutze all diese Referenzen“ in explizite Quell-Ziel-Beziehungen.
Dialoge, Stimme, Soundeffekte und Musik
Sprechende Charaktere nutzen stabile IDs wie (S1) und (S2), während Dialoge innerhalb von <d>[Language] ...</d> platziert werden. MiniMax unterscheidet außerdem zwischen On-Screen-Dialogen und Off-Screen-Voiceover und empfiehlt, den Mund eines On-Screen-Charakters explizit geschlossen zu halten, wenn dieser Charakter lediglich als Erzähler fungiert.
Umgebungsgeräusche und physische Effekte gehören in die Klanglandschaft (soundscape), während non_diegetic_music für Musik reserviert ist, die nur vom Publikum und nicht von den Charakteren gehört wird. Wenn Sie Schritte, Regen und Objektgeräusche wünschen, aber keine Filmmusik, belassen Sie die Klanglandschaft und setzen Sie non_diegetic_music: N/A.
Natürlicher Sprach-Prompt vs. offizieller strukturierter Prompt
Kurze Anweisungen in natürlicher Sprache funktionieren im gehosteten H3-System nach wie vor, da MiniMax H3-Context-IR nutzt – eine Vorverarbeitungsschicht, die Beziehungen zwischen Text, Bildern, Video und Audio interpretiert, bevor sie eine strukturierte Darstellung für H3-Base erzeugt. Die offene Modellkarte beschreibt Befehlsanalyse, kreuzmodale Assoziation, zeitliches Verständnis und logische Schlussfolgerungen als Teil dieses Prozesses.
Dies erklärt einen scheinbaren Widerspruch: Einfache Prompts eignen sich gut für unkomplizierte, gehostete Generierungen, während strukturierte Prompts bei präzisen Aufgaben mit mehreren Referenzen, Dialogen, Timings und wiederholbaren Produktionen wertvoller werden.
Warum ignoriert MiniMax H3 Prompts und wie sieht der beste Test-Workflow aus?
Wenn eine Generierung fehlschlägt, macht das gleichzeitige Umschreiben von allem die Ursache schwerer lokalisierbar.
Häufige H3-Prompt-Probleme und Lösungen
| Problem | Wahrscheinliche Ursache | Erster Testschritt |
| Falsche Person spricht | Sprecherzuordnung unklar | (S1)/(S2) fixieren |
| Charakter verändert sich | Widersprüchliche Identitätssignale | Referenzen vereinfachen |
| Referenz wird ignoriert | Rolle ist zweideutig | Genau eine Aufgabe zuweisen |
| Zufällige Schnitte | Zu viele Regieanweisungen für Schnitte | Kamerabewegung nutzen |
| Zeitstempel ignoriert | Als Aktionstiming verwendet | Für Schnitte reservieren |
| FL2VA macht Sprünge | Fehlender Übergangspfad | Zwischenschritte beschreiben |
| Ende verfehlt Ziel | Schwache Konvergenz | Finale Komposition fixieren |
| Unerwünschte Musik | Audiocluster vermischt | Musik explizit definieren |
| Text verändert sich | Wortlaut nicht beibehalten | Exakten sichtbaren Text zitieren |
| Video wirkt gehetzt | Zu viele Ereignisse | Takte reduzieren |
Ein nützliches Prinzip ist es, einen kontrollierten Vergleich durchzuführen, wenn zwei Modi dieselbe Aufgabe lösen können, anstatt anzunehmen, dass der komplexere Modus automatisch den besseren Clip liefert.
Ein praktischer Schritt-für-Schritt H3-Test-Workflow
Beginnen Sie damit, das Akzeptanzkriterium für die Generierung zu definieren: Vielleicht ist die Charakteridentität am wichtigsten, oder vielleicht sind das Produktetikett, der Endpunkts-Übergang, die Dialogzuordnung oder die Kamerabewegung nicht verhandelbar.
Testen Sie dann in Schritten: Legen Sie zuerst Charakter und Szene fest; fügen Sie als Nächstes Bewegung und Kamera hinzu; ergänzen Sie erst dann Stimme und Sound, wenn das visuelle Verhalten stabil ist; führen Sie zusätzliche Schnitte, Storyboards oder weitere Charaktere erst ein, wenn die einfachere Version funktioniert. Eine Hochskalierung (High-Resolution-Regeneration) sollte erst erfolgen, wenn das semantische Ergebnis stimmt, da eine höhere Auflösung widersprüchliche Referenzbeziehungen nicht von sich aus lösen kann.
Dieser stufenweise Ansatz ist besonders bei skalierbaren Video-Pipelines nützlich. Bei Workflows, die wiederholbares Wissen oder Geschäftsinhalte in Videos verwandeln, einschließlich Dokument-zu-Video-Schulungstools wie Leadde, macht es das Trennen von Inhaltsstruktur, visuellem Verhalten, KI-Sprachausgabe und finalem Rendering einfacher, Überarbeitungen zu isolieren, anstatt bei jeder Änderung die gesamte Produktion neu aufzubauen.
Speichern Sie erfolgreiche Einstellungen, statt alles neu zu generieren
Behandeln Sie bei längeren Projekten jeden erfolgreichen Clip als validiertes Produktions-Asset. Wenn Einstellung 1 und 2 funktionieren, Einstellung 3 jedoch fehlschlägt, generieren Sie nur den fehlerhaften Abschnitt neu, anstatt alles davor zu verwerfen.
Community-H3-Workflows nutzen aus diesem Grund bereits mit Checkpoints versehene Einstellungen: Sobald ein erfolgreicher Abschnitt gespeichert ist, lassen sich nachgelagerte Experimente erneut ausführen, ohne wiederholt den Rechen- und Kreativaufwand für die Erstellung des früheren Materials zahlen zu müssen.
Dies führt zu einem umfassenderen Produktionsprinzip:
Generieren → validieren → speichern → fortfahren.
Bei KI-Videos wird Prompt Engineering letztlich zu Workflow Engineering.
Fazit
MiniMax H3-Prompting funktioniert dann am besten, wenn die Aufgabe klar strukturiert statt nur wortreich beschrieben wird. Wählen Sie den einfachsten Modus, der zur Einstellung passt, beschreiben Sie beobachtbare Veränderungen, trennen Sie feste Eigenschaften von variablen, weisen Sie jeder Referenz eine spezifische Rolle zu und betreiben Sie Fehlersuche Schicht für Schicht. Bei fortgeschrittenen Ref2VA-Workflows liegt der echte Vorteil darin, die Beziehungen zwischen Charakteren, Bewegung, Kamera, Audio und Keyframes explizit zu machen – und erfolgreiche Generierungen anschließend in wiederverwendbare Bausteine für die nächste Einstellung zu verwandeln.