MiniMax H3 사용법: 프롬프트, 레퍼런스, 오디오, ComfyUI 완벽 가이드
MiniMax H3를 가장 효과적으로 활용하려면 먼저 적절한 생성 모드를 선택한 다음, 텍스트, 프레임, 레퍼런스, 모션, 오디오로 무엇을 제어할지 결정해야 합니다. 텍스트로 생성하거나, 첫/마지막 프레임을 고정하거나, 이미지·비디오·오디오를 사용하여 정체성, 움직임, 카메라 무빙, 음성을 가이드할 수 있습니다.
H3는 멀티모달 레퍼런스와 네이티브 시청각 생성을 결합했기 때문에, 긴 프롬프트보다 명확한 제어를 통해 더 나은 결과물을 얻을 수 있는 경우가 많습니다. 본 가이드에서는 올바른 워크플로우를 선택하고, 더 나은 프롬프트를 작성하며, 레퍼런스를 활용하고, 대사와 사운드를 관리하고, 효율적으로 테스트하고, ComfyUI나 API를 연동하는 방법을 설명합니다.
크리에이티브 프롬프트로 시작하는 대신 PDF, 프레젠테이션, SOP, 또는 교육 문서가 시작점이라면, H3에서 각 씬을 수동으로 디렉팅하기 전이나 그 대신에 Leadde를 활용하여 구조화된 소스 콘텐츠를 비디오 워크플로우로 전환하는 것이 더 나은 선택일 수 있습니다.
MiniMax H3 사용법: 어떤 워크플로우로 시작해야 할까요?
MiniMax H3를 가장 빠르게 사용하는 방법은 프롬프트를 작성하기 전에 생성 모드를 선택하는 것입니다. H3는 텍스트, 첫/마지막 프레임 입력, 멀티모달 레퍼런스를 지원하며, 각 입력은 서로 다른 역할을 수행합니다. MiniMax의 공식 모델 카드에서는 오픈 웨이트 체크포인트를 텍스트 및 프레임 기반 생성을 위한 FL2VA와, 이미지·비디오·오디오를 이용한 레퍼런스 기반 생성을 위한 Ref2VA로 구분합니다.
| 모드 | 추천 용도 | 비디오 제어 방식 |
| T2VA | 처음부터 새로운 씬 생성 | 텍스트 프롬프트 |
| I2VA | 정확한 이미지에서 시작 | 첫 번째 프레임 + 프롬프트 |
| L2VA | 특정 엔딩 도달 | 마지막 프레임 + 프롬프트 |
| FL2VA | 시작과 끝 모두 제어 | 첫 번째 + 마지막 프레임 |
| Ref2VA | 정체성, 모션, 카메라, 스타일, 음성 유지 | 멀티모달 레퍼런스 + 프롬프트 |
이미지가 프레임인가요, 아니면 레퍼런스인가요?
이러한 구분을 통해 많은 제어 문제를 해결할 수 있습니다.
**프레임은 시간적 앵커(기준점)**입니다. 업로드한 제품 이미지가 시청자가 보게 될 말 그대로의 첫 번째 이미지여야 한다면, 첫 번째 프레임으로 사용하세요.
레퍼런스는 재사용 가능한 정보입니다. 새로운 구성을 만드는 동안 제품 디자인, 캐릭터 얼굴, 의상, 시각적 스타일만 일관되게 유지하면 되는 경우 레퍼런스로 취급하세요.
MiniMax의 공식 프롬프트 가이드는 이러한 구분을 명확히 합니다. I2VA는 제공된 이미지의 0.00초부터 시작하는 반면, 풀 레퍼런스 모드는 각 에셋이 수행하는 역할에 따라 피사체, 사진, 비디오, 오디오를 각각 추적합니다.
H3 제어 스택 (Control Stack)
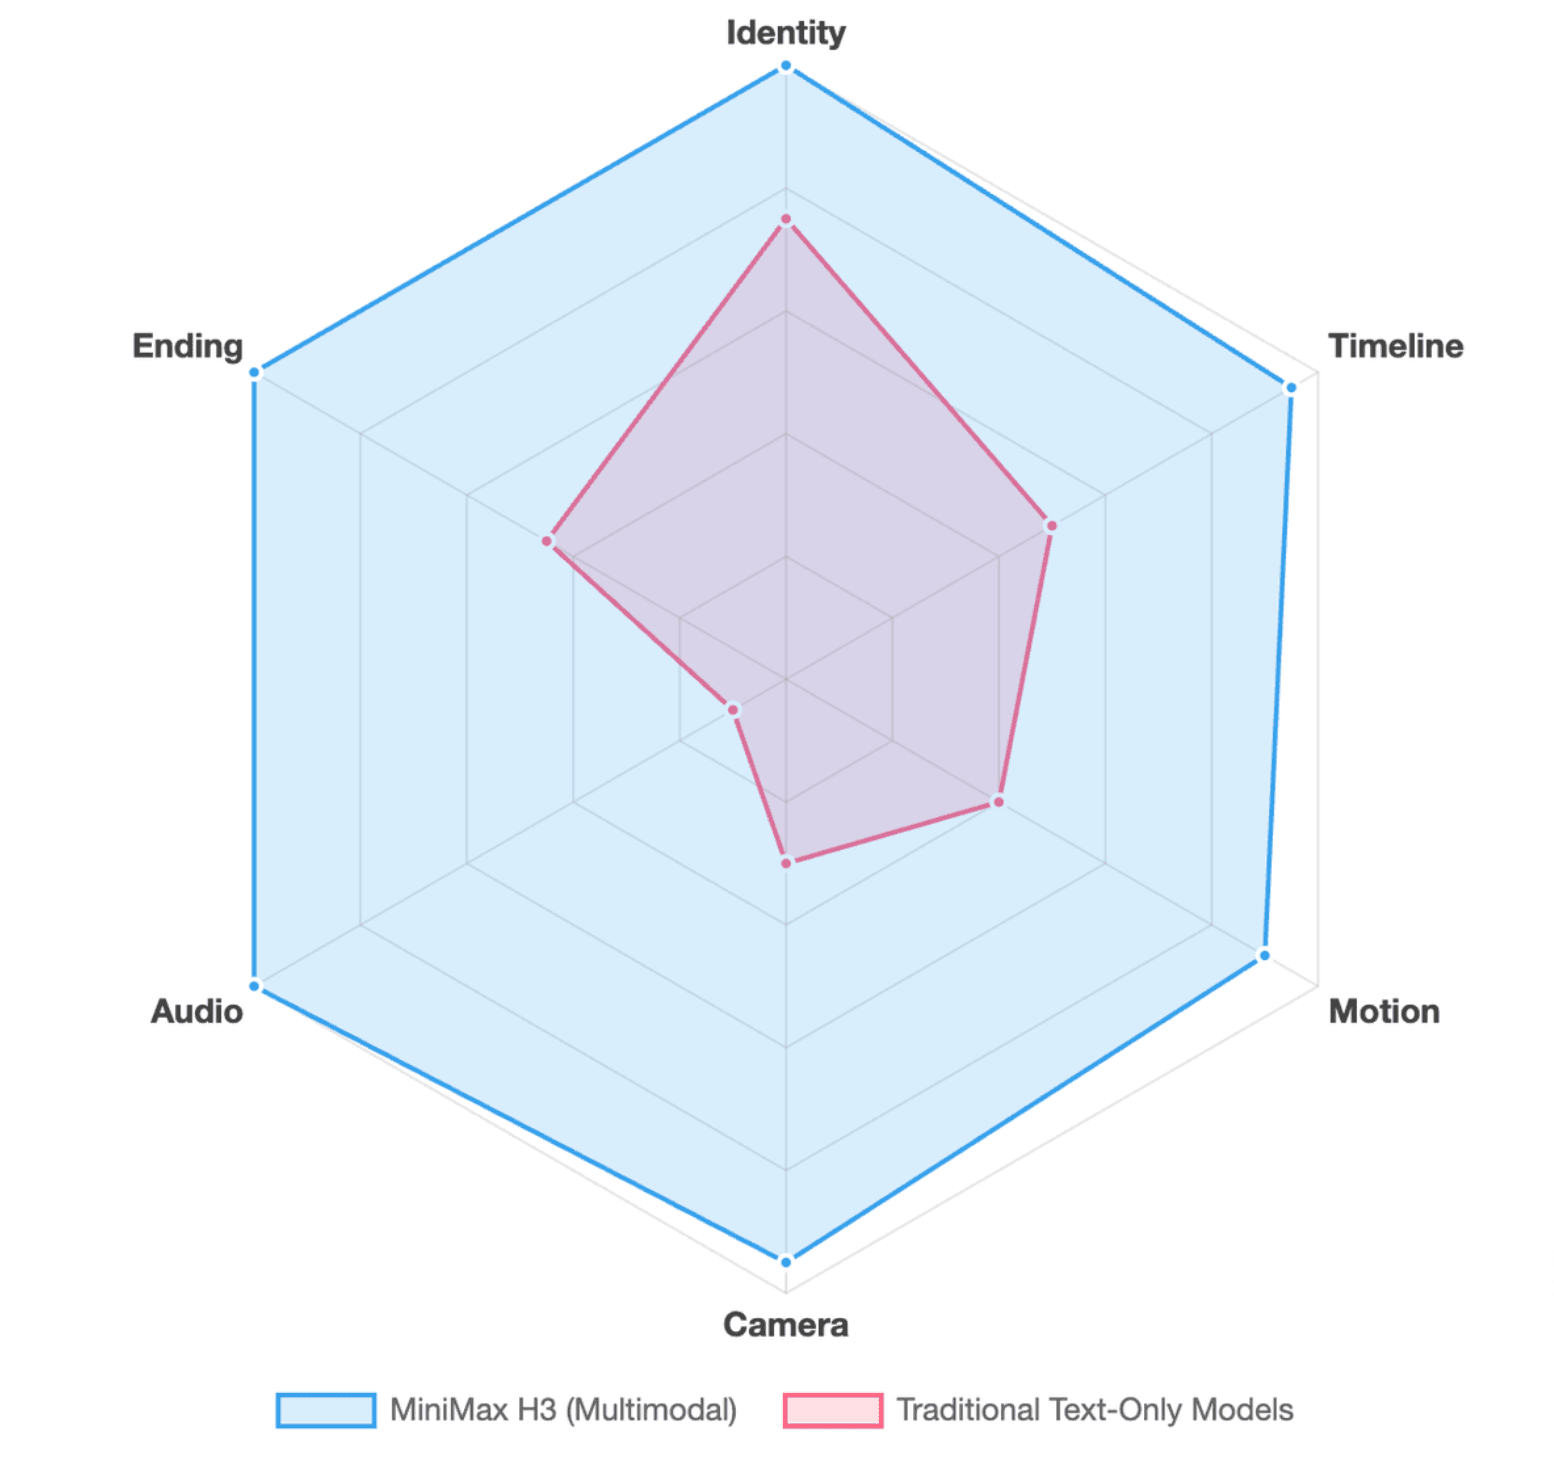
프롬프트를 작성하기 전에 정체성, 타임라인, 모션, 카메라, 오디오, 엔딩 등 비디오의 6가지 요소를 무엇으로 제어할지 결정하세요.
예를 들어, 상업용 비디오에서는 제품 정체성을 위해 레퍼런스 이미지를, 제품의 액션을 위해 텍스트를, 카메라 무빙을 위해 레퍼런스 비디오를, 사운드 디자인을 위해 네이티브 오디오 지침을, 최종 히어로 샷을 위해 마지막 프레임을 사용할 수 있습니다.
이를 통해 하나의 긴 텍스트 프롬프트로 모든 것을 제어하려다 발생하는 흔한 실수를 방지할 수 있습니다.
더 나은 제어를 제공하는 MiniMax H3 프롬프트 작성법은 무엇인가요?
유용한 H3 프롬프트는 재생 순서대로 비디오를 설명합니다. 효과적인 비디오 스크립트를 작성하는 방법에 사용되는 모범 사례처럼, 형용사를 나열하는 카피라이터가 아니라 실제로 보고 들을 수 있는 것을 묘사하는 디렉터처럼 생각해야 합니다.
실용적인 구조는 다음과 같습니다:
씬(Scene) → 피사체(Subject) → 액션(Action) → 카메라(Camera) → 대사/사운드(Dialogue/Sound) → 엔딩(Ending)
MiniMax의 공식 기본 프롬프트 형식도 동일한 기본 로직을 따릅니다. integrated_multimodal_description은 샷을 순서대로 설명하며, overall_soundscape와 non_diegetic_music은 물리적 사운드와 사운드트랙을 각각 제어합니다.
재생 순서에 따라 씬 구축하기
다음과 같이 작성하는 대신:
극적인 움직움이 있는 프리미엄 시네마틱 스킨케어 광고.
관찰 가능한 시퀀스를 사용하세요:
어두운 돌 재질의 받침대 위에 유리 세럼 병이 놓여 있습니다. 좁은 빛줄기가 라벨을 가로질러 쓸고 지나갑니다. 카메라가 더 가까이 다가가는 동안 병이 시계 방향으로 천천히 회전합니다. 물방울에 빛이 반사됩니다. 로고가 카메라를 향한 채 병이 멈춥니다.
두 번째 버전은 H3가 실행할 수 있는 가시적인 상태 변화를 제공합니다.
또한 **컴플렉시티 예산(complexity budget)**도 고려하세요. 캐릭터 3명, 컷 4개, 변신 과정, 대사 2줄, 움직이는 카메라, 여러 개의 레퍼런스가 포함된 10초짜리 클립은 기술적으로 묘사할 수 있을지 몰라도, 그 모든 이벤트가 10초 안에 자연스럽게 어우러진다는 뜻은 아닙니다.
카메라 무빙과 컷을 의도적으로 연출하기
카메라 행동은 샷에 도움이 될 때만 구체적으로 지정하세요(푸시 인, 풀 백, 팬, 트랙, 틸트, 아크, 또는 정지).
모든 프레이밍 조정을 새로운 컷으로 만들지 마십시오. 미디엄 샷에서 클로즈업으로 서서히 전환되는 과정은 새로운 씬이라기보다는 카메라 무빙으로 묘사하는 경우가 많습니다.
액션뿐만 아니라 엔딩도 정의하기
액션이 끝나는 지점을 설명할 때 프롬프트를 더 쉽게 제어할 수 있습니다.
"캐릭터가 창문을 향해 걸어간다"로 끝내는 대신, 최종 상태를 정의하세요: 캐릭터가 창문 옆에서 멈춰 서서 카메라를 향해 고개를 돌리고 스카이라인을 배경으로 프레임 안에 머물며 멈춘다.
이는 제품 데모 비디오, 로고 샷, 전환 효과, 첫/마지막 프레임 워크플로우에서 특히 중요합니다.
MiniMax H3에서 이미지, 비디오, 스토리보드, 음성 레퍼런스를 사용하는 방법은 무엇인가요?
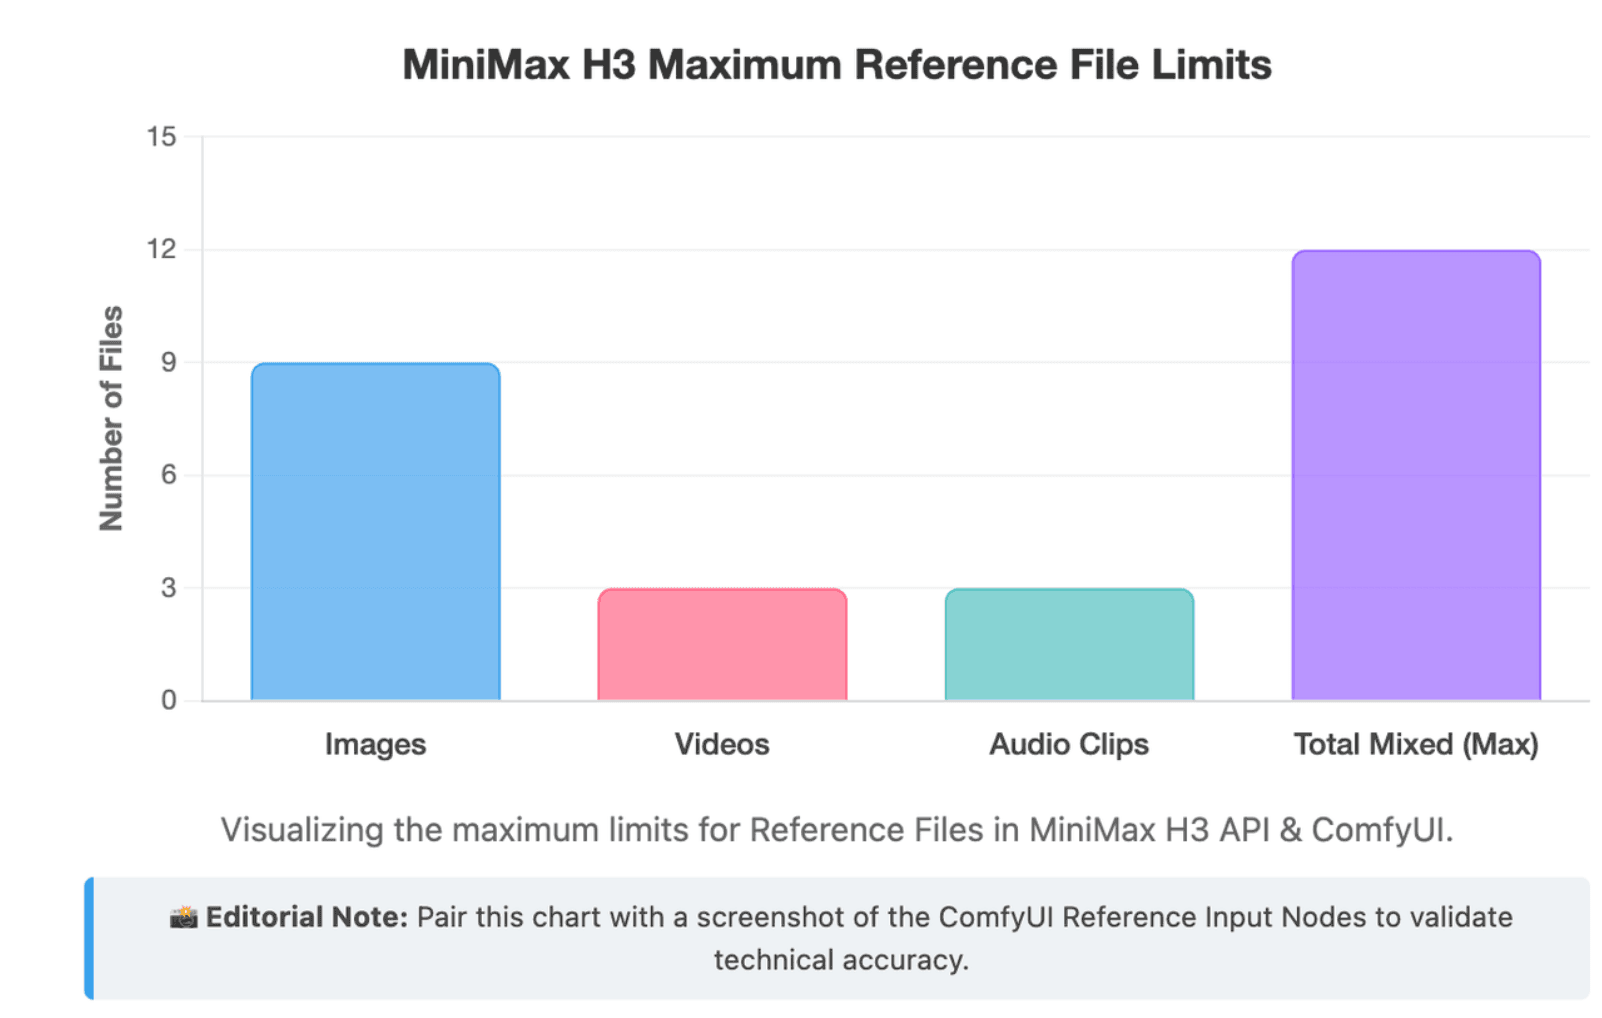
레퍼런스 투 비디오(Reference-to-video) 기능 덕분에 H3는 단순한 이미지 투 비디오 도구 그 이상이 됩니다. 공식 Ref2VA 모델은 멀티모달 레퍼런스를 수용하며, 이를 통해 정체성, 모션, 카메라 무빙, 스타일, 오디오에 영향을 줄 수 있습니다. 현재 MiniMax는 최대 9개의 이미지, 3개의 레퍼런스 비디오, 3개의 오디오 클립, 총 12개의 혼합 파일을 지원한다고 문서화하고 있습니다.
모든 레퍼런스에 명확한 역할 하나씩 부여하기
강력한 레퍼런스 설정은 다음과 같이 할당할 수 있습니다:
이미지 1 → 캐릭터 정체성; 이미지 2 → 의상; 비디오 1 → 신체 움직임; 비디오 2 → 카메라 무빙; 오디오 1 → 음성.
ComfyUI의 공식 H3 문서에서도 동일한 원칙을 권장합니다. 연결 순서에 따라 각 레퍼런스를 참조하고, 정체성·스타일·모션·카메라·음성을 제어하는 에셋이 무엇인지 명시하라는 것입니다.
레퍼런스가 많다고 해서 자동으로 제어력이 높아지는 것은 아닙니다. 오히려 H3가 해결해야 할 관계가 늘어날 뿐입니다. 두 이미지가 서로 다른 의상을 암시하는 반면 레퍼런스 비디오에는 다른 캐릭터 외형이 포함되어 있다면, 프롬프트에서 각 책임을 명확히 밝히지 않는 한 모델은 어떤 신호가 더 중요한지 스스로 판단해야 합니다.
<Subject>와 <Picture>의 차이
MiniMax의 풀 레퍼런스 형식에서 <Subject N>은 사람, 사물, 환경, 또는 레퍼런스 에셋에서 추상화된 기타 요소와 같이 재사용 가능한 시각적 콘텐츠를 나타냅니다. <Picture N>은 프레임이나 구도의 앵커로 사용되는 구체적인 이미지를 나타냅니다. <Video N>과 <Audio N>은 시간적 또는 오디오 레퍼런스를 추적합니다.
즉, 하나의 피사체가 하나의 파일과 같을 필요는 없다는 뜻입니다. 캐릭터는 한 이미지의 얼굴 정체성과 다른 소스의 의상 또는 모션 정보를 결합할 수 있습니다.
스토리보드는 언제 사용해야 할까요?
공간적 관계를 말로 설명하기보다 눈으로 보여주는 것이 더 쉬울 때, 스토리보드는 시각적 계획 레이어 역할을 할 수 있습니다. 이는 멀티 샷 시퀀스, 제품 공개, 캐릭터 블로킹, 또는 반복되는 구도에서 특히 유용합니다.
AI 비디오 워크플로우 관점에서의 장점은 스토리보드가 모든 프레임을 보장해 준다는 점이 아닙니다. 산문만으로는 소통하기 어려운 공간 및 샷 계획 정보를 줄여준다는 데 있습니다.
MiniMax H3에서 대사, 효과음, 음악을 제어하는 방법은 무엇인가요?
H3는 오디오를 별도의 후반 작업 레이어로 취급하는 대신, 비디오와 함께 네이티브 스테레오 오디오를 생성합니다. MiniMax는 32kHz 스테레오 출력을 지원하며, 프롬프트 시스템은 대사, 물리적 사운드, 비다이제틱(non-diegetic) 음악을 별개의 개념으로 지원합니다.
샷의 일부로 대사 작성하기
대사는 네 가지 질문에 답해야 합니다: 누가 말하는가, 무엇을 말하는가, 언제 말하는가, 화면에 나오는 시간은 얼마나 되는가.
MiniMax의 구조화된 형식은 지속적인 스피커 ID((S1) 등)와 대사 태그(<d>[English]...</d> 등)를 사용할 수 있습니다. 하지만 초보자가 처음부터 문법을 맞출 필요는 없습니다. 더 중요한 원칙은 타이밍입니다.
대사 예산(Dialogue budgeting) 활용하기
대사는 실제 시간을 소모합니다.
발화자가 4초 동안 등장하는데, 실제로는 8초가 걸리는 문장을 작성하지 마세요. 그렇지 않으면 모델이 연설을 압축하거나, 서두르거나, 잘라내거나, 왜곡해야 합니다.
현실적으로 로컬 H3 사용자들은 시각적 프롬프트 외에도 샷 타이밍과 대사를 함께 반복 조율하고 있으며, 음성을 독립된 레이어로 취급하지 않기 때문에 이는 매우 중요합니다. 보고된 한 RTX 5080 테스트에서는 구조화된 멀티 샷 프롬프트를 사용하여, 생성 자체에는 여전히 많은 컴퓨팅 비용이 드는 상황에서 반복적인 프롬프트 조정을 거쳐야 했습니다.
사운드스케이프와 배경음악 분리하기
씬 안에서 물리적으로 존재하는 소리(발소리, 엔진, 바람, 문, 군중, 옷감 스치는 소리, 기계 소리)에는 **사운드스케이프(soundscape)**를 사용하세요.
관객에게는 들리지만 캐릭터에게는 들리지 않는 음악에는 **비다이제틱 음악(non-diegetic music)**을 사용하세요.
이 둘을 분리하면 "시네마틱한 오디오를 추가해 줘" 같은 모호한 지시보다 H3에 훨씬 유용한 방향성을 제공할 수 있습니다. MiniMax의 공식 프롬프트 형식은 의도적으로 이 두 가지 오디오 레이어를 분리해 둡니다.
더 나은 MiniMax H3 결과를 만들어내는 설정과 테스트 워크플로우는 무엇인가요?
MiniMax는 오픈 H3-Base 워크플로우의 경우 4~15초 길이, 24 FPS, 다양한 화면 비율, 기본 768픽셀 쇼트 에지(short edge)로 H3 출력을 지원한다고 명시하고 있습니다. 전체 시스템은 H3-Regenerate-2K를 통해 2K 출력을 생성할 수 있습니다.
샷에 따라 지속 시간, 화면 비율, 해상도 선택하기
가장 긴 지속 시간을 무조건 선택하지 마세요. 유의미한 이벤트의 개수에 지속 시간을 맞추십시오.
대부분의 가로형 콘텐츠에는 16:9를, 세로형 소셜 비디오에는 9:16을, 정사각형 구도가 유통 채널에 적합할 때는 1:1을 사용하세요. ComfyUI의 공식 H3 워크플로우에서는 해상도 선택기(Resolution Selector)를 통해 화면 비율과 메가픽셀 컨트롤을 제공하며, 픽셀 수가 높을수록 생성 비용이 증가합니다.
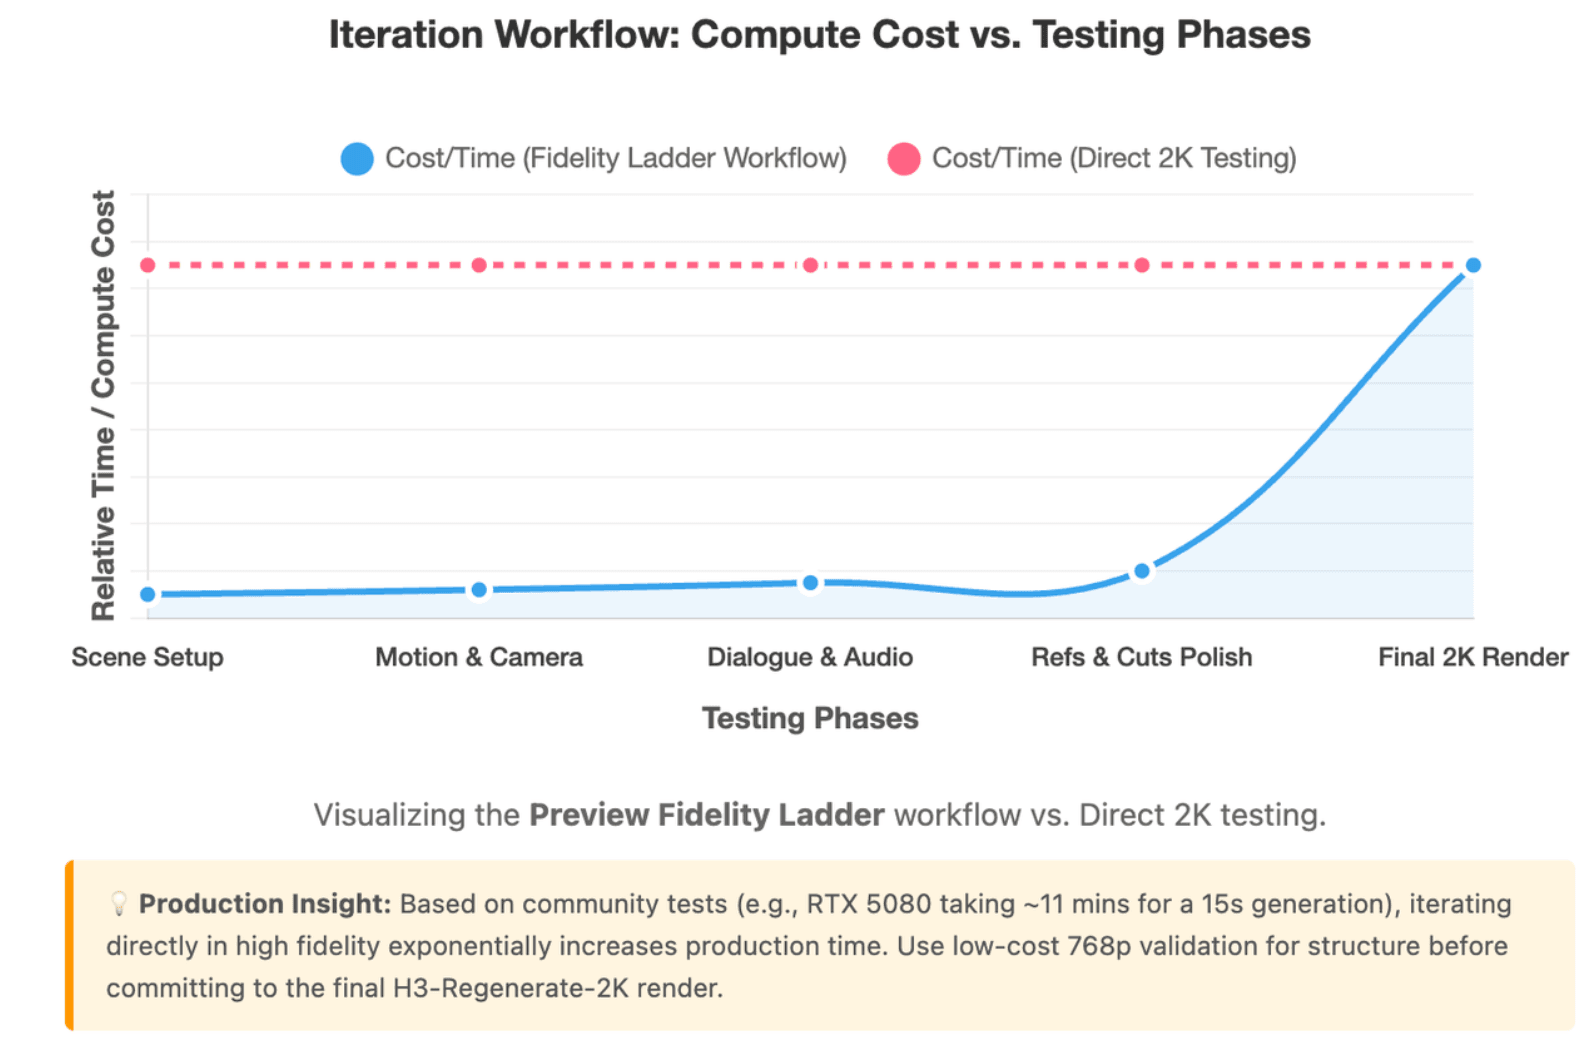
미리보기 충실도 사다리(Preview Fidelity Ladder) 활용하기
비용이 저렴한 미리보기는 유용하지만, 올바른 질문을 던질 때만 그렇습니다.
초기 테스트는 구도, 주요 모션, 카메라 무빙, 컷, 대략적인 타이밍을 확인하는 데 좋습니다. 작은 텍스트, 먼 거리의 얼굴, 로고, 또는 미세한 제품 디테일을 평가하는 데는 신뢰도가 떨어집니다.
따라서 목표는 단순히 "항상 저해상도로 먼저 생성하기"가 아닙니다. 구조적인 결정을 내릴 때는 저렴한 생성 방식을 사용하고, 더 높은 충실도에서만 비로소 가시화되는 디테일에 연산 리소스를 투자하는 것입니다.
한 번에 하나의 변수만 테스트하기
실용적인 제작 순서는 다음과 같습니다: 먼저 씬을 검증하고, 그 다음 모션과 카메라, 대사/오디오, 추가 레퍼런스나 컷 순으로 진행하며, 마지막으로 고화질 생성을 수행합니다.
AI 비디오의 실제 비용은 종종 생성 비용 × 반복 횟수이기 때문에 이 점이 중요합니다. 한 커뮤니티 테스트에서 RTX 5080 시스템은 15초 길이의 0.4MP, 10스텝 H3 생성에 약 11분이 소요되었으며, 비디오 길이가 길어질수록 스텝당 소요 시간이 대폭 증가했습니다. 또한 해당 사용자는 메모리 부족 오류를 피하기 위해 우회 방법을 찾아야 했다고 보고했습니다. 이는 보편적인 벤치마크가 아니라 단일한 실제 사례로 취급해야 합니다.
ComfyUI, API 워크플로우에서 MiniMax H3를 사용하는 방법과 일반적인 문제 해결법
현재 ComfyUI는 텍스트 투 비디오, 이미지 투 비디오, 레퍼런스 투 비디오를 위한 공식 H3 템플릿을 제공합니다. 기본 노드는 텍스트/프레임 워크플로우에는 FL2VA 계열을, 멀티모달 레퍼런스에는 Ref2VA를 사용합니다.
MiniMax API는 다른 방식을 취합니다. H3 작업은 비동기식(asynchronous)으로 진행됩니다. 생성, Context-IR, 또는 재생성 작업을 제출하여 task_id를 받고, 해당 작업에 결과를 쿼리하는 방식입니다. 성공적인 생성 작업은 content.url을 통해 비디오를 반환하고, Context-IR은 content.prompt를 통해 개선된 프롬프트를 반환합니다.
전체 H3 시스템을 오픈 H3-Base 가중치와 혼동해서는 안 됩니다. MiniMax는 H3-Context-IR → H3-Base → H3-Regenerate-2K의 세 가지 모듈을 설명합니다. 로컬 H3-Base는 768p 생성을 검증하고, 전체 2K 워크플로우는 원본 컨텍스트와 768p 결과를 결합하여 재생성을 수행합니다.
3단계 진단으로 실패 원인 파악하기
프롬프트를 다시 작성하기 전에 실패한 레이어를 파악하세요.
| 레이어 | 대표적인 문제 | 수정할 부분 |
| 프롬프트 | 잘못된 액션, 타이밍, 카메라, 엔딩 | 타임라인 재작성 |
| 레퍼런스 | 정체성, 의상, 모션, 음성의 왜곡 (Drift) | 레퍼런스 역할 명확화 또는 축소 |
| 렌더링 | 작은 텍스트, 먼 거리의 얼굴, 미세한 디테일 | 더 높은 충실도의 출력/설정 테스트 |
모든 시각적 결함이 프롬프트 문제인 것은 아니기 때문에 이 구분은 매우 유용합니다.
일반적인 MiniMax H3 문제 및 실용적인 해결책
정체성이 왜곡된다면, 상충되는 레퍼런스를 단순화하고 어떤 소스가 정체성을 제어하는지 명확히 정의하세요. 제품이나 로고가 변형된다면, 반드시 유지해야 할 속성과 모델이 재디자인해도 되는 요소를 명시적으로 분리하십시오.
비디오가 촉박하게 느껴진다면, 프롬프트 세부 사항을 더 추가하는 대신 액션, 컷, 대사를 줄이세요. 음성이 압축된 것처럼 들린다면, 대사를 짧게 만들거나 화자에게 더 많은 시간을 부여하십시오.
첫/마지막 프레임 워핑(변형) 현상이 발생한다면, 두 개의 종착점만 지정하는 대신 중간의 물리적 전환 과정을 묘사하세요. R2V 레퍼런스의 영향력이 거의 없다면, 단순히 첨부하기보다는 정확한 역할을 명시하십시오.
또한 로컬 사용자는 성능 튜닝에 신중해야 합니다. ComfyUI는 선택적 Sage Attention을 공식적으로 지원하며 예시 워크플로우를 통해 최소한의 품질 저하로 생성 속도가 대략 두 배 빨라질 수 있다고 밝히고 있지만, 기타 캐싱, 양자화(quantization), 실험적 최적화 기법은 서로 다른 트레이드오프를 수반할 수 있습니다.
결론
MiniMax H3는 비디오 생성을 단순한 프롬프트 길이 싸움이 아닌 제작 워크플로우로 대할 때 훨씬 더 쉽게 제어할 수 있습니다. 올바른 모드를 선택하고, 각 레퍼런스에 명확한 역할을 부여하고, 가용 시간 내에 액션과 대사 예산을 배분하고, 최종 품질 렌더링 전에 구조적 결정을 테스트하고, 실패 원인을 프롬프트, 레퍼런스, 렌더링 문제로 나누어 진단하세요. 이러한 접근 방식은 단순한 텍스트 투 비디오 클립부터 복잡한 멀티모달 설정까지 확장될 수 있으며, 이는 오늘날 사람들이 AI 비디오를 그토록 빠르게 만들어내는 방식을 그대로 보여줍니다.