MiniMax H3 Prompt Gids: Zo schrijf je betere prompts voor video, Ref2VA, camera, audio en referentieprompts
Een sterke MiniMax H3-prompt omschrijft meer dan alleen de visuele stijl. Het is een blauwdruk die uitlegt wat er in de tijd gebeurt, hoe de camera beweegt, welke details consistent moeten blijven, wat elke referentie bijdraagt, en hoe dialoog, geluid en muziek in de sequentie passen. Voor een betere controle is de kern: kies de juiste H3-modus, beschrijf waarneembare veranderingen en geef elke referentie een duidelijke rol.
Deze handleiding behandelt T2VA, I2VA, FL2VA, L2VA, Ref2VA, camerabesturing, audio, personageconsistentie en praktische probleemoplossing. Deze principes gelden ook voor gestructureerde AI-videoworkflows zoals Leadde, waar documenten, trainingsmateriaal en productinformatie worden omgezet in schaalbare video's voorzien van nasynchronisatie, avatars en meertalige output.
MiniMax H3 Prompt-gids: Wat is de beste promptstructuur?
De nuttigste manier om naar een MiniMax H3-prompt te kijken, is als een audiovisuele productiebriefing. In plaats van te stapelen met woorden als "cinematisch", "realistisch" en "dramatisch", beschrijf je wat de kijker daadwerkelijk ziet en hoort naarmate de clip vordert, om zo te begrijpen hoe je realistische AI-video's maakt.
De eenvoudige H3-promptformule
Voor dagelijks gebruik begin je met:
Onderwerp + Actie + Omgeving + Camera + Timing + Audio
Bijvoorbeeld, "een vrouw op een regenachtig station" zet een scène neer, maar levert weinig temporele informatie op. Een sterkere prompt legt uit dat ze naar het perron loopt, stopt wanneer ze een naderende trein hoort, zich naar het geluid omdraait en wordt gevolgd door een langzame meetrekkende camera.
MiniMax's officiële Base Prompt Guide formaliseert dit idee in drie velden: integrated_multimodal_description, overall_soundscape en non_diegetic_music. Het eerste veld bevat de visuele tijdlijn, acties, shots, sprekers, dialoog en gesynchroniseerde scènegeluiden; de andere twee scheiden omgevings- en fysieke geluiden van achtergrondmuziek die alleen voor de kijker hoorbaar is.
Schrijf waarneembare resultaten, geen bijvoeglijke naamwoorden
Een handige vuistregel is om abstracte bedoelingen om te zetten in zichtbaar gedrag.
In plaats van "ze kijkt zelfverzekerd", beschrijf je hoe ze vastberaden loopt, oogcontact houdt, haar jasje rechtzet en zonder aarzeling stopt.
Dezelfde aanpak helpt bij restricties. In plaats van te herhalen "niet inzoomen", beschrijf je het gewenste resultaat: "het onderwerp blijft van begin tot eind ongeveer even groot in het kader." Een community H3-consistentietest wees uit dat meetbare kadreringsbeperkingen in die specifieke workflow beter werkten dan het herhaaldelijk opgeven van een negatieve camera-instructie. Dit is een anecdotische workflow-observatie, geen officiële garantie van MiniMax.
Welke MiniMax H3-modus moet je gebruiken?
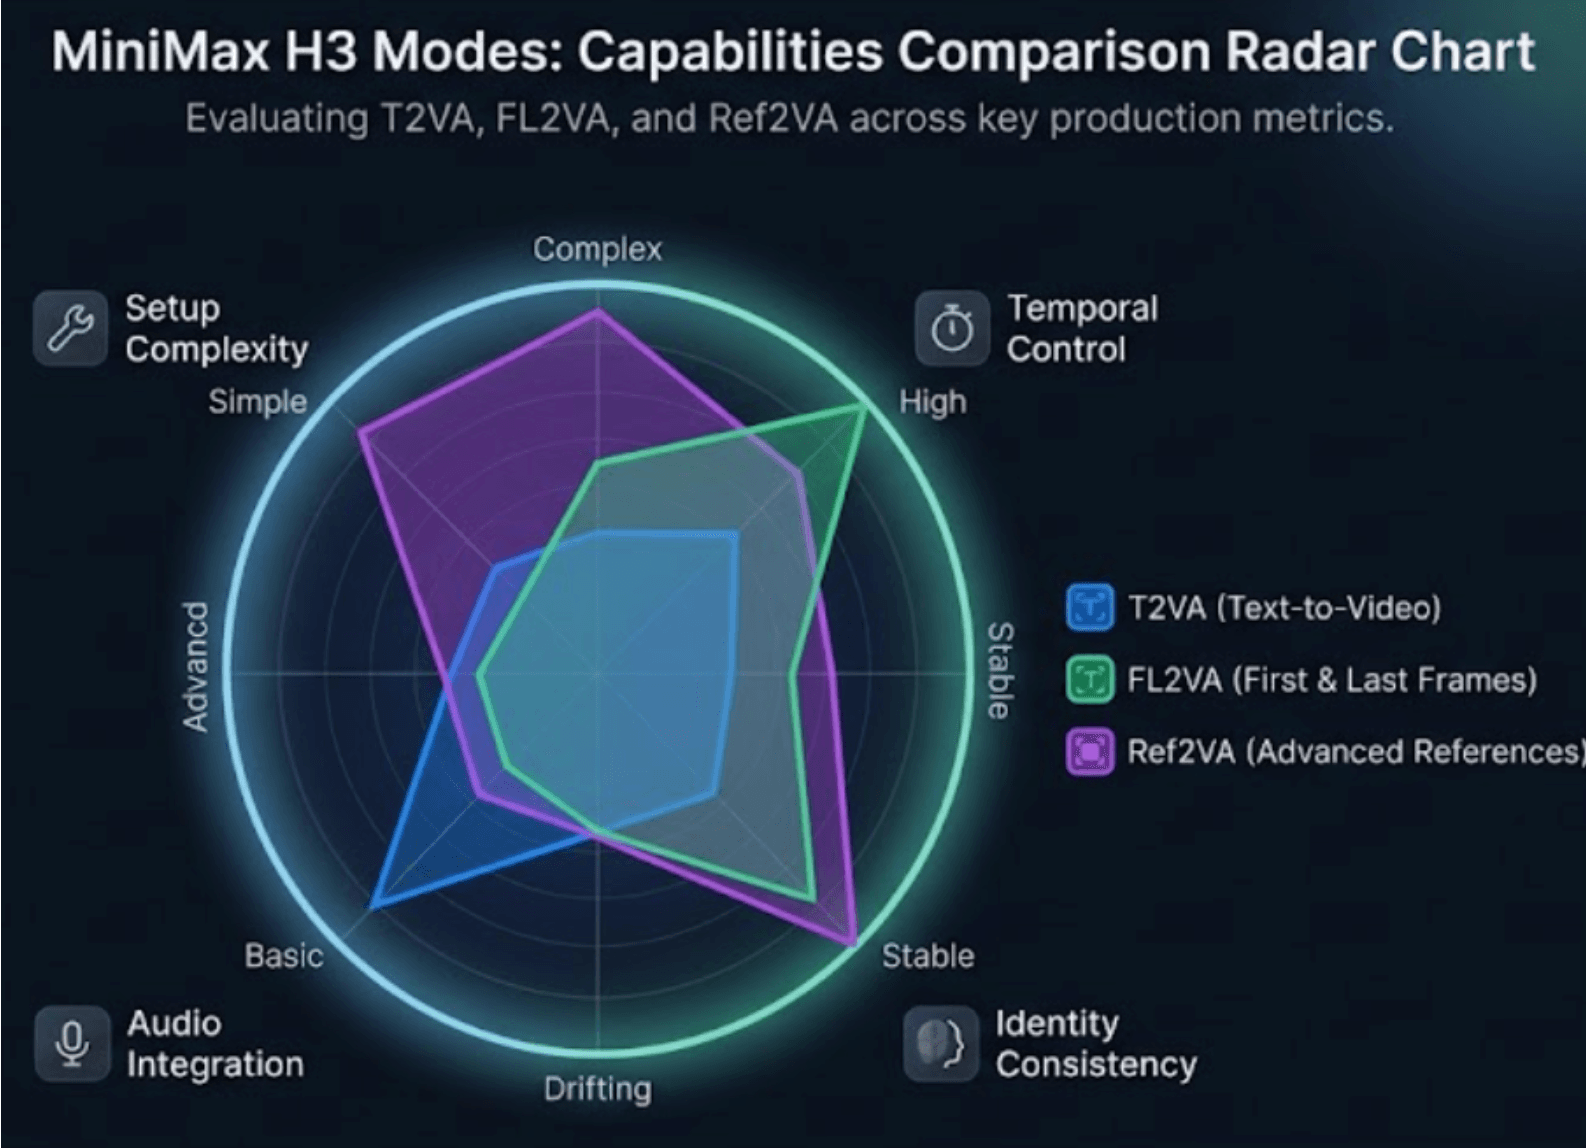
Het kiezen van de juiste modus kan net zo belangrijk zijn als het herschrijven van de prompt. MiniMax's Base-workflow ondersteunt tekstgebaseerde generatie plus taken voor een eerste frame, laatste frame en eerste-en-laatste frame, terwijl de afzonderlijke Ref2VA-checkpoint overweg kan met multimodale referentiegeneratie.
| Modus | Input | Beste promptdoel |
| T2VA | Tekst | Bouw de volledige audiovisuele scène op |
| I2VA | Eerste frame | Behoud de opening en ontwikkel vanaf daar verder |
| FL2VA | Eerste + laatste frame | Beschrijf de overgang tussen eindpunten |
| L2VA | Laatste frame | Bouw toe naar het aangeleverde einde |
| Ref2VA | Afbeeldingen/video/audio | Combineer verschillende referentierollen |
T2VA, I2VA, FL2VA en L2VA
T2VA moet de scène vanaf nul opbouwen. I2VA behandelt de aangeleverde afbeelding als daadwerkelijk het eerste frame, dus de prompt moet identiteit, kleding, objecten, kleuren en compositie behouden voordat er beweging wordt geïntroduceerd.
Bij FL2VA moet de prompt niet simpelweg Afbeelding 1 en Afbeelding 2 beschrijven. MiniMax raadt specifiek aan om het waarneembare pad daartussen te beschrijven: hoe het onderwerp beweegt, hoe houdingen veranderen, hoe objecten worden gehanteerd en hoe compositie of belichting convergeert naar het uiteindelijke frame. L2VA draait het redeneerproces om door te vertrekken vanuit een plausibele eerdere staat en geleidelijk te landen op het aangeleverde laatste frame.
Wanneer moet je Ref2VA gebruiken?
Gebruik Ref2VA wanneer verschillende assets verschillende taken uitvoeren — bijvoorbeeld één afbeelding definieert een personage, een andere definieert kleding, een video levert de wandelbeweging en het cameraritme, en audio levert een stemreferentie.
Dit kun je het beste zien als relatiegestuurde generatie. Het model moet niet alleen weten wat elk bestand bevat, maar ook hoe de informatie uit elke bron van invloed is op de uiteindelijke video. Het volledige-referentieformaat van MiniMax maakt expliciet onderscheid tussen herbruikbare onderwerpen, concrete beeldbank-ankers, temporele bronnen op videoniveau en audioreferenties.
Gebruik de eenvoudigste modus die het shot kan oplossen
Een praktische productieregel is: voeg geen referentiecomplexiteit toe tenzij het shot dat vereist.
Als een overgang alleen een nauwkeurige opening en afsluiting nodig heeft, geeft FL2VA de taak een directe definitie. Schakel over op Ref2VA wanneer je daadwerkelijk relaties nodig hebt zoals identiteit uit Afbeelding 1 + beweging uit Video 1 + stem uit Audio 1.
Dit maakt ook het opsporen van fouten eenvoudiger. Wanneer minder onafhankelijke beperkingen met elkaar concurreren, is het makkelijker te achterhalen of het probleem wordt veroorzaakt door beweging, identiteit, kadrering of audio.
Hoe stuur je shots, camerabeweging, timing en overgangen aan?
H3-prompts worden beter beheersbaar wanneer je de tijdlijn behandelt als een montage in plaats van een doorlopende alinea.
Shot-cuts, tijdstempels en temporeel budget
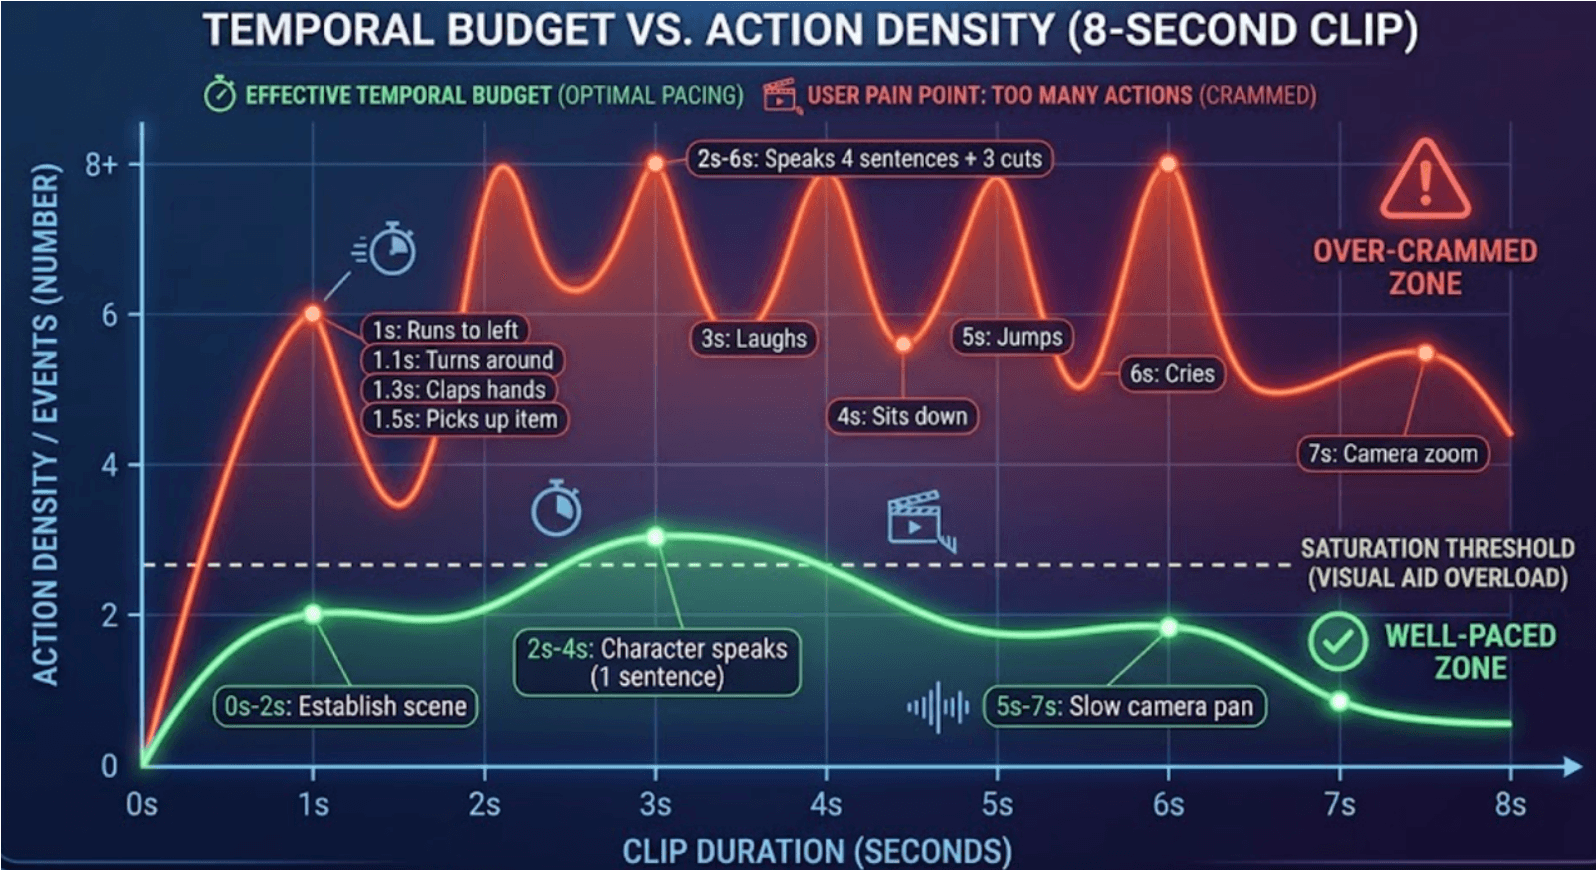
Het officiële format van MiniMax gebruikt geen tijdstempels zoals [Shot 1]. Latere shots beginnen met oplopende cut-tijden, zoals [Shot 2] At 00:03.500. Een nieuw shot moet betekenisvolle nieuwe informatie introduceren, zoals een ander standpunt, locatie, toestand, onderwerp of tijdstip. Een kleine verandering in afstand of hoek kun je meestal beter uitdrukken als een camerabeweging dan als een nieuwe cut.
Dit creëert een praktisch temporeel budget. In een clip van 8 seconden vechten drie acties, twee camerabewegingen, een reactie, een uitgesproken zin en twee cuts om dezelfde beperkte duur. Wanneer een generatie gehaast aanvoelt, werkt het verwijderen van acties vaak beter dan het toevoegen van meer beschrijvende taal.
Camerataal die H3 kan volgen
MiniMax documenteert kamerabewerkingen zoals push/pull, pan, truck, tilt, pedestal, arc, tracking, vaste shots, POV, roll en camerashudding. De aanbevolen logica is in essentie:
Bewegingstype + optionele amplitude + optionele snelheid
Dus in plaats van "dynamische cinematografische camera", schrijf je iets bruikbaars, zoals "de camera maakt langzaam een truck-beweging naar rechts terwijl het product in het midden wordt gehouden."
Scheid wat vast moet blijven staan van wat mag veranderen
Maak voorafgaand aan het genereren een eenvoudig mentaal vast-versus-variabel overzicht.
Een productvideo vereist mogelijk dat de vorm van de fles, de tekst op het etiket, de dop en de kleur ongewijzigd blijven, terwijl de camerapositie, reflecties, waterbeweging en belichting veranderen. Een personagereeks kan gezicht, kapsel en outfit vergrendelen, terwijl houding en expressie zich mogen ontwikkelen.
Dit vermindert tegenstrijdige instructies omdat de prompt niet langer vraagt om alle visuele eigenschappen tegelijk te laten veranderen.
Hoe gebruik je referenties zonder verlies van personage- of productconsistentie?
De krachtigste referentieworkflows kennen aan elk asset een specifiek doel toe.
Geef elke referentie één duidelijke taak
Een praktische indeling kan zijn:
Afbeelding 1 → identiteit van het personage Afbeelding 2 → kleding Afbeelding 3 → productontwerp Video 1 → wandelbeweging en camerapad Audio 1 → stemtimbre
Het officiële Ref2VA-formaat van MiniMax ondersteunt precies dit soort kruislingse brondefinities: één onderwerp kan zijn uiterlijk ontlenen aan een afbeelding en beweging aan een video, terwijl een enkel referentiebestand ook meerdere herbruikbare onderwerpen kan aanleveren.
Het belangrijkste is om onbedoelde overdracht te voorkomen. Als Video 1 wel beweging moet leveren, maar niet de acteur of de omgeving, vermeld dat dan expliciet in het relatieontwerp.
Onderwerpen, afbeeldingen, storyboards en referentievideo
In de officiële terminologie vertegenwoordigt <Subject N> hergebruikte zichtbare inhoud, terwijl <Picture N> wordt gebruikt wanneer een afbeelding zelf dienstdoet als concreet frame, compositie-anker of referentie voor videoscript en storyboard. <Video N> vertegenwoordigt relaties voor de hele video, zoals montage, continuïteit, camerabeweging, cuts, ritme of temporele structuur. <Audio N> regelt audiokopiëring of kenmerken zoals stemtimbre, dictie, ritme of muziekstijl.
Dit onderscheid voorkomt een veelgemaakte conceptuele fout: een referentie voor een personage is niet automatisch een keyframe, en een storyboard is niet automatisch een exact eindpunt.
Referentie-economie en shot-consistentie
Meer referentiemateriaal levert niet automatisch meer informatie op. Knip in productieflows een referentievideo bij tot het gedeelte dat helder de beweging, het camerapad of de vocale kwaliteit toont die je nodig hebt.
Evalueer daarnaast de identiteit gedurende het hele shot in plaats van alleen in het eerste frame. Uit een community-test bleek dat identiteitsdrift bij close-ups aanzienlijk sneller optrad dan bij kadreringen met kleinere gezichten binnen de specifieke lokale opstelling van die gebruiker. De exacte timings moeten niet worden gegeneraliseerd, maar de les voor de workflow is waardevol: controleer gezichtsidentiteit, kleding en kleine rekwisieten op meerdere momenten in elk belangrijk shot.
Hoe werken geavanceerde Ref2VA-, dialoog- en audioprompts?
Bij Ref2VA gaat H3-prompting meer lijken op multimodale productieplanning dan op conventionele tekst-naar-video-prompting.
De uit zes delen bestaande Ref2VA-promptstructuur
De volledige referentiegids van MiniMax definieert zes secties:
subject_definitions → summary → retention_analysis → detailed_description → overall_soundscape → non_diegetic_music.
Het systeem definieert eerst wat referenties betekenen, vat vervolgens de taak samen, legt uit hoe elke referentie behouden blijft of wordt overgedragen, en schrijft tot slot de doelvideo in afspeelvolgorde.
Een nuttige planningslaag voordat je de formele prompt schrijft is:
| Bron | Behouden | Overdragen | Negeren |
| Afbeelding 1 | Gezicht, haar | — | Achtergrond |
| Video 1 | — | Wandeling, camera | Identiteit acteur |
| Audio 1 | Stemtimbre | Dictie | Originele dialoog |
Hiermee verander je een vaag verzoek als "gebruik al deze referenties" in expliciete bron-tot-doel-relaties.
Dialoog, stem, geluidseffecten en muziek
Sprekende personages gebruiken stabiele ID's zoals (S1) en (S2), terwijl dialoog binnen <d>[Language] ...</d> wordt geplaatst. MiniMax maakt tevens onderscheid tussen on-screen dialoog en off-screen voice-over en raadt aan om de lippen van een on-screen personage expliciet gesloten te houden wanneer dat personage uitsluitend de voice-over verzorgt.
Omgevingsgeluiden en fysieke effecten horen thuis in het geluidslandschap, terwijl non_diegetic_music is gereserveerd voor muziek die wel door het publiek wordt gehoord, maar niet door de personages. Wil je wel voetstappen, regen en objectgeluiden maar geen filmmuziek, handhaaf dan het geluidslandschap en stel non_diegetic_music: N/A in.
Natuurlijketaal-prompt versus officiële gestructureerde prompt
Korte instructies in natuurlijke taal werken nog steeds binnen het gehoste H3-systeem omdat MiniMax gebruikmaakt van H3-Context-IR, een pre-processinglaag die de relaties tussen tekst, afbeeldingen, video en audio interpreteert alvorens een gestructureerde representatie te genereren voor H3-Base. De open modelkaart beschrijft instructieparsing, cross-modale associatie, temporeel begrip en logisch redeneren als onderdeel van dat proces.
Dit verklaart een ogenschijnlijke tegenstrijdigheid: eenvoudige prompts kunnen volstaan voor rechttoe rechtaan generaties in de hosted omgeving, terwijl gestructureerde prompts waardevoller worden voor nauwkeurige multi-referentie-, dialoog-, timing- en herhaalbare productietaken.
Waarom negeert MiniMax H3 prompts en wat is de beste testworkflow?
Wanneer een generatie mislukt, maakt het in één keer herschrijven van alles het lastiger om de ware oorzaak te achterhalen.
Veelvoorkomende H3-promptproblemen en oplossingen
| Probleem | Waarschijnlijke oorzaak | Eerste test om uit te voeren |
| Verkeerde persoon spreekt | Sprekertoewijzing onduidelijk | Vergrendel (S1)/(S2) |
| Personage verandert | Tegenstrijdige identiteitssignalen | Vereenvoudig referenties |
| Referentie genegeerd | Rol is ambigue | Wijs één taak toe |
| Willekeurige cuts | Te veel shot-instructies | Gebruik camerabeweging |
| Tijdstempel genegeerd | Gebruikt als actietiming | Reserveer uitsluitend voor cuts |
| FL2VA-sprongen | Ontbrekend overgangspad | Beschrijf intermediaire wijzigingen |
| Einde sluit niet aan | Zwakke convergentie | Vergrendel de eindcompositie |
| Ongewenste muziek | Audiolagen vermengd | Stel muziek expliciet in |
| Tekst verandert | Woordkeuze niet behouden | Citeer exacte zichtbare tekst |
| Video voelt gehaast | Te veel gebeurtenissen | Verminder actiemomenten |
Een handig principe is om een gecontroleerde vergelijkende test uit te voeren wanneer twee modi dezelfde taak aankunnen, in plaats van aan te nemen dat de complexere modus altijd een betere clip zal opleveren.
Een praktische stapsgewijze H3-testworkflow
Begin met het vaststellen van het acceptatiecriterium voor de generatie: wellicht is de identiteit van het personage het belangrijkst, of is het productlabel, de overgang naar het eindpunt, het eigendom van de dialoog of de camerabeweging juist niet-onderhandelbaar.
Test vervolgens in lagen: zet eerst het personage en de scène neer; voeg daarna beweging en camera toe; voeg stem en geluid pas toe nadat het visuele gedrag stabiel is; introduceer extra cuts, storyboards of extra personages pas nadat de eenvoudigere versie werkt. Hogeresolutie-regeneratie hoort pas te komen nadat het semantische resultaat correct is, omdat een hogere resolutie tegenstrijdige referentierolrelaties niet kan rechtzetten.
Deze stapsgewijze aanpak is met name handig in schaalbare videopijplijnen. Voor workflows die herhaalbare kennis of zakelijke content omzetten in video — inclusief document-naar-video trainingstools zoals Leadde — zorgt het scheiden van contentstructuur, visueel gedrag, AI-nasynchronisatie en eindsanering ervoor dat revisies eenvoudiger te isoleren zijn, zodat je niet voor elke aanpassing de volledige productie opnieuw hoeft te bouwen.
Bewaar geslaagde shots in plaats van alles opnieuw te genereren
Behandel voor langere projecten elke geslaagde clip als een gevalideerd productie-asset. Als Shot 1 en Shot 2 werken maar Shot 3 mislukt, genereer dan alleen dat mislukte gedeelte opnieuw in plaats van alles stroomopwaarts weg te gooien.
H3-communityworkflows gebruiken om deze reden al gecheckpointe shots: zodra een succesvol gedeelte is opgeslagen, kunnen stroomafwaartse experimenten opnieuw worden gedraaid zonder dat je herhaaldelijk de computationele en creatieve kosten betaalt om eerdere elementen opnieuw te creëren.
Dit leidt tot een breder productieprincipe:
Genereren → valideren → opslaan → doorgaan.
Bij AI-video groeit prompt-engineering uiteindelijk uit tot workflow-engineering.
Conclusie
MiniMax H3-prompting werkt het best wanneer de taak helder is gestructureerd in plaats van simpelweg omschreven met meer woorden. Kies de eenvoudigste modus die past bij het shot, beschrijf waarneembare veranderingen, scheid vaste attributen van variabelen, geef elke referentie een specifieke rol en los problemen per laag op. Voor geavanceerde Ref2VA-workflows schuilt het echte voordeel in het expliciet maken van de relaties tussen personages, beweging, camera, audio en keyframes — om vervolgens geslaagde generaties om te zetten in herbruikbare bouwstenen voor het volgende shot.