AIで長尺PDFをマイクロラーニング動画に生まれ変わらせる方法
長いPDFをAIで複数のマイクロラーニング動画にするには、AIを活用し、ページ数で単純に分割するのではなく、学習目標を中心にドキュメントを整理することが最も効果的です。AIは、主要な概念、手順、警告、依存関係を特定し、それぞれが明確な学習成果を達成できる短い動画モジュールへと変換できます。
このアプローチは、トレーニングマニュアル、オンボーディング資料、SOP、コース教材、製品ガイドなどに有効です。長大な知識も、より手軽に習得、確認、更新、再利用できるようになります。
Leaddeは、PDFやプレゼンテーションなどのドキュメントを、AIが生成したスクリプト、ナレーション、アバター、多言語出力を備えた構造化動画に変換することで、このワークフローをサポートします。このガイドでは、長いPDFを適切なマイクロラーニングモジュールに分割し、重要なコンテキストを保持しながら動画を効率的に生成し、長期的にシリーズの正確性を維持する方法を解説します。
長いPDFをAIで複数のマイクロラーニング動画にする方法:最適なワークフローとは?
実践的なワークフローは以下の通りです。
- PDFを精査する。 クリーンなテキスト、スキャン画像、表、図、付録、複雑なレイアウトが含まれているかを確認します。
- 構造を抽出する。 見出し、手順、定義、警告、例、相互参照を特定します。
- 知識マップを構築する。 どのアイデアが関連しているかを決定します。
- 学習目標を定義する。 各モジュール完了後に学習者が何を理解し、何ができるようになるべきかを決定します。
- マイクロラーニングモジュールを作成する。 動画ごとに1つの有用な成果を中心にソースコンテンツをグループ化します。
- スクリプトとビジュアルプランを生成する。 ページごとの読み上げではなく、説明に特化した内容に再構成します。
- AIで動画を制作する。 必要に応じて、音声、ビジュアル、キャプション、アバター、画面デモンストレーションを追加します。
- シリーズをレビュー・維持する。 ソースを検証し、モジュールを公開し、PDFが変更された場合は影響を受ける動画のみを更新します。
ページベースの分割が質の低いトレーニング動画を生み出す理由
PDFのページ構造は、学習のためではなく、読書のために設計されています。
ページ境界 ≠ 意味境界 ≠ 学習境界。
ある手順が12ページから始まり14ページまで続き、6ページの警告に依存する場合もあれば、逆に1ページに複数の無関係なポリシーが含まれることもあります。
より良い分割方法は、タスク、意思決定、概念、行動を中心にすることです。
技術的なチャンクは学習モジュールとは異なる
以下の3つの層で考えると理解しやすくなります。
ソース構造: ページ、見出し、表、付録 意味構造: 概念、手順、ルール、例外 学習構造: 目標、動画、演習
AIシステムが大規模なドキュメントを処理するために作成されたチャンクは、あくまで技術的な単位です。それが自動的に動画になるべきではありません。
AIは長いPDFをマイクロラーニングモジュールにどのように分析・分割すべきか?
AIにスクリプト作成を依頼する前に、まずソースの知識マップを作成しましょう。
スクリプト生成前に知識マップを構築する
抽出する項目:
- 概念と定義
- 手順と意思決定
- 前提条件
- 例
- 警告と例外
- 表と図
- 相互参照
スキャンされたPDFや複雑なPDFの場合、抽出品質が重要です。OCRの誤認識、列順序の誤り、表の解析ミスは、誤って解釈されたソース資料に基づいた動画生成につながる可能性があります。
原則はシンプルです。
構造が先。要約は後。
動画ごとに1つの有用な学習成果を設定する
有用な開始ルールは以下の通りです。
1つのタスク、意思決定、概念、または行動 = 1つのマイクロラーニング動画。
これは、固定された時間ではなく、各動画を明確な目標に焦点を当てることを推奨する現在の教育動画に関するガイダンスと一致しています。短い説明動画は約90秒で済むこともあれば、詳細なプロセスを扱う場合はそれより長くなることもあります。
次の場合に新しいモジュールを開始します。
- 学習目標が変わる場合
- タスクや意思決定が変わる場合
- 対象者が変わる場合
- 前提条件が変わる場合
- リスクレベルが変わる場合
- 必要な視覚的デモンストレーションが変わる場合
モジュール契約を作成する
各スクリプトを生成する前に、以下を定義します。
| 項目 | 質問 |
| 目標 | 学習者は何ができるようになるべきか? |
| 対象者 | 誰がこのモジュールを必要とするか? |
| ソース | どのPDFセクションが根拠となるか? |
| 前提条件 | 学習者は何をすでに知っているべきか? |
| 行動 | 視聴後、何が変化するべきか? |
| リスク | 誤解した場合、何が起こるか? |
| ビジュアル | 何を見せるべきか? |
| 評価 | 理解度はどのように確認されるか? |
これにより、AIが学習設計の一貫性を欠いた魅力的な動画を無計画に生成してしまうのを防ぎます。
重要なコンテキストを失わずにPDFを分割するには?
最大のリスクは、AIの幻覚(ハルシネーション)ではありません。それはコンテキストの喪失です。
例えば、PDFの31ページに次のように書かれているとします。
この手順は、カテゴリAの機械にのみ適用されます。
32~34ページにはその手順が記載されています。
AIが32~34ページのみを動画に変換した場合、各ステップは正しくコピーされても、最終的な学習内容は誤解を招く可能性があります。
コンテキストエンベロープを維持する
重要な指示には、以下の要素を保持しましょう。
前提条件 + 範囲 + 条件 + 警告 + 例外 + 結果
この「コンテキストエンベロープ」は、コンテンツがPDFから独立したモジュールに移行する際、指示とセットで移動させる必要があります。
動画間の依存関係をマッピングする
マイクロラーニングだからといって、すべてのクリップが独立して存在すべきというわけではありません。
シーケンスでは、以下のような構成が必要になる場合があります。
動画1:概念を理解する → 動画2:標準手順を実行する → 動画3:例外を処理する
Mayerのセグメンテーション原則は、複雑なマルチメディアを管理しやすいセグメントで提示することを推奨しますが、それらのセグメントには論理的な教育順序が必要です。
すべてのモジュールをPDFに紐付けて追跡可能にする
ビジネス上重要なトレーニングでは、シンプルなマッピングを維持しましょう。
| 動画 | 目標 | ソース | バージョン | レビュー |
| セキュリティインシデントの報告 | 正しい報告プロセスに従う | 31-34ページ + 7ページの警告 | v3.2 | 承認済み |
モジュールは非連続なソースセクションを使用できます。目標は教育的な完全性であり、ページの連続性ではありません。
各モジュールを効果的なマイクロラーニング動画にするには?
モジュールが完成したら、それを「話すPDF」ではなく「教える動画」へと変換しましょう。
読むためではなく、学ぶために書く
避けるべきこと:
PDF → 要約 → テキスト読み上げ
採用すべきこと:
ソース → 目標 → 説明 → 例 → 要約
実用的なマイクロラーニングスクリプトには、以下の要素を含めることができます。
- なぜこれが重要なのか
- 学習目標
- 主要な行動または説明
- 例またはデモンストレーション
- 警告またはよくある間違い
- 簡潔な要約
- (オプション)想起問題
動画は目標達成に必要な長さだけであるべきです。短ければ短いほど良いというわけではありません。
学習タスクに合わせたビジュアル形式を選択する
| コンテンツ | 推奨ビジュアル |
| ソフトウェアのワークフロー | 実際の画面録画 |
| 物理的な手順 | 実際の映像 |
| 概念またはプロセス | 図またはモーショングラフィック |
| ポリシーの説明 | ナレーション/アバター + コールアウト |
| シナリオ | ロールプレイングまたはアバターシーン |
| 製品の説明 | 製品のスクリーンショット |
| 要約 | テキスト + シンプルなビジュアル |
AIが生成する画像は、概念的なビジュアル、環境、絵コンテ、説明的なシナリオに役立ちます。ただし、学習者が正確なインターフェース、機械制御、医療行為、安全手順、技術的なラベルを再現する必要がある場合は、より慎重な検討が必要です。
コンテキストを生成し、指示に不可欠なビジュアルを検証する。
一括生成前に一貫性を確立する
10本、20本と動画を制作する前に、以下を定義しましょう。
- 用語
- ナレーターまたはアバター
- 発音
- 色とビジュアルスタイル
- キャプション
- シーンの慣例
- イントロ/アウトロのルール
Leaddeのようなプラットフォームは、ドキュメントの理解、動画生成、ナレーション、多言語ワークフローを、モジュールごとに手動で再構築することなく、同じ制作プロセス内で完結できるため、非常に有用です。
AI生成マイクロラーニング動画の正確性と学習品質をレビューするには?
AIは初稿作成を加速させますが、制作規模が拡大するにつれてレビューの重要性が増します。
ハルシネーションだけでなく、コンテキストの喪失もレビューする
専門家は以下の項目を検証する必要があります。
- 手順と順序
- 数字と日付
- 警告と例外
- 用語
- 図表
- 数式
- コンプライアンス関連の表現
- キャプション
- ビジュアルの正確性
ある記述は事実として正しくても、AIがそれを真実にした条件を削除した場合、誤解を招く可能性があります。
モジュールとシリーズをレビューする
モジュールレベルでは、動画が1つの明確で正確な成果を教えているかを確認します。
シリーズレベルでは、前提条件が正しく順序付けられているか、情報が重複または欠落していないか、そしてコレクション全体がソースドキュメントを正確に反映しているかを確認します。
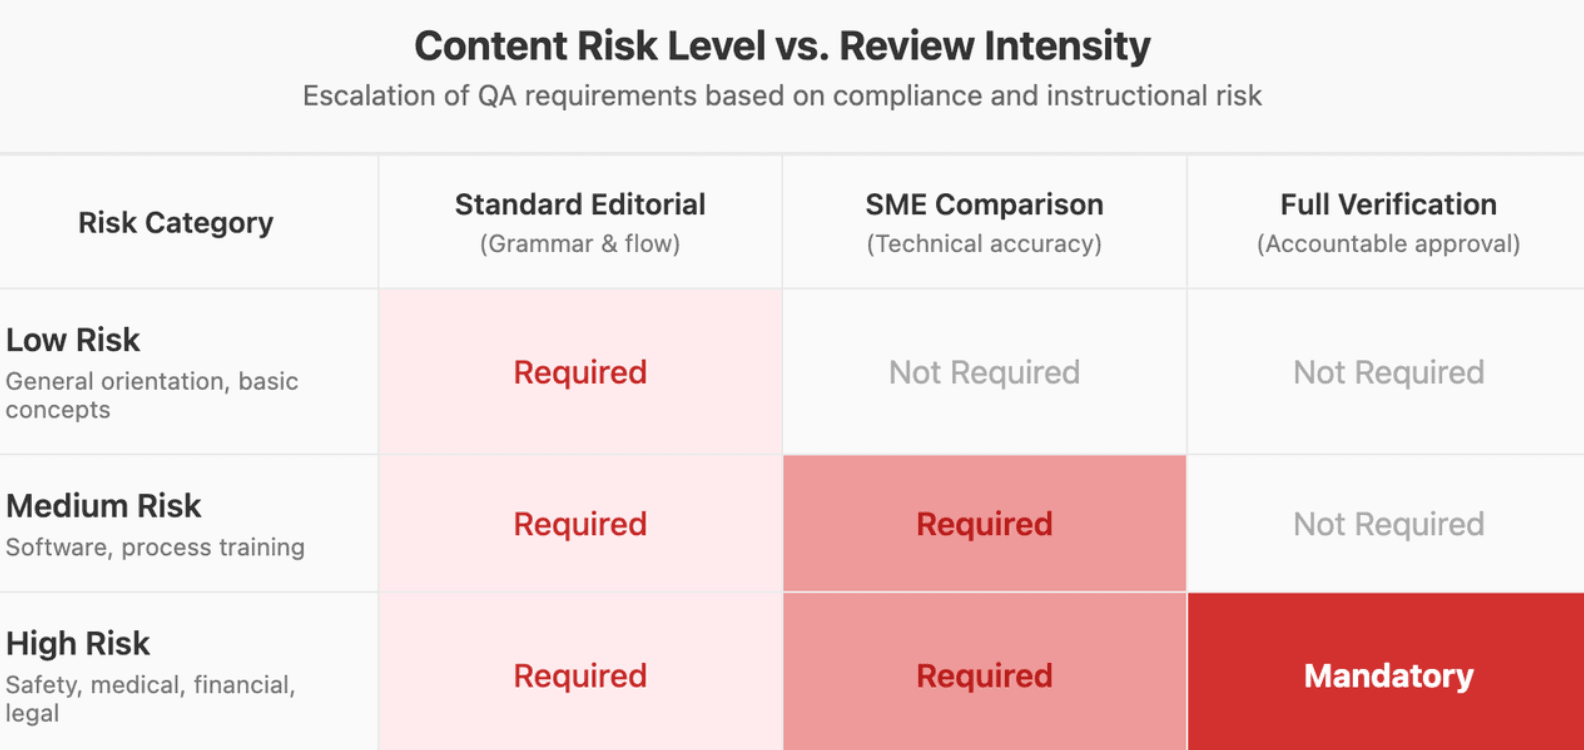
リスクベースの人間によるレビューを活用する
すべてのモジュールに同じ品質保証(QA)が必要なわけではありません。
- 低リスク: 一般的なオリエンテーション → 標準的な編集レビュー
- 中リスク: ソフトウェア/プロセス研修 → SME(Subject Matter Expert)によるソース比較
- 高リスク: 安全、医療、金融、法務、コンプライアンス → 完全なソース検証と責任者による承認
AIはチェックを支援できますが、高リスクな出力の最終承認者となるべきではありません。
マイクロラーニング動画シリーズを公開、測定、更新するには?
完成したクリップを単なるメディアファイルとして扱うのではなく、維持可能な学習システムとして捉えましょう。
学習者のワークフローに動画を組み込む
マイクロラーニングは、以下のような場所で活用できます。
- LMS
- オンボーディングポータル
- ナレッジベース
- ヘルプセンター
- 社内Wiki
- 製品アカデミー
- 現場でのQR体験
動画を想起問題、シナリオ、または後の復習と組み合わせることも可能です。
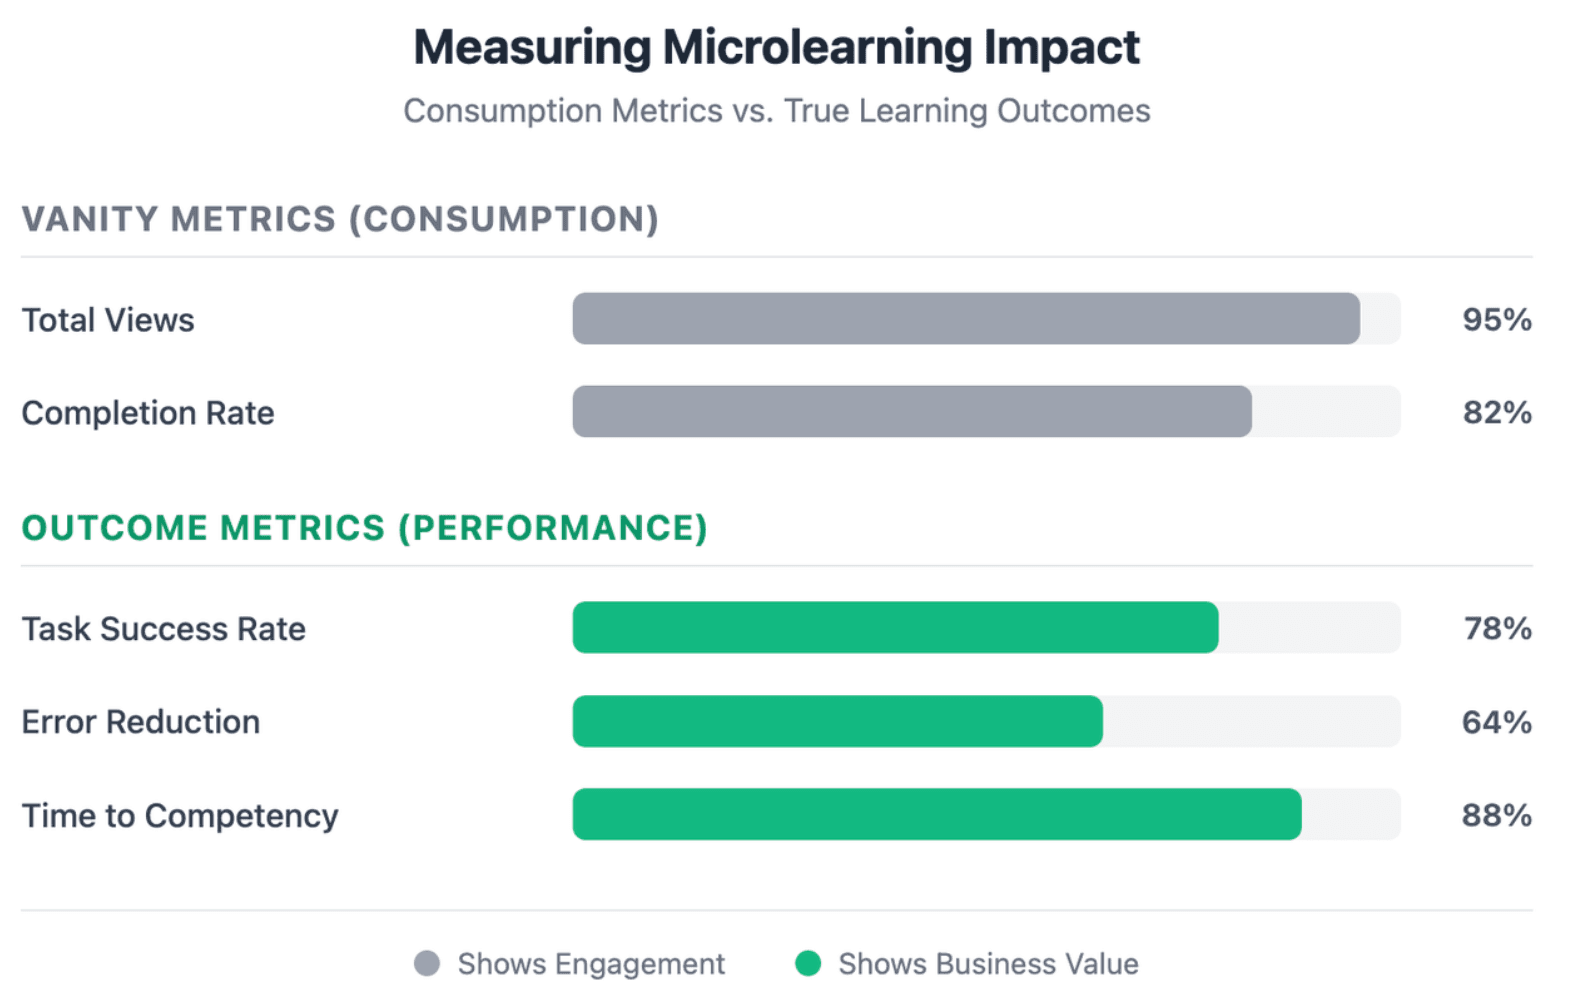
視聴数だけでなく、成果も測定する
視聴数や完了率はコンテンツの消費を示しますが、必ずしも学習の定着を示すものではありません。
目標に応じて、以下のような測定指標が有用です。
- クイズの成績
- タスクの成功率
- エラー率
- サポートチケット数
- 習熟までの時間
- 手戻り
- 学習者のフィードバック
ソース変更の影響を受けるモジュールのみを更新する
各動画について、以下の情報を維持しましょう。
ソースドキュメント + バージョン + ソースページ + SME所有者 + 最終レビュー日
その上で、以下の手順で更新します。
PDF v2 → 変更されたセクションを特定 → 影響を受けるモジュールを検索 → その動画を再生成 → レビュー → 置換
これこそがモジュール型マイクロラーニングの大きな利点です。2ページのポリシー変更があっても、40分のトレーニング動画全体を再構築する必要はありません。
FAQ
AIは長いPDFを自動的に複数の動画に変換できますか?
はい、AIはPDFを分析し、トピックや目標を特定し、スクリプトのドラフト作成、動画シーンの生成が可能です。しかし、完全に自動化されたページから動画への変換が、常に最適な教育ワークフローであるとは限りません。特に複雑な、技術的な、規制対象の、または安全上重要なドキュメントでは、人間によるレビューが不可欠です。
50ページのPDFはいくつのマイクロラーニング動画になるべきですか?
正しいページ対動画の比率というものはありません。ページ数ではなく、意味のある学習目標の数に基づいて動画数を決定します。ドキュメントの密度や目的によっては、数個の目標しか含まれないこともあれば、数十個の目標が含まれることもあります。
PDFの1章は1つのマイクロラーニング動画に相当すべきですか?
必ずしもそうではありません。1つの章に複数の学習目標が含まれることもあれば、1つの目標が複数の章や付録からの情報に依存することもあります。学習者が何を理解し、何ができるようになる必要があるかに応じて分割しましょう。
マイクロラーニング動画はどのくらいの長さであるべきですか?
普遍的な理想的な長さはありません。動画は、不要な情報を含まずに1つの明確な目標を達成するのに十分な長さであるべきです。マイクロラーニングに関する研究では、固定された時間ではなく、ターゲットを絞った一口サイズの指導が重要であると強調されています。
AIはPDFからの表、グラフ、図を正確に処理できますか?
AIは多くの構造化された要素を抽出・解釈できますが、これらには追加のレビューが必要です。表、数式、図、グラフは、抽出や簡素化の際にその関係性が失われる可能性があるため、公開前に必ずソースと照合して検証してください。
動画作成後も元のPDFを保持すべきですか?
はい。ほとんどのプロフェッショナルなワークフローでは、動画が説明、デモンストレーション、補強を提供する一方で、PDFは権威ある参照資料として保持すべきです。
動画は多言語に翻訳できますか?
はい。現代のAI動画ワークフローは、多言語ナレーションやローカライズされた動画バージョンを生成できます。ただし、翻訳されたコンテンツは、用語、ポリシーに関する表現、文化的背景、発音についてレビューされるべきです。
元のPDFが更新された場合、どうなりますか?
各モジュールがソースページとドキュメントバージョンにマッピングされていれば、影響を受ける動画を特定し、シリーズ全体を再作成するのではなく、該当モジュールのみを再生成することで古い動画コンテンツを更新できます。
結論
長いPDFをマイクロラーニング動画に変換することは、単なるファイル変換作業ではありません。最も効果的なワークフローは、AIを活用してドキュメントを動画に変換し、学習成果を中心に知識を整理し、コンテキストと追跡可能性を保持し、各モジュールに最適な動画形式を生成し、すべての動画を簡単にレビュー・更新できるようにすることです。その結果、単なるPDFの短縮版ではなく、維持管理可能な学習システムが構築されます。