MiniMax H3プロンプトガイド:ビデオ、Ref2VA、カメラ、オーディオ、参照プロンプトの効果的な作成術
優れたMiniMax H3プロンプトは、単なる視覚的スタイルの定義にとどまりません。時間の経過とともに何が起きるか、カメラがどう動くか、どのディテールを維持すべきか、各リファレンスが果たす役割、そしてセリフ・効果音・音楽がどのようにシーケンスに組み込まれるかを説明する必要があります。より高い制御性を得るための鍵は、適切なH3モードを選び、観測可能な変化を描写し、すべてのリファレンスに明確な役割を与えることです。
このガイドでは、T2VA、I2VA、FL2VA、L2VA、Ref2VA、カメラワーク、音声、キャラクターの一貫性、および実践的なトラブルシューティングについて解説します。これらの原則は、Leaddeのような構造化されたAI動画ワークフローにも適用されます。Leaddeでは、ドキュメント、トレーニング資料、製品情報をナレーションやアバター、多言語出力付きのスケーラブルな動画へと変換することができます(多言語AIアバターの作成方法も参照)。
MiniMax H3プロンプトガイド:最適なプロンプト構造とは?
MiniMax H3プロンプトを考える上で最も有益なアプローチは、それを「視聴覚の制作指示書」として捉えることです。「シネマティック」「リアル」「ドラマチック」といった単語を重ねる代わりに、クリップの展開に伴って視聴者が実際に何を目にし、何を聞くのかを描写することで、リアルなAI動画の作り方を理解しやすくなります。
シンプルなH3プロンプトの公式
日常的なプロンプト作成では、以下の公式から始めましょう:
被写体 + アクション + 環境 + カメラ + タイミング + オーディオ
例えば、「雨の駅にいる女性」という表現ではシーンの設定はできますが、時間経過に関する情報はほとんど生まれません。より強力なプロンプトであれば、彼女がプラットフォームに向かって歩き、電車の近づく音を聞いて立ち止まり、音の方へ振り向き、スローなトラッキングカメラがそれを追う、という一連の流れを説明します。
MiniMaxの公式ベースプロンプトガイドでは、このアイデアを3つのフィールドに落とし込んでいます。integrated_multimodal_description、overall_soundscape、そしてnon_diegetic_musicです。1つ目は視覚的なタイムライン、アクション、ショット、話者、セリフ、および同期されたシーン音声を担い、残りの2つは環境音・物理音と、視聴者だけが聴く背景音楽を分離します。
単なる形容詞ではなく、観測可能な結果を書く
実用的なルールとして、抽象的な意図を視覚的な行動へと変換することが挙げられます。
代わりに**「彼女は自信に満ちているように見える」**と書くのではなく、堂々と歩き、アイコンタクトを維持し、ジャケットを直して、迷うことなく立ち止まる様子を描写します。
このアプローチは制約事項に対しても有効です。「ズームインしないでください」と繰り返す代わりに、目指す結果を記述します:「被写体は最初から最後までフレーム内でほぼ同じ大きさを維持する」。コミュニティによるH3の一貫性テストでは、定性的な指示を繰り返すよりも、測定可能なフレーミングの制約を指定した方が、その特定のワークフローにおいてより良い結果が得られたと報告されています。これはあくまで現場での観察に基づくものであり、MiniMaxの公式保証ではありません。
どのMiniMax H3モードを使用すべきか?
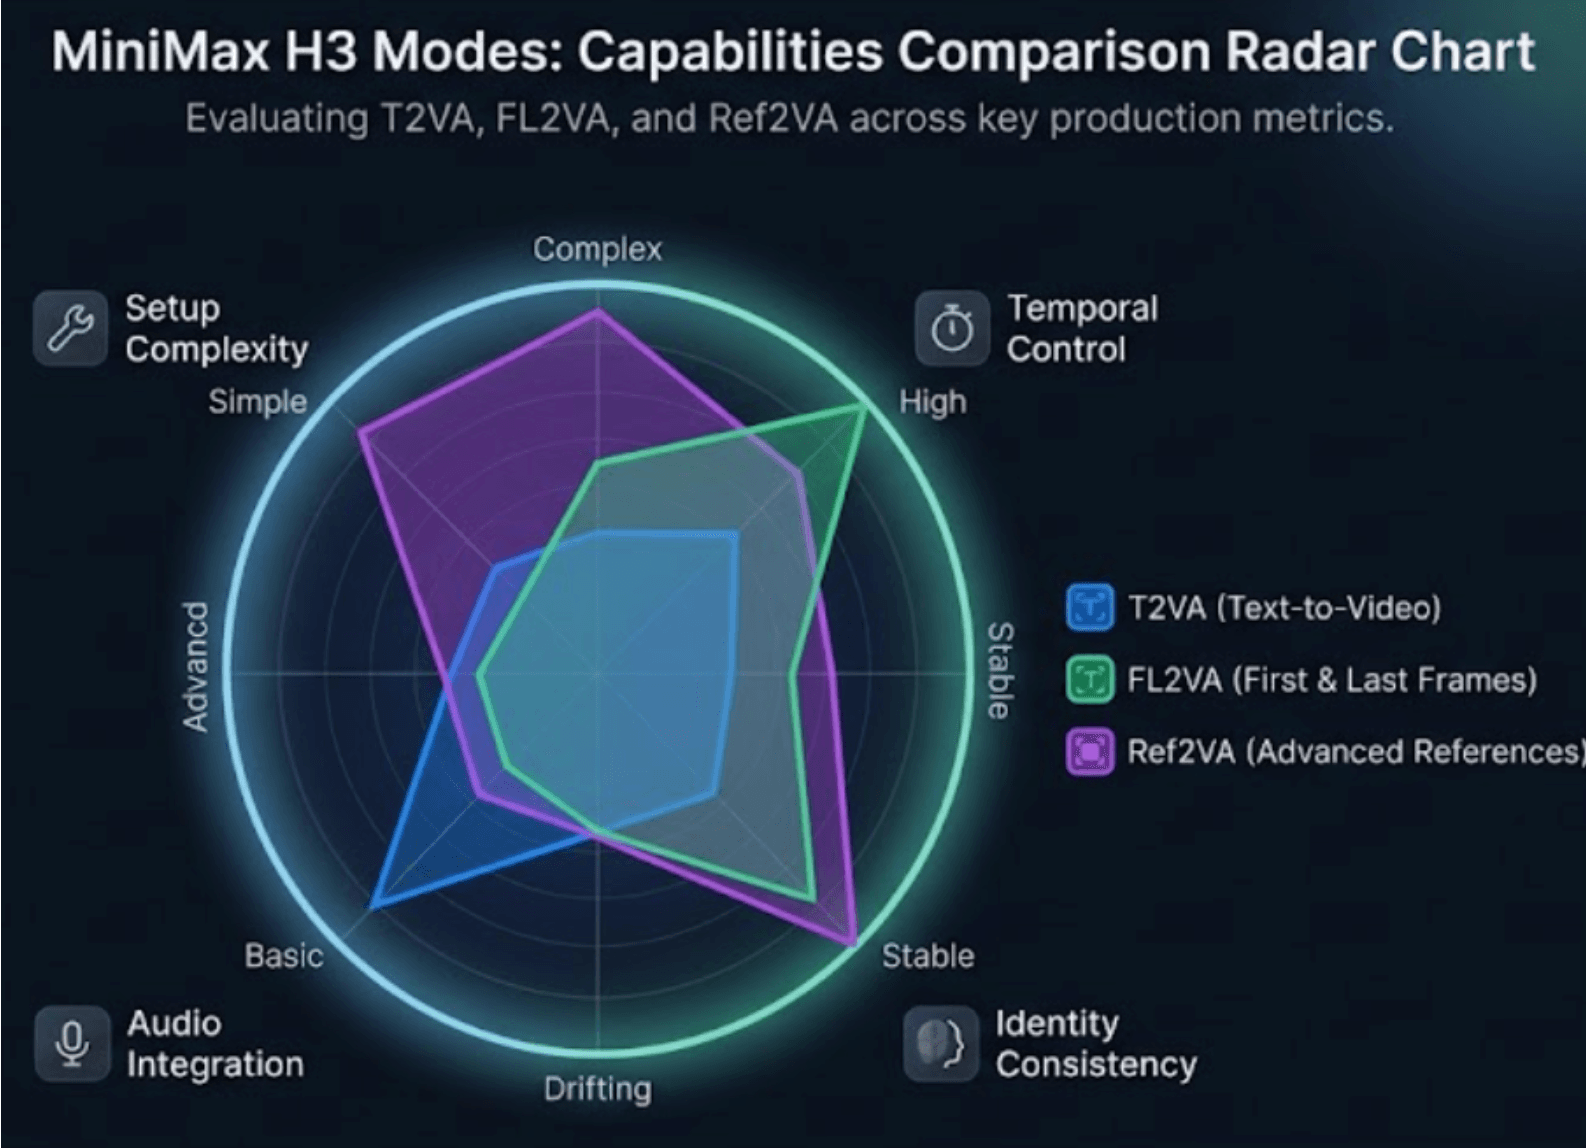
適切なモードを選択することは、プロンプトを書き直すことと同じくらい重要です。MiniMaxのベースワークフローは、テキストのみの生成に加え、先頭フレーム、末尾フレーム、および最初と最後のフレーム指定タスクをサポートしており、一方の独立したRef2VAチェックポイントはマルチモーダル参照の生成を処理します。
| モード | 入力 | 最適なプロンプトの目的 |
| T2VA | テキスト | 完全な視聴覚シーンの構築 |
| I2VA | 最初のフレーム | オープニングを維持し、そこから展開させる |
| FL2VA | 最初 + 最後のフレーム | 両端の間のトランジションを描写する |
| L2VA | 最後のフレーム | 提供された結末に向けて構築する |
| Ref2VA | 画像 / 動画 / 音声 | 異なる参照ロールを組み合わせる |
T2VA、I2VA、FL2VA、L2VA
T2VAはゼロからシーンを構築する必要があります。I2VAは提供された画像を実際の最初のフレームとして扱うため、プロンプトでは動きを導入する前に、アイデンティティ、服装、オブジェクト、色彩、構図を維持させる必要があります。
FL2VAでは、単に画像1と画像2を説明するのではなく、その間の観測可能な経路を記述することがMiniMaxによって推奨されています。被写体がどう動き、ポーズがどう変わり、オブジェクトがどう操作され、構図やライティングが最終フレームにどう収束するかを説明します。L2VAは、妥当な初期状態から始めて徐々に指定された最終フレームに着地させるという、逆のアプローチを取ります。
Ref2VAはいつ使用すべきか?
異なるアセットがそれぞれ異なる役割を果たす場合(例:1枚の画像がキャラクターを定義し、別の画像が服装を定義し、動画が歩行モーションとカメラのリズムを提供し、音声が声の参照を提供するような場合)には、Ref2VAを使用します。
これは関係性主導の生成として理解すると分かりやすいでしょう。モデルは、各ファイルに何が含まれているかだけでなく、各ソースからの情報が最終的な動画にどのように影響すべきかを把握する必要があります。MiniMaxのフルリファレンス形式では、再利用可能な被写体、具体的な画像アンカー、動画レベルのタイムソース、および音声リファレンスが明確に区別されています。
ショットを解決できる最もシンプルなモードを使用する
実践的な制作ルールとして、ショットに必要がない限り、参照の複雑さを増やさないことが挙げられます。
トランジションに正確な開始と終了だけで十分な場合、FL2VAを使うことでタスクを直接的に定義できます。画像1のアイデンティティ+動画1のモーション+音声1の声といった関係性がどうしても必要な場合に、Ref2VAへ移行しましょう。
これによりデバッグも容易になります。競合する独立した制約が少なくなればなるほど、問題の原因がモーション、アイデンティティ、フレーミング、音声のどこにあるのかを特定しやすくなります。
ショット、カメラワーク、タイミング、トランジションをどう制御するか?
H3プロンプトは、タイムラインを単なる段落ではなく編集のように扱うことで、よりコントロールしやすくなります。
ショットカット、タイムスタンプ、時間的予算
MiniMaxの公式フォーマットでは、[Shot 1] のようにタイムスタンプを付与することはしません。以降のショットは、[Shot 2] At 00:03.500 のように、時間経過に伴うカット時間から始まります。新しいショットでは、異なる視点、場所、状態、被写体、時間など、意味のある新しい情報を導入する必要があります。小さな距離や角度の変化は、別のカットにするよりもカメラワークとして表現する方が通常は効果的です。
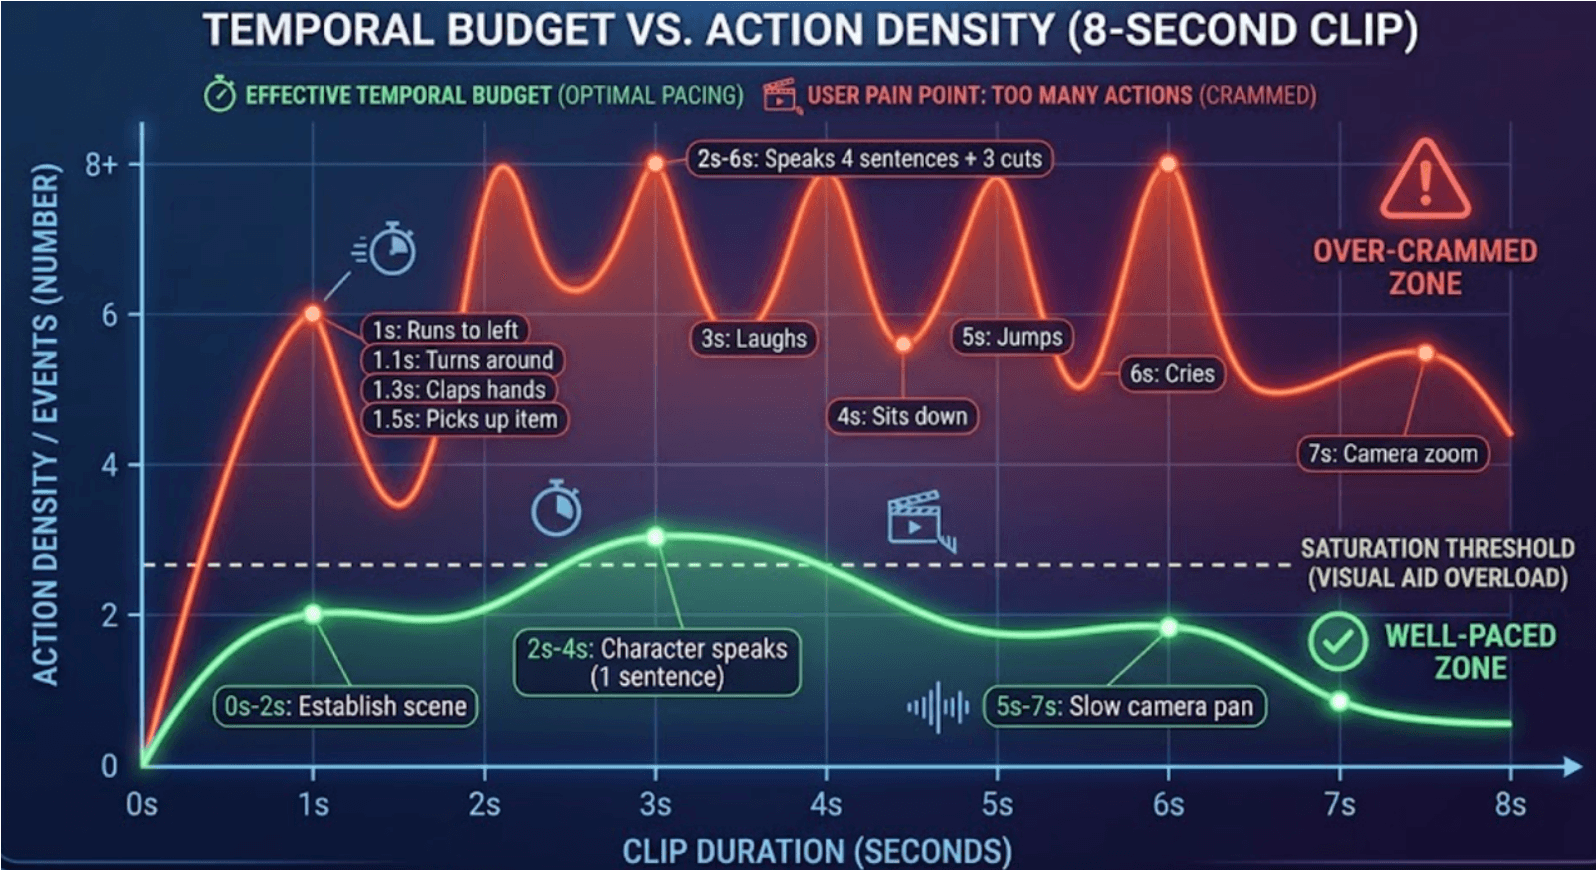
これにより、実質的な時間的予算が生まれます。8秒間のクリップ内では、3つのアクション、2つのカメラ移動、リアクション、発話のセリフ、そして2つのカットが、限られた時間を奪い合います。生成された動画に急かされているような印象を受ける場合は、説明的な言葉を追加するよりも、イベントを削る方がうまくいきます。
H3が追従できるカメラ用語
MiniMaxのドキュメントには、プッシュ/プル、パン、トラック、チルト、ペデスタル、アーク、トラッキング、固定ショット、POV、ロール、カメラシェイクなどのカメラ操作が記載されています。推奨される論理構造は基本的に以下の通りです:
モーションタイプ + オプションの振幅 + オプションのスピード
したがって、「ダイナミックでシネマティックなカメラ」と書く代わりに、**「製品を中央に捉えたまま、カメラがゆっくりと右へトラックする」**といった実行可能な記述を行います。
固定すべきものと変化させてよいものを分離する
生成を行う前に、頭の中で簡単な固定・可変マップを作成しましょう。
プロダクト動画の場合、ボトルの形状、ラベルのテキスト、キャップ、色は固定し、カメラ位置、反射、水面の動き、ライティングは変化させるといった指定が必要になることがあります。キャラクターのシーケンスであれば、顔、髪型、衣装をロックしつつ、ポーズや表情は変化させることが可能です。
これにより、プロンプトがすべての視覚적特性を同時に変化させようとして矛盾した指示を出してしまう事態を防げます。
キャラクターや製品の一貫性を保ったままリファレンスを使用するには?
最も効果的なリファレンスワークフローでは、すべてのアセットに明確な目的を割り当てます。
すべてのリファレンスに1つの明確な役割を与える
次のような割り当てが実用的です:
画像1 → キャラクターのアイデンティティ 画像2 → 服装 画像3 → 製品デザイン 動画1 → 歩行モーションとカメラの軌道 音声1 → 声の音色
MiniMaxの公式Ref2VAフォーマットは、まさにこのようなクロスソースの定義をサポートしています。1つの被写体が画像から外見を取得し、動画からモーションを取得する一方、1つの参照ファイルから複数の再利用可能な被写体を提供することも可能です。
重要なのは、意図しない転送を避けることです。動画1がモーションを提供すべきであっても、その俳優や環境まで引き継がせたくない場合は、関係性の設計においてその旨を明示してください。
被写体、画像、ストーリーボード、参照動画
公式の用語では、<Subject N> は再利用可能な視覚的コンテンツを表し、<Picture N> は画像自体が具体的なフレーム、構図のアンカー、または動画の台本やストーリーボードの参照として機能する場合に使用されます。<Video N> は、編集、継続、カメラ移動、カット、リズム、時間的構造などの動画全体に関わる関係性を表します。<Audio N> は、音声のコピーや、声の音色、デリバリー、リズム、音楽スタイルなどの特性を処理します。
この区別により、よくある概念的なエラーを防ぐことができます。つまり、キャラクターリファレンスは自動的にキーフレームになるわけではなく、ストーリーボードが自動的に正確なエンドポイントになるわけでもないということです。
リファレンスの経済性とショット単位の一貫性
リファレンス素材が多ければ多いほど情報量が増えるとは限りません。制作ワークフローにおいては、必要な動き、カメラの軌道、または声の質を明確に示している部分だけをトリミングして使用しましょう。
また、最初のフレームだけでなく、ショット全体を通してアイデンティティを評価してください。あるコミュニティテストでは、ユーザー固有のローカル設定において、顔の小さなフレーミングに比べてクローズアップの方が、アイデンティティの崩れが大幅に早く発生することが分かりました。正確なタイミングを一般化することはできませんが、ワークフロー上の教訓としては非常に有益です。つまり、重要なショットの要所要所で、顔のアイデンティティ、服装、小さな小道具をチェックするということです。
高度なRef2VA、セリフ、および音声プロンプティングの仕組みとは?
Ref2VAを使用することで、H3のプロンプティングは従来のテキストから動画生成というよりも、マルチモーダルな制作プランニングに近いものになります。
6つのパーツで構成されるRef2VAプロンプト構造
MiniMaxのフルリファレンスガイドでは、6つのセクションが定義されています:
subject_definitions → summary → retention_analysis → detailed_description → overall_soundscape → non_diegetic_music。
システムはまずリファレンスの意味を定義し、次にタスクを要約し、各リファレンスがどのように保持または転送されるかを説明し、最後に再生順にターゲットとなる動画を記述します。
形式的なプロンプトを書く前の段階として、次のようなプランニングレイヤーが役立ちます:
| ソース | 保持するもの | 転送するもの | 無視するもの |
| 画像1 | 顔、髪 | — | 背景 |
| 動画1 | — | 歩き、カメラ | 俳優のアイデンティティ |
| 音声1 | 声の音色 | 語り口 | 元のセリフ |
これにより、「これらすべてのリファレンスを使ってくれ」という曖昧な要求が、明示的なソースからターゲットへの関係性へと変換されます。
セリフ、声、効果音、音楽
発話するキャラクターには (S1) や (S2) といった安定したIDが使用され、セリフは <d>[Language] ...</d> の中に配置されます。また、MiniMaxは画面内のセリフと画面外のナレーションを区別しており、画面上のキャラクターがナレーションのみを行っている場合は、そのキャラクターの口を確実に閉じさせておくことを推奨しています。
環境音や物理的な効果音はサウンドスケープに属し、non_diegetic_music はキャラクターではなく視聴者が聴く音楽のために予約されています。足音、雨、オブジェクトの音は欲しいがBGMは不要な場合は、サウンドスケープを維持したまま non_diegetic_music: N/A に設定します。
自然言語プロンプト vs 公式構造化プロンプト
ホスト型のH3システムでは、短い自然言語の指示でも依然として機能します。これは、MiniMaxが H3-Context-IR を使用しているためです。これは、H3-Base向けの構造化表現を生成する前に、テキスト、画像、動画、音声の間の関係性を解釈する前処理レイヤーです。オープンモデルカードでは、指示の解析、クロスモーダルな関連付け、時間的理解、論理的推論がそのプロセスの一部として説明されています。
このことは、一見した矛盾を説明してくれます。つまり、シンプルなプロンプトは、ホスト環境でのシンプルな生成に適している一方で、正確なマルチリファレンス、セリフ、タイミング、および反復可能な制作タスクにおいては、構造化されたプロンプトの価値が高まるということです。
なぜMiniMax H3はプロンプトを無視するのか?最適なテストワークフローとは?
生成に失敗したとき、すべてを一度に書き直すと、原因の特定が難しくなります。
よくあるH3プロンプトの問題と修正方法
| 問題 | 考えられる原因 | 最初にテストすべきこと |
| 違う人物が話す | 話者のマッピングが曖昧 | (S1)/(S2)をロックする |
| キャラクターが変わってしまう | 矛盾するアイデンティティ信号 | リファレンスをシンプルにする |
| リファレンスが無視される | 役割が曖昧 | 1つの役割を割り当てる |
| ランダムなカット | ショットの指示が多すぎる | カメラモーションを使用する |
| タイムスタンプが無視される | アクションのタイミングとして使用されている | カット用に予約する |
| FL2VAでジャンプが起きる | 遷移のパスが欠落している | 中間的な変化を描写する |
| エンディングが合わない | 収束が弱い | 最終構図をロックする |
| 不要な音楽が入る | オーディオレイヤーが混ざっている | 音楽を明示的に設定する |
| テキストが変わる | 文言が保持されていない | 表示すべきテキストを正確に引用する |
| 動画が急ぎ足に感じる | イベントが多すぎる | ビートを減らす |
より複雑なモードが常に優れたクリップを生み出すと仮定するのではなく、同じタスクを複数のモードで解決できる場合は、制御された比較を行うことが有効な原則となります。
実践的なステップバイステップのH3テストワークフロー
まずは生成における受入基準を定義することから始めましょう。キャラクターのアイデンティティが最も重要なのか、製品のラベル、エンドポイントのトランジション、セリフの持ち主、あるいはカメラワークが譲れないのかを明確にします。
次に、レイヤーごとにテストを行います:まずキャラクターとシーンを確立し、次にモーションとカメラを追加し、視覚的行動が安定してから声と音を追加します。追加のカット、ストーリーボード、または追加のキャラクターは、よりシンプルなバージョンが機能するようになってから初めて導入します。高解像度での再生成は、セマンティックな結果が正しくなってから行うべきです。なぜなら、高解像度は矛盾したリファレンス関係を解決することはできないからです。
この段階的なアプローチは、スケーラブルな動画パイプラインにおいて特に有効です。繰り返し可能な知識やビジネスコンテンツを動画に変換するワークフロー(LeaddeのようなSOPドキュメントを数分でトレーニング動画に変換するツールを含む)において、コンテンツ構造、視覚的行動、AIナレーション、そして最終レンダリングを分離することで、制作全体を作り直すことなく、修正箇所を簡単に切り分けることができるようになります。
すべてを再生成する代わりに、成功したショットを保存する
長期的なプロジェクトでは、成功したクリップをそれぞれ検証済みの制作アセットとして扱います。ショット1とショット2は成功したもののショット3が失敗した場合、上流のすべてを破棄するのではなく、失敗したセクションだけを再生成します。
コミュニティのH3ワークフローがこの理由からチェックポイント化されたショットを使用しているのはそのためです。一度成功したセクションを保存しておけば、以前の素材を再作成するための計算コストやクリエイティブコストを何度も支払うことなく、下流の実験をやり直すことができます。
これは、より広範な制作原則へとつながります:
生成する → 検証する → 保存する → 続ける。
AI動画制作において、プロンプトエンジニアリングはやがてワークフローエンジニアリングへと進化します。
結論
MiniMax H3のプロンプティングは、単に言葉を増やすのではなく、タスクが明確に構造化されている場合に最も効果を発揮します。ショットに適合する最もシンプルなモードを選び、観測可能な変化を描写し、固定属性と可変属性を分離し、すべてのリファレンスに特定の役割を割り当て、レイヤーごとにデバッグを行いましょう。高度なRef2VAワークフローにおいて真の強みとなるのは、キャラクター、モーション、カメラ、音声、キーフレーム間の関係性を明示し、成功した生成結果を次のショットのための再利用可能なビルディングブロックへと昇華させることにあります。