GPT Image 2.5 Recension: Flare vs Sunburst, Prissättning & Tester
GPT Image 2.5 är en betydande uppgradering om du prioriterar precis redigering, konsekvent referenshantering och kontrollerbara arbetsflöden framför att bara generera en snygg bild på första försöket. OpenAI erbjuder nu två API-modeller – Flare för snabbare vardagsgenerering och Sunburst för precisionsfokuserat arbete – med starkare redigering i flera steg, textåtergivning, referenstrohet och stöd för högkvalitativa produktionsarbetsflöden.
I denna recension av GPT Image 2.5 granskar jag hur den presterar i verkliga tester, vad som skiljer Flare och Sunburst åt, hur prissättning och kvalitetsinställningar påverkar resultaten, och hur den står sig mot modeller som Nano Banana Pro. Jag kommer också att undersöka de problem som fortfarande spelar roll i produktionen, inklusive oönskade redigeringar, kvalitetsförlust vid upprepade redigeringar, syntetiska texturer och typografi.
För team som vill gå bortom fristående bildgenerering integrerar Leadde för närvarande GPT Image 2.5 Flare i sin kreativa arbetsyta, så att genererade produktbilder, kampanjmaterial och storyboardbilder kan fortsätta in i bildspels- och AI-videoarbetsflöden utan att byta verktyg.
Recension av GPT Image 2.5: Är den verkligen bättre än GPT Image 2?
Kortfattad bedömning: Vad GPT Image 2.5 faktiskt förbättrar
Ja – men den största förbättringen är kontroll snarare än rå estetik.
OpenAI framhåller Images 2.5 för bättre bevarande av personer och objekt från referensbilder, mer precisa redigeringar, starkare konsekvens över flera redigeringar samt mer naturlig belysning och texturer. Flare positioneras också för att leverera resultat av högre kvalitet än GPT Image 2 med upp till 50 % lägre latens.
Detta förändrar hur modellen bör utvärderas. I ett produktionsarbetsflöde är den viktiga frågan inte bara: ”Ser den första bilden bättre ut?” Den är också:
Hur mycket redan godkänt arbete överlever nästa redigering?
En modell som skapar en vacker första bild men tvingar dig att bygga om kompositionen efter varje liten ändring kan skapa mer arbete än en något mindre dramatisk modell som bevarar det som redan har godkänts.
GPT Image 2 vs GPT Image 2.5: Vad har förändrats?
| Område | GPT Image 2 | GPT Image 2.5 |
| API-modeller | Enkel huvudmodell | Flare + Sunburst |
| Redigering | Kapabel | Mer målinriktad och konsekvent |
| Referenstrohet | Stark | Förbättrad |
| Kvalitetsnivåer | Låg, medel, hög | Låg till max |
| Hastighet | Tidigare baslinje | Flare upp till 50 % lägre latens |
| Arbetsflödesfokus | Generering + redigering | Snabbare iterativ produktion |
Båda 2.5 API-modellerna stöder low, medium, high, xhigh, max och auto. OpenAI listar för närvarande samma tokenpriser för Flare och Sunburst.
En migrationsdetalj förtjänar uppmärksamhet. I Toseas API-test med 41 anrop använde GPT Image 2.5:s high samma budget för utgående tokens som GPT Image 2:s medium, medan 2.5:s max matchade den gamla high. Detta är en oberoende observation, inte en officiell OpenAI-mappning, men det innebär att utvecklare bör jämföra ekvivalenta arbetsbelastningar istället för att anta att samma kvalitetsmärkning ger samma utgående budget.
Hur bra är GPT Image 2.5 på bildkvalitet, text och referenskonsekvens?
Fotorealism, belysning och texturkvalitet
OpenAI uppger att Images 2.5 producerar mer naturlig belysning och texturer, och att referensobjekt är mer benägna att förbli igenkännbara.
Oberoende tester tyder på att bilden är mer nyanserad. Curious Refuge fann att GPT Image 2.5 var mycket kapabel att förstå visuella uppgifter, men observerade överdrivet skärpt hud och syntetiska fina detaljer i vissa fotorealistiska porträtt. I sina jämförelser producerade Nano Banana Pro ofta mer naturlig hud och renare fotografisk textur.
Denna distinktion är viktig: visuell intelligens och fotorealism är inte samma måttstock. GPT Image 2.5 kan förstå en svår redigering bättre även när en annan modell skapar ett mer naturligt porträtt på första försöket.
Kan GPT Image 2.5 generera korrekt text och följa komplexa prompter?
Detta är ett av dess starkaste områden.
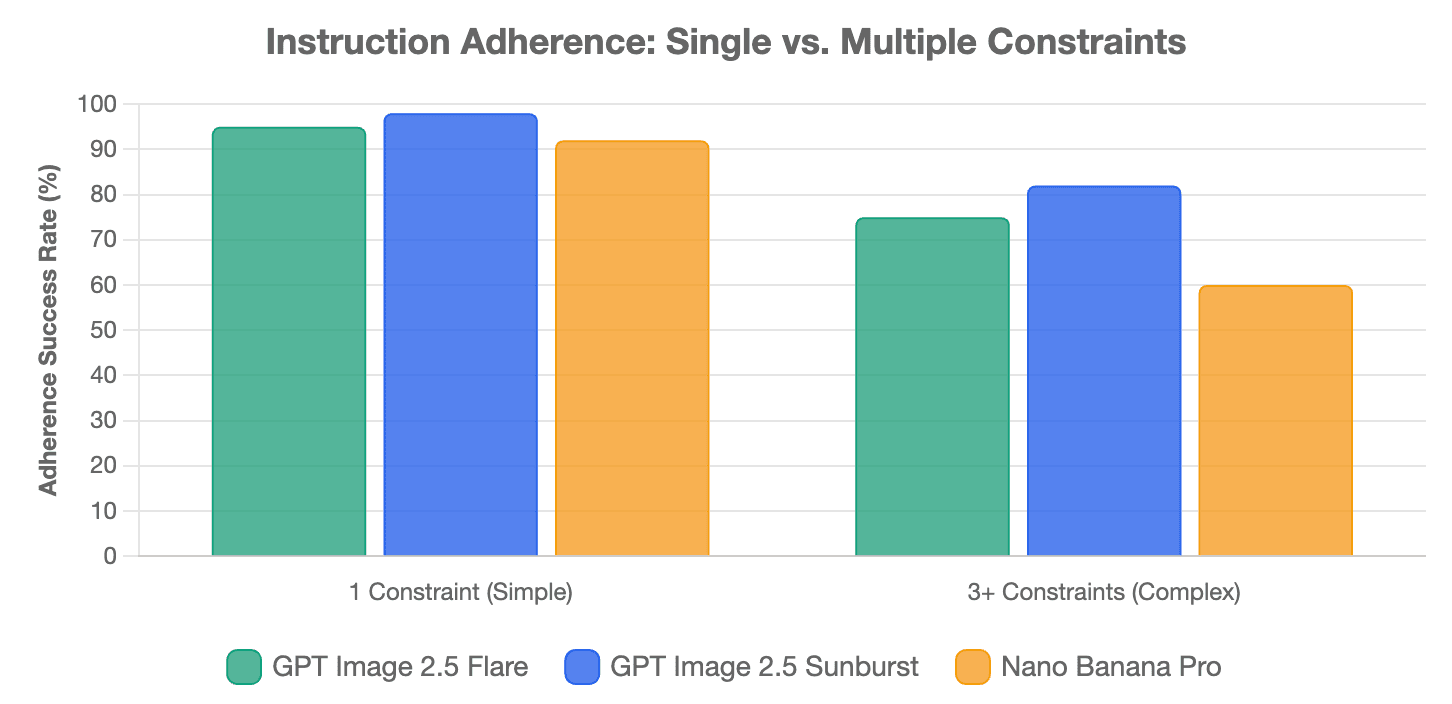
Puter gav Flare och Sunburst samma prompt för en reseaffisch som innehöll tre exakta textelement och en definierad layout. Båda återgav alla tre delarna utan stavfel, även om Flare följde den begärda formateringen mer bokstavligt medan Sunburst lade till extra scendetaljer.
MindStudio fann också stark bokstavlig instruktionsföljsamhet i tester som en klocka som visade 5:15 och ett vinglas fyllt till brädden. Men prestandan försämrades när flera oberoende begränsningar staplades i samma scen, vilket skapade rumsliga och anatomiska misstag.
Den praktiska slutsatsen är enkel: korrekt textgenerering är inte detsamma som färdig professionell typografi. Affischer, förpackningar, etiketter och småskriftsdesigner bör fortfarande korrekturläsas innan publicering eller tryckning.
Karaktärs-, produkt- och multireferenskonsekvens
Referenshantering är där GPT Image 2.5 blir särskilt användbar för kommersiella arbetsflöden.
Curious Refuge testade en karaktärsreferens, en kompositionsreferens och en stilreferens tillsammans. GPT Image 2.5 bevarade den begärda kompositionen närmare samtidigt som den integrerade karaktären och den visuella stilen. Den presterade också bra när den ersatte produkter i livsstilsfotografi samtidigt som den anpassade perspektiv, belysning och miljöinteraktion.
En användbar produktionsteknik är referensrollbindning: berätta för modellen exakt vad varje referens kontrollerar. Till exempel kontrollerar en bild identitet, en annan kläder och en tredje komposition. Detta minskar tvetydigheten när flera referenser innehåller konkurrerande visuell information.
Hur precis är GPT Image 2.5:s bildredigering?
Kan den ändra en sak utan att ändra allt annat?
Puter testade Flare genom att bara ändra ett barns röda tröja till en smoking samtidigt som förändringar utanför klädområdet mättes. I det enskilda testet överskred endast 0,22 % av pixlarna utanför det definierade redigeringsområdet dess förändringströskel, med ett SSIM på 0,938 utanför redigeringen.
Detta är ett användbart bevis på lokaliserad redigering, men det bör inte tolkas som en universell ”99,78 % bevarandegrad”. Det var en bild, en prompt och en generering.
Det bredare värdet är att målinriktad redigering kan minska behovet av att återskapa en hel godkänd komposition bara för att en produkt, färg, bakgrundselement eller textrad behöver ändras.
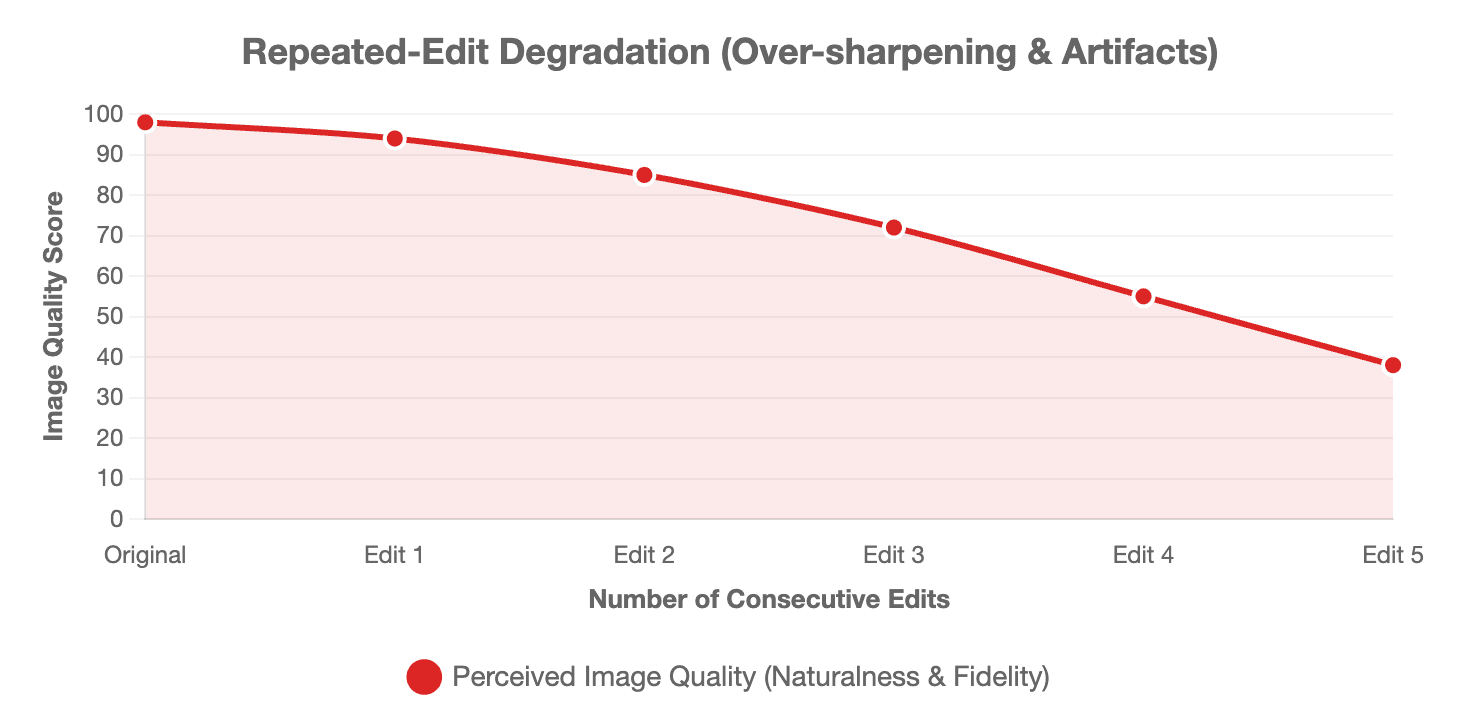
Redigering i flera steg: Konsekvens kontra bildförsämring
OpenAI designade Images 2.5 explicit för att mer tillförlitligt behålla tidigare detaljer över flera redigeringar.
Men semantisk konsekvens skiljer sig från bevarande av bildkvalitet.
Curious Refuge fann att upprepade redigeringar gradvis gjorde en testbild skarpare, mer mättad och mer syntetisk. Deras rekommendation var att använda målinriktade redigeringar och återgå till en tidigare ren version när större ändringar krävs.
Ett praktiskt tillvägagångssätt är att upprätthålla en ”behåll-lista” med varje viktig redigering: identitet, pose, beskärning, kameraposition, produktgeometri, bakgrund, logotyp, ljusriktning och redan godkänd text. Om en version godkänns, förgrena framtida experiment från den kontrollpunkten istället för att oändligt redigera den senaste genereringen.
När bör du sluta prompta och istället använda Photoshop eller Figma?
Generativ redigering är värdefull, men det är inte alltid det slutgiltiga produktionsverktyget.
Om ett leveransobjekt kräver pixelexakta logotyper, juridisk text, precisa diagramvärden, arkitektoniska dimensioner eller slutgiltig typografi, är deterministisk redigeringsprogramvara oftast säkrare.
Ett användbart hybridarbetsflöde är ”patch-redo” redigering: beskär det problematiska området från en högupplöst originalbild, använd AI-modellen för att endast reparera den sektionen, och sammanfoga sedan den korrigerade regionen tillbaka till det godkända originalet. Detta bevarar mer av den färdiga tillgången istället för att be modellen att bygga om allt.
GPT Image 2.5 Flare vs Sunburst: Vilken modell ska du använda?
Flare vs Sunburst: Hastighet, precision och kvalitet
| Område | Flare | Sunburst |
| Primär roll | Snabb vardagsgenerering | Precisionsfokuserat kreativt arbete |
| Bäst för | Iteration, sociala medier, produktkoncept, volym | Detaljerade redigeringar, premiumtillgångar |
| Publicerade tokenpriser | Samma | Samma |
| Genereringstid | Snabbare | Längre |
| Standard API-val | Ja, för de flesta applikationer | Använd när extra precision är viktig |
OpenAI rekommenderar Flare som standardval för de flesta applikationer och Sunburst för premiumarbetsflöden som kräver stramare kontroll över redigeringar.
Sunburst är inte bara ”Flare fast bättre”. I Puters affischtest med samma prompt följde Flare den begärda formateringen mer bokstavligt, medan Sunburst skapade en rikare scen men introducerade en hamn, båtar och en pir som inte hade begärts. Sunburst tog också ungefär dubbelt så lång tid i just det testet.
Hur snabb är GPT Image 2.5, och vad kostar den?
OpenAI listar Flare till 5 USD per miljon text-input-tokens, 8 USD per miljon bild-input-tokens och 30 USD per miljon bild-output-tokens; Sunburst använder samma publicerade priser.
Toseas test med matchade tokens fann att Flare i genomsnitt tog 19,7 sekunder jämfört med 37,3 sekunder för GPT Image 2 på dess 2048×1152 bildarbetsbelastning, medan Sunburst i genomsnitt tog 27,7 sekunder. Dessa resultat stöder riktningen för OpenAIs latenspåstående, men de är arbetsbelastningsspecifika snarare än en universell hastighetsgaranti.
För produktionsteam är kostnad per godkänd bild ofta mer användbart än kostnad per generering. Ett billigare anrop som kräver fyra nya försök kan kosta mer – i API-utgifter och mänsklig granskningstid – än en dyrare generering som godkänns omedelbart.
Ska du börja med Flare och avsluta med Sunburst?
En praktisk strategi är att använda Flare för utforskning och endast gå över till Sunburst när tillgången inte uppfyller ett precisionskrav.
Det betyder att Sunburst inte automatiskt bör bli det ”sista steget”. Om Flare redan uppfyller acceptanskriterierna kan ett byte av modell, bara för att Sunburst positioneras som premiumalternativet, lägga till latens utan att tillföra användbart värde.
GPT Image 2.5 vs Nano Banana Pro och andra AI-bildmodeller
GPT Image 2.5 vs Nano Banana Pro: Vilken är bäst?
Det finns ingen användbar universell vinnare.
Curious Refuge föredrog Nano Banana Pro för vissa fotorealistiska basbilder på grund av dess mer naturliga ansiktstextur, medan GPT Image 2.5 presterade bättre i sina komplexa tester för multireferens, produktbyte, stilmatchning och kontrollerad redigering.
MindStudio kom fram till en liknande uppgiftsberoende slutsats: GPT Image 2.5 presterade starkt på bokstavliga instruktioner och, i ett karaktärstest med fyra vinklar, bibehöll identiteten bättre än Nano Banana 2 och Nano Banana Pro.
Den bättre frågan är därför inte ”Vilken AI-bildmodell är bäst?” utan ”Vilken modell är starkast för denna specifika uppgift?”
GPT Image 2.5 vs Midjourney, Ideogram och Seedream
GPT Image 2.5 är särskilt övertygande när jobbet kräver redigering, referenser, strukturerade instruktioner eller iteration.
Midjourney kan fortfarande vara meningsfullt när omedelbar estetisk puts är prioritet. Typografifokuserade arbetsflöden kan motivera att testa Ideogram, medan Seedream och andra modeller förblir användbara alternativ för specifika visuella stilar eller produktionsbegränsningar.
Ett produktionsteam behöver inte en modell som vinner varje jämförelse. Det behöver en modellurvalsprocess som minimerar revisioner.
Hur bör du använda GPT Image 2.5 i verkliga produktionsarbetsflöden?
Ett bättre arbetsflöde för promptning med GPT Image 2.5
Istället för att förlita sig på promptutfyllnad som ”mästerverk”, ”8K” eller ”ultradetaljerad”, definiera den visuella uppgiften tydligt.
Ett användbart produktionsarbetsflöde är:
- Definiera tillgången: ämne, komposition, kamera, belysning, material, stil och slutlig användning.
- Tilldela referenser: specificera om varje bild kontrollerar identitet, produkt, kläder, stil eller komposition.
- Separera förändring från bevarande: ange exakt vad som ska ändras och vad som måste förbli oförändrat.
- Spara godkända kontrollpunkter: förgrena nya redigeringar från en ren accepterad version istället för att oändligt kedja revisioner.
Detta tillvägagångssätt gör fel lättare att diagnostisera och skyddar arbete som redan har granskats.
Bästa användningsområden för GPT Image 2.5
Modellen är särskilt relevant för produktfotografi, reklamvariationer, förpackningskoncept, affischer, merchandise, karaktärsutveckling, storyboards och instruktionsbilder.
För utbildningsinnehåll är skillnaden mellan illustration och faktabaserad visualisering viktig. En genererad processillustration kan stödja lärande, men exakta diagram, etiketter, statistik eller efterlevnadsinformation bör fortfarande verifieras av en människa.
Från GPT Image 2.5 till storyboards och AI-video
Ur ett AI-videoproduktionsperspektiv bör karaktärs- och produktkonsekvens inte lösas först efter att videogenereringen påbörjats.
Ett starkare arbetsflöde etablerar godkända stillbildsreferenser först: karaktärsutseende, garderob, produkter, platser, färgpalett och visuell stil. Dessa bilder kan sedan fungera som den visuella specifikationen för storyboardramar och efterföljande videoscener.
Det är också här Leadde:s implementering blir användbar. Leadde kör för närvarande GPT Image 2.5 Flare och positionerar genererade bilder som tillgångar som kan flyttas direkt in i videoscener eller bildspel i samma arbetsyta. Dess listade användningsfall inkluderar produktbilder, annonser, förpackningskoncept och storyboards.
För utbildnings-, marknadsförings- och undervisningsteam skapar detta ett mer kontinuerligt arbetsflöde:
källinnehåll → visuell riktning → bildtillgångar → storyboard → video → lokalisering
Värdet är inte bara att generera ytterligare en bild. Det handlar om att minska de manuella överlämningarna mellan visuell idégenerering och färdig kommunikation.
Slutsats
GPT Image 2.5 är mest övertygande när ditt arbetsflöde bygger på kontrollerad iteration snarare än en attraktiv första generering. Flare är den praktiska utgångspunkten för hastighet och volym, medan Sunburst är designad för precisionskänsligt arbete. Dess största styrkor är referenshantering, lokaliserad redigering och instruktionsföljsamhet; dess återstående svagheter inkluderar kumulativ kvalitetsförlust vid redigering, syntetiska texturer i vissa fotorealistiska arbeten och behovet av mänsklig QA för exakt typografi och layout. För produktionsteam kommer de bästa resultaten från att kombinera AI-generering med kontrollpunkter, tydliga bevaranderegler och deterministiska design- eller videoverktyg när exakthet är avgörande.
Vanliga frågor
Vad är skillnaden mellan GPT Image 2.5 Flare och Sunburst?
Flare är OpenAIs snabbare GPT Image 2.5 API-modell och det rekommenderade standardvalet för de flesta applikationer. Sunburst tar längre tid men är designad för arbetsflöden där redigeringsprecision och detaljerad kreativ kontroll är viktigare. Båda använder för närvarande samma publicerade tokenpriser.
Är GPT Image 2.5 bättre än Nano Banana Pro?
Det beror på uppgiften. Oberoende tester har gynnat GPT Image 2.5 för kontrollerad redigering, komplexa referenser och instruktionsföljsamhet, medan Nano Banana Pro har producerat mer naturlig hud och fotografisk textur i vissa jämförelser. Ingen av dem bör betraktas som den universella vinnaren.
Kan GPT Image 2.5 generera 4K-bilder?
Ja, via stödda API- och plattformsarbetsflöden. Oberoende API-tester har använt upplösningar som 3840×2160, medan tredjepartsplattformar också har exponerat 4K-generering. Upplösningstillgänglighet och kostnad kan variera beroende på gränssnitt och kvalitetsinställning.
Kan GPT Image 2.5 korrekt generera text i bilder?
Den presterar starkt på rubriker, etiketter, siffror och strukturerad affischtext. Puters kontrollerade affischtest producerade tre begärda textelement korrekt med både Flare och Sunburst. Dock bör liten text och slutgiltig professionell typografi fortfarande granskas manuellt.
Stöder GPT Image 2.5 transparenta bakgrunder?
Ja. GPT Image 2.5 stöder arbetsflöden med transparent bakgrund, vilket gör den användbar för produktutskärningar, lagerbaserade kreativa tillgångar och komposition. Funktionen är särskilt användbar när genererade motiv behöver flyttas in i design-, presentations- eller videoarbetsflöden.
Kan GPT Image 2.5 bibehålla samma karaktär över flera bilder?
Den är betydligt bättre lämpad för referensdrivet karaktärsarbete än tidigare generationer, men konsekvens garanteras inte. Karaktärsblad, tydligt tilldelade referensroller, upprepade identitetsbegränsningar och godkända visuella kontrollpunkter kan göra arbetsflöden med flera scener mer tillförlitliga.