Videodubbning med AI: Så fungerar det & bästa verktygen för 2026
Videodubbning med AI är en automatiserad process för att översätta en video och ersätta dess ursprungliga talade dialog med en synkroniserad syntetisk röst på ett målspråk, samtidigt som talarens röstidentitet, takt och känslomässiga leverans bevaras. För globala företag och digitala utbildare eliminerar detta de traditionella flaskhalsarna med att boka studios, casta röstskådespelare och utföra manuell tidslinjeredigering.
Ur ett pedagogiskt perspektiv lägger utbildnings- och produktteam ner oproportionerligt mycket tid på att omvandla befintlig dokumentation till videor, för att sedan stöta på nya hinder när innehållet ska lokaliseras för internationella marknader. Moderna AI-videoarbetsflöden överbryggar denna operationella klyfta: plattformar som Leadde låter team förvandla SOP-dokument till utbildningsvideor på några minuter och bildspel till basmaterial automatiskt, samtidigt som integrerad AI-dubbning hjälper till att skala upp videolokalisering för en global publik på minuter i stället för veckor.
I den här guiden får du titta närmare på den tekniska arkitekturen bakom modern röstsyntes, jämföra de ledande dubbningsplattformarna för företag och utbildning, och lära dig hur du implementerar ett automatiserat lokaliseringsarbetsflöde som upprätthåller pedagogisk tydlighet i stor skala.
AI-videodubbning: Vad är det och varför behöver innehållsteam det?
Ett verktyg för AI-videodubbning är en mjukvaruplattform som använder artificiell intelligens för att automatiskt transkribera, översätta och generera nytt röstberättande till befintliga videor. Avancerade plattformar använder röstkloning för att behålla talarens ursprungliga ton, tempo och röstegenskaper, vilket säkerställer att den lokaliserade versionen känns äkta för en inhemsk publik.
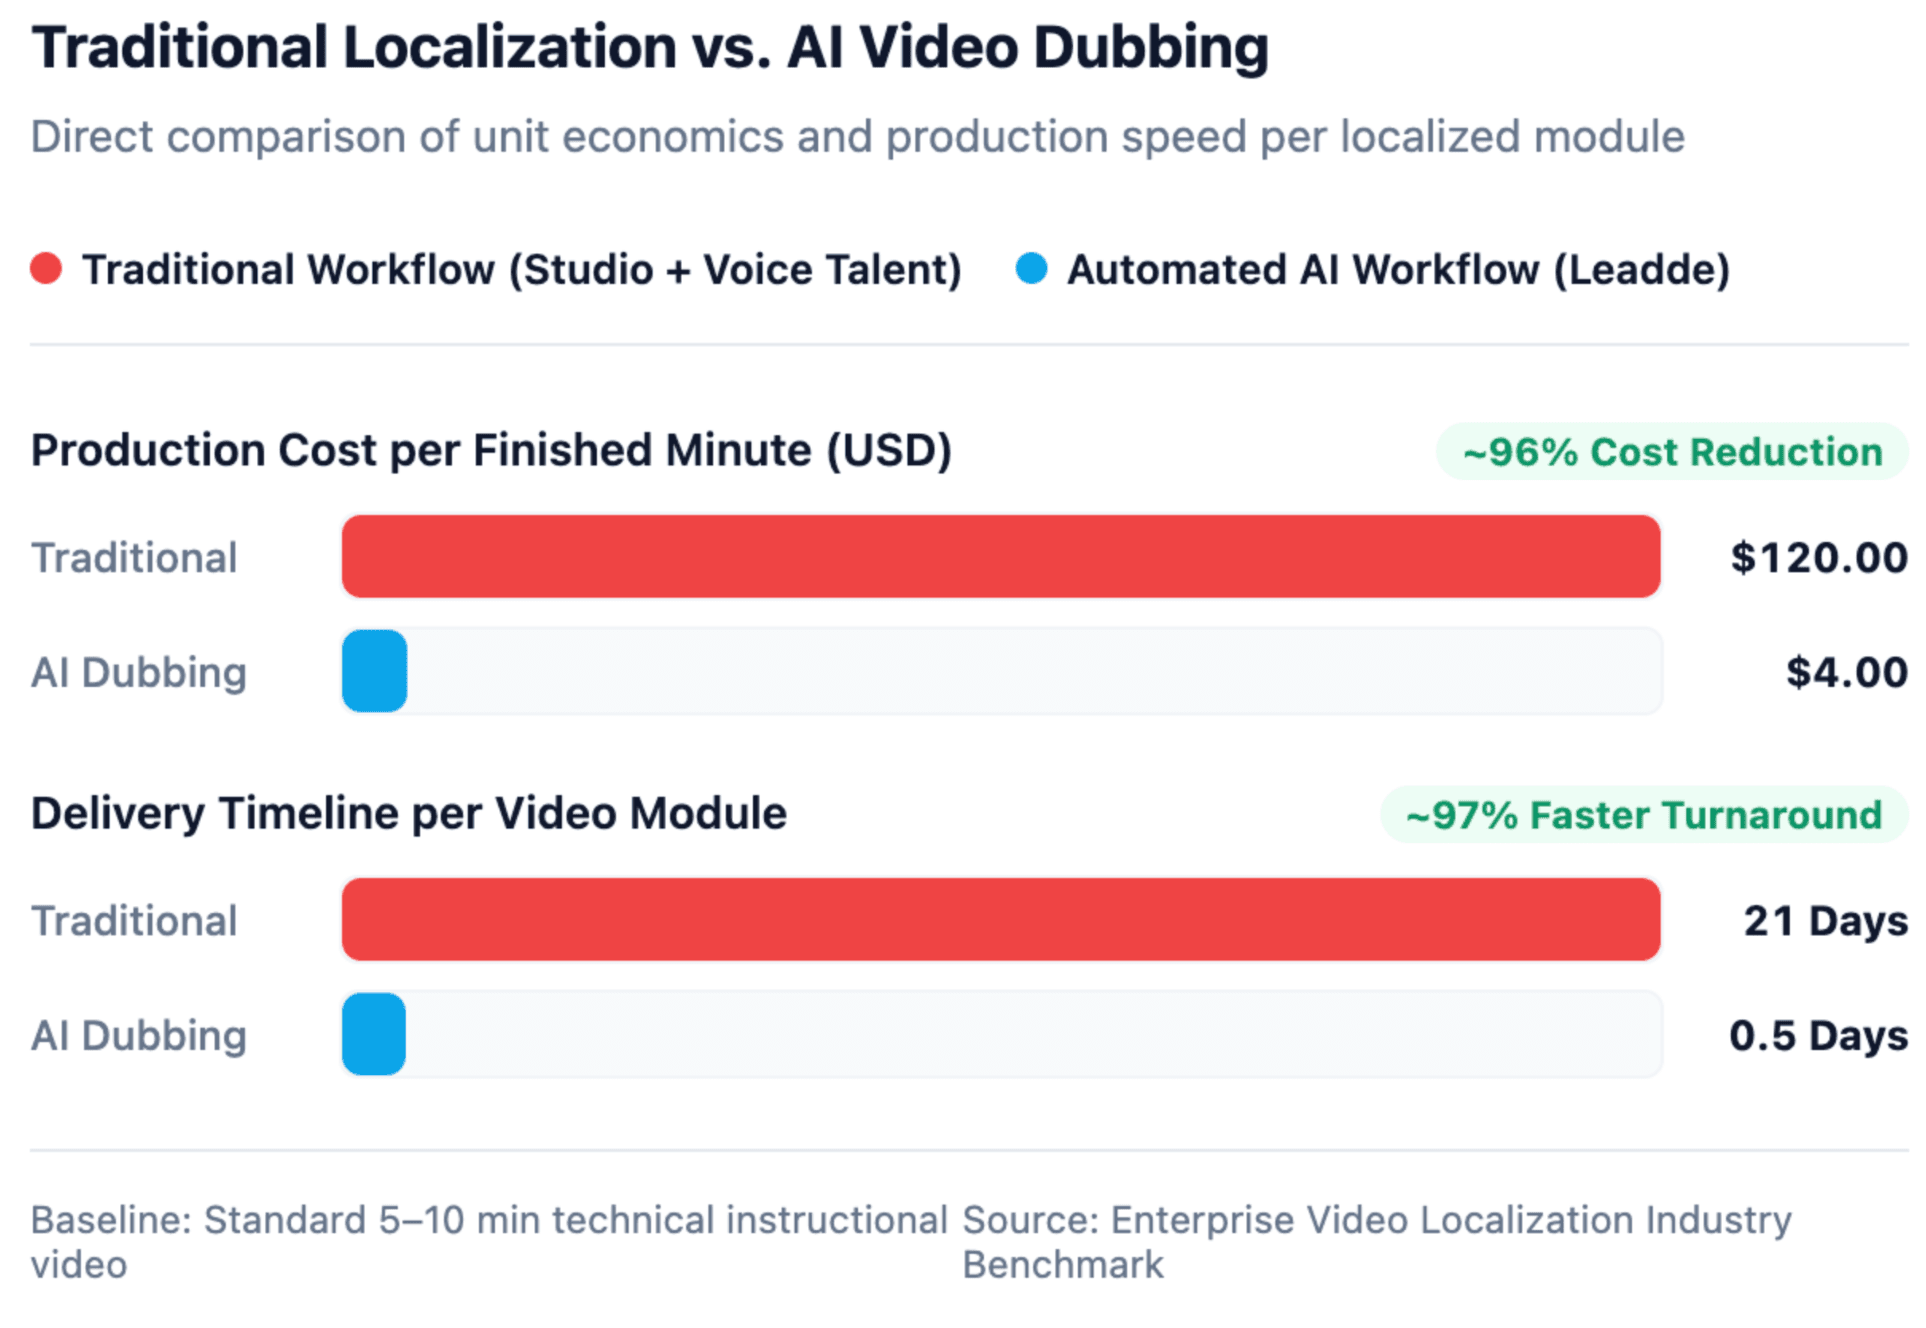
Ur ett instruktionsdesignperspektiv skapar den traditionella lokaliseringscykeln – transkribering, översättning, inspelning och omredigering – en betydande flaskhals för globala utbildningslanseringar. Innehållsteam möter en ökande press att leverera lokaliserad media snabbt utan att ge avkall på den pedagogiska korrektheten. Medan traditionella metoder säkerställer hög känslomässig kontroll är de ekonomiskt och operationellt ohållbara när moderna videobibliotek ska skalas upp. AI-videodubbning automatiserar dessa repetitiva produktionsfaser, vilket gör det möjligt för organisationer att anpassa videoinnehåll för globala marknader och bibehålla varumärkeskonsistens till en bråkdel av kostnaden.
Hur fungerar egentligen processen för AI-videolokalisering?
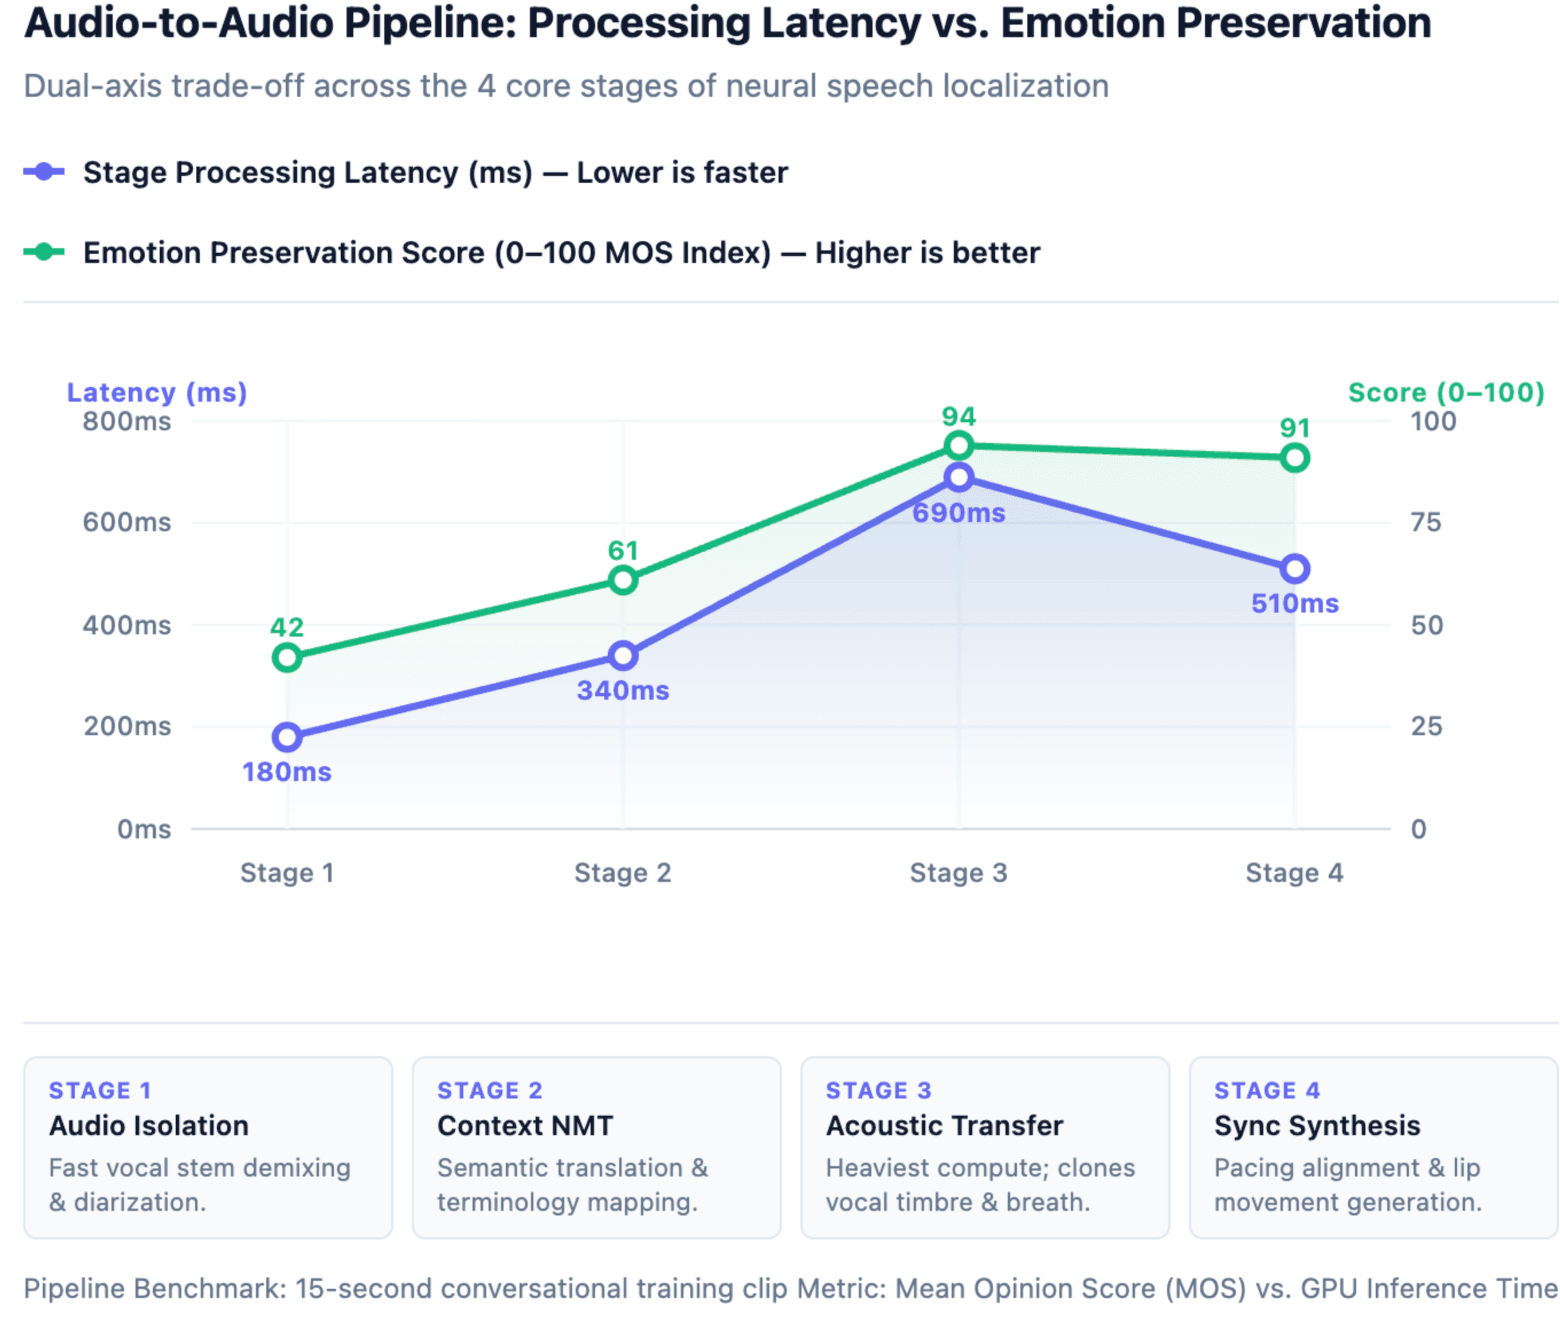
I professionella videoarbetsflöden krävs en synkroniserad teknisk pipeline för att sömlöst ersätta ljud utan att störa det visuella flödet. Tidiga text-till-tal-verktyg lät robotlika och skrev ofta över kritiskt bakgrundsljud. Dagens AI-modeller isolerar röstlagret, vilket säkerställer att bakgrundsmusik och omgivningsljud förblir intakta.
Röstigenkänning och diarisering
AI-motorn isolerar det primära tallagret från bakgrundsljud, transkriberar de talade orden med hög precision och identifierar flera olika talare (diarisering) i samma video. Denna initiala textextraktion utgör det grundläggande transkript som sedan lokaliseras.
Kontextmedveten lokalisering
I stället för en bokstavlig ord-för-ord-översättning anpassar avancerad AI fraser, idiom och teknisk terminologi så att resultatet låter naturligt för den lokala publiken. Professionella plattformar låter team granska och redigera denna text för att förhindra att pedagogiska fel sprider sig, vilket fungerar som en dedikerad videoöversättare för företagsarbetsflöden.
Ljud-till-ljud-röstkloning
I stället för att generera en röst enbart från ett texttranskript baserar moderna generativa modeller resultatet direkt på källagrets röstprestation. AI:n fångar upp andningsmönster, mikropauser och känslomässig kadens, och bygger vidare på moderna genombrott inom hur man skapar en AI-röst och mappar dessa röstnyanser till det översatta språket.
Timing och visuell synkronisering
Eftersom översatta meningar varierar i längd mellan olika språk – till exempel är tyska översättningar ofta längre än engelska – justerar AI:n dynamiskt tempot för det genererade ljudet för att matcha originalvideons visuella signaler, bildväxlingar och munrörelser.
Vilka är de bästa AI-dubbningsverktygen för kreatörer och företag?
Olika kommunikationsmål kräver olika lokaliseringsstrategier. En utbildare som omvandlar en statisk PDF till en global efterlevnadsvideo (compliance-video) har helt andra mjukvarukrav än en social media-chef som dubbar en kort reklam-vlogg.
| Alternativ | Bäst för | Fördelar | Begränsningar |
| Leadde | Utbildnings- och träningsvideor | Byggt specifikt för arbetsflöden från dokument till video; förvandlar PDF:er, SOP:er och bildspel till strukturerade, lokaliserade utbildningsvideor på 88 språk och 175 dialekter. | Stort fokus på skalbart företags- och instruktionsinnehåll snarare än fristående redigering för sociala medier. |
| ElevenLabs | Känslomässig ljudlokalisering | Branschledande naturlig röstkloning och ljud-till-ljud-överföring av känslor; stöder över 90 språk och dialekter. | Primärt en ljudfokuserad pipeline; kräver externa verktyg om visuell läppsynk behövs. |
| HeyGen | Visuell lokalisering av presentatörer | Högexakt visuell läppsynk och robust generering av anpassade AI-avatarer för "talking head"-videor. | Funktioner för premiumdubbning och läppsynk förbrukar separata krediter; kan uppvisa tidsförskjutning (drift) vid längre videor. |
| Canva (EasyDubbing) | Snabba marknadsföringsvideor | Integrerat direkt i Canva-redigeraren; snabb översättning med ett klick och röstkloning för innehåll i sociala medier. | Bäst lämpad för korta klipp; saknar djupa integrationer med LMS (Learning Management Systems) för företag. |
Hur kan du implementera ett skalbart arbetsflöde för dubbning från dokument till video?
Utbildningsteam lägger ofta ner mycket tid på att omvandla dokument och presentationer till videor innan lokaliseringen ens kan börja. Att förlita sig på manuell inspelning för varje språklig variant är ett föråldrat och oskalbart arbetssätt.
Att generera basvideon från dokument
I stället för att spela in en mänsklig presentatör från början kan du använda en AI-videogenerator som Leadde för att läsa in befintlig organisationskunskap, till exempel genom att lära dig hur man konverterar en PDF-manual till en utbildningsvideo eller SOP:er i Word. Plattformen strukturerar automatiskt upp dokumentet i logiska scener, genererar ett instruktionsmanus och tillämpar en initial AI-presentatör och röst.
Granskning av källtranskriptet
Innan dubbningsprocessen startar bör innehållsteamet göra en manuell genomgång av basmanuskriptet. Att korrigera en missförstådd teknisk term eller företagsspecifik akronym på källspråket förhindrar att felet mångdubblas på flera målspråk.
Applicering av klonad röst och storskalig lokalisering
Kör den godkända basvideon genom dubbningsmotorn och säkerställ att verktyget bevarar AI-instruktörens röst och känslomässiga ton. Granska de lokaliserade resultaten och exportera slutvideorna tillsammans med genererade flerspråkiga undertexter (SRT-filer) för fullständig tillgänglighet, vilket hjälper till att synkronisera global utbildning med AI-videoverktyg över distribuerade team.
Vilka är de vanliga utmaningarna med att skala upp flerspråkiga videor?
Även om AI-videogenerering blir allt vanligare utforskar många kreatörer och utbildare hur folk skapar realistiska AI-videor samtidigt som de kämpar med utmaningen att upprätthålla en naturlig leverans och visuell konsekvens. Att förstå dessa begränsningar är avgörande för att bygga upp skalbara arbetsflöden.
Att lösa läppsynksförskjutning i längre innehåll
Många verktyg för visuell AI-dubbning har svårt med långa, oavbrutna tagningar, vilket ofta leder till visuell förskjutning eller ett glapp mellan ljud och munrörelser efter några minuter. För att motverka detta bearbetar proffs långa videor i hanterbara delar eller använder strategiskt B-roll-material och presentationsbilder för att klippa bort från presentatörens ansikte.
Hantering av språkexpansion och kognitiv belastning
När tekniskt innehåll översätts från engelska till språk som tyska eller spanska uppstår en naturlig textexpansion. Om ett AI-verktyg pressar in en längre översättning i ett komprimerat tidsfönster blir talet onaturligt stressat, vilket avsevärt ökar den kognitiva belastningen för den som läser. Utbildningsdesigners måste redigera lokaliserade manus så att de blir mer koncisa i stället för att snabba upp ljudet artificiellt.
Hantering av diarisering för flera talare
Även om automatiserade verktyg är smidiga för snabb distribution misslyckas de ofta med att känna igen eller bevara distinkta röster när flera personer pratar. Vid paneldiskussioner eller intervjuer måste innehållsteam använda dedikerade AI-plattformar som har stöd för diarisering för att kunna klona flera unika röster samtidigt utan att röstprofilerna flyter samman.
Vanliga frågor (FAQ)
Bevarar AI-dubbning den ursprungliga talarens känslor?
Ja. Moderna AI-dubbningssystem använder ljud-till-ljud-modellering. I stället för att bara läsa upp ett översatt texttranskript analyserar AI:n den känslomässiga leveransen, tonhöjden och andningsmönstren i originalljudet och applicerar samma nyanser på målspråket.
Hur förvandlar man utbildningsdokument till dubbade videor?
Plattformar som Leadde är specialiserade på arbetsflöden från dokument till video. Användare kan ladda upp befintliga PDF-filer eller presentationer, lära sig hur man skapar flerspråkiga videoföreläsningar med AI, och konvertera texten till en strukturerad utbildningsvideo med en AI-röst, som sedan enkelt kan översättas och dubbas till flera språk.
Kan AI-dubbning bevara bakgrundsljud och musik?
Ja. Moderna AI-dubbningsverktyg isolerar det primära tallagret från bakgrundsljudet. De ersätter enbart de talade orden med den översatta röstinsatsen medan originalmusiken, ljudeffekterna och omgivningsljudet förblir intakta.
Varför räcker inte YouTubes autodubbning för företagsutbildning?
Även om YouTubes inbyggda översättning är effektiv för enklare spridning misslyckas den ofta med att bevara talarens känslomässiga tonfall, har svårt med diarisering för flera talare och klonar inte originalrösten, vilket sänker den professionella kvalitet som krävs för företagsutbildning.
Är AI-videolokalisering säkert för företagsskyddad data?
AI-videoplattformar av företagsklass erbjuder robusta verktyg för dataintegritet för att säkerställa att skyddat utbildningsmaterial och klonad röstdata inte används för att träna publika AI-modeller. Verifiera alltid en plattforms säkerhetsstandarder för företag innan du laddar upp interna dokument.
AI-videodubbning har förändrat hur organisationer ser på global kommunikation, och förvandlat en historiskt dyr och tidskrävande lokaliseringscykel till ett agilt, automatiserat arbetsflöde. Genom att kombinera intelligent generering av video från dokument med avancerad röstkloning och noggrann kvalitetskontroll kan innehållsteam framgångsrikt skala upp engagerande, flerspråkiga utbildningsbibliotek på internationella marknader.