MiniMax H3 提示指南:如何撰寫更優質的影片、Ref2VA、鏡頭、音訊和參考提示
一個強大的 MiniMax H3 提示詞所定義的不只是視覺風格。它還必須說明時間軸上的推移、運鏡方式、必須保持一致的細節、每個參考素材的作用,以及對話、音效與配樂如何融入整段畫面。想獲得更好的掌控力,關鍵在於:選擇正確的 H3 模式、具體描述肉眼可見的變化,並賦予每個參考素材明確的角色。
本指南涵蓋了 T2VA、I2VA、FL2VA、L2VA、Ref2VA、運鏡控制、音訊、角色一致性以及實用的疑難排解。這些原則同樣適用於結構化的 AI 影片工作流程,例如 Leadde,它能將文件、培訓教材與產品資訊轉化為可規模化的影片,並結合旁白、虛擬人與多語系輸出。
MiniMax H3 提示詞指南:最佳的提示詞結構是什麼?
思考 MiniMax H3 提示詞最有效的方式,就是把它當作一份「視聽製作腳本」。與其堆砌諸如「電影感」、「逼真」和「戲劇性」之類的詞彙,不如具體描述觀眾隨著短片進展實際能看到的畫面與聽到的聲音,藉此掌握如何製作逼真的 AI 影片。
簡單的 H3 提示詞公式
日常下提示詞時,請從這個結構開始:
主體 + 動作 + 環境 + 鏡頭 + 時間點 + 音訊
例如,「雨中火車站裡的女子」確立了場景,但沒有提供太多時間軸上的資訊。一個更強效的提示詞會說明:她朝月台走去、聽到進站列車的聲音時停下腳步、轉頭看向聲音來源,同時伴隨緩慢跟拍的運鏡。
MiniMax 官方的基礎提示詞指南將這個概念具象化為三個欄位:integrated_multimodal_description、overall_soundscape 與 non_diegetic_music。第一個欄位承載視覺時間軸、動作、鏡頭、說話者、對話與同步的場景音效;後兩者則將環境/實體音效與僅供觀眾聽見的背景音樂區隔開來。
寫出肉眼可見的結果,而不只是形容詞
一個實用的原則是:將抽象的意圖轉化為具體的視覺行為。
與其寫 「她看起來很有自信」,不如描述她步伐穩健、維持眼神接觸、整理夾克,以及毫不猶豫地停下腳步。
這種方法也適用於約束條件。與其重複寫 「請勿拉近鏡頭」,不如描述預期的結果:「主體從頭到尾在畫面中保持大約相同的大小。」 社群的一項H3 一致性測試指出,在該特定的工作流程中,具體可測量的構圖限制比反覆下達負面運鏡指令效果更好。這是社群的實務觀察,並非 MiniMax 官方保證。
你應該使用哪種 MiniMax H3 模式?
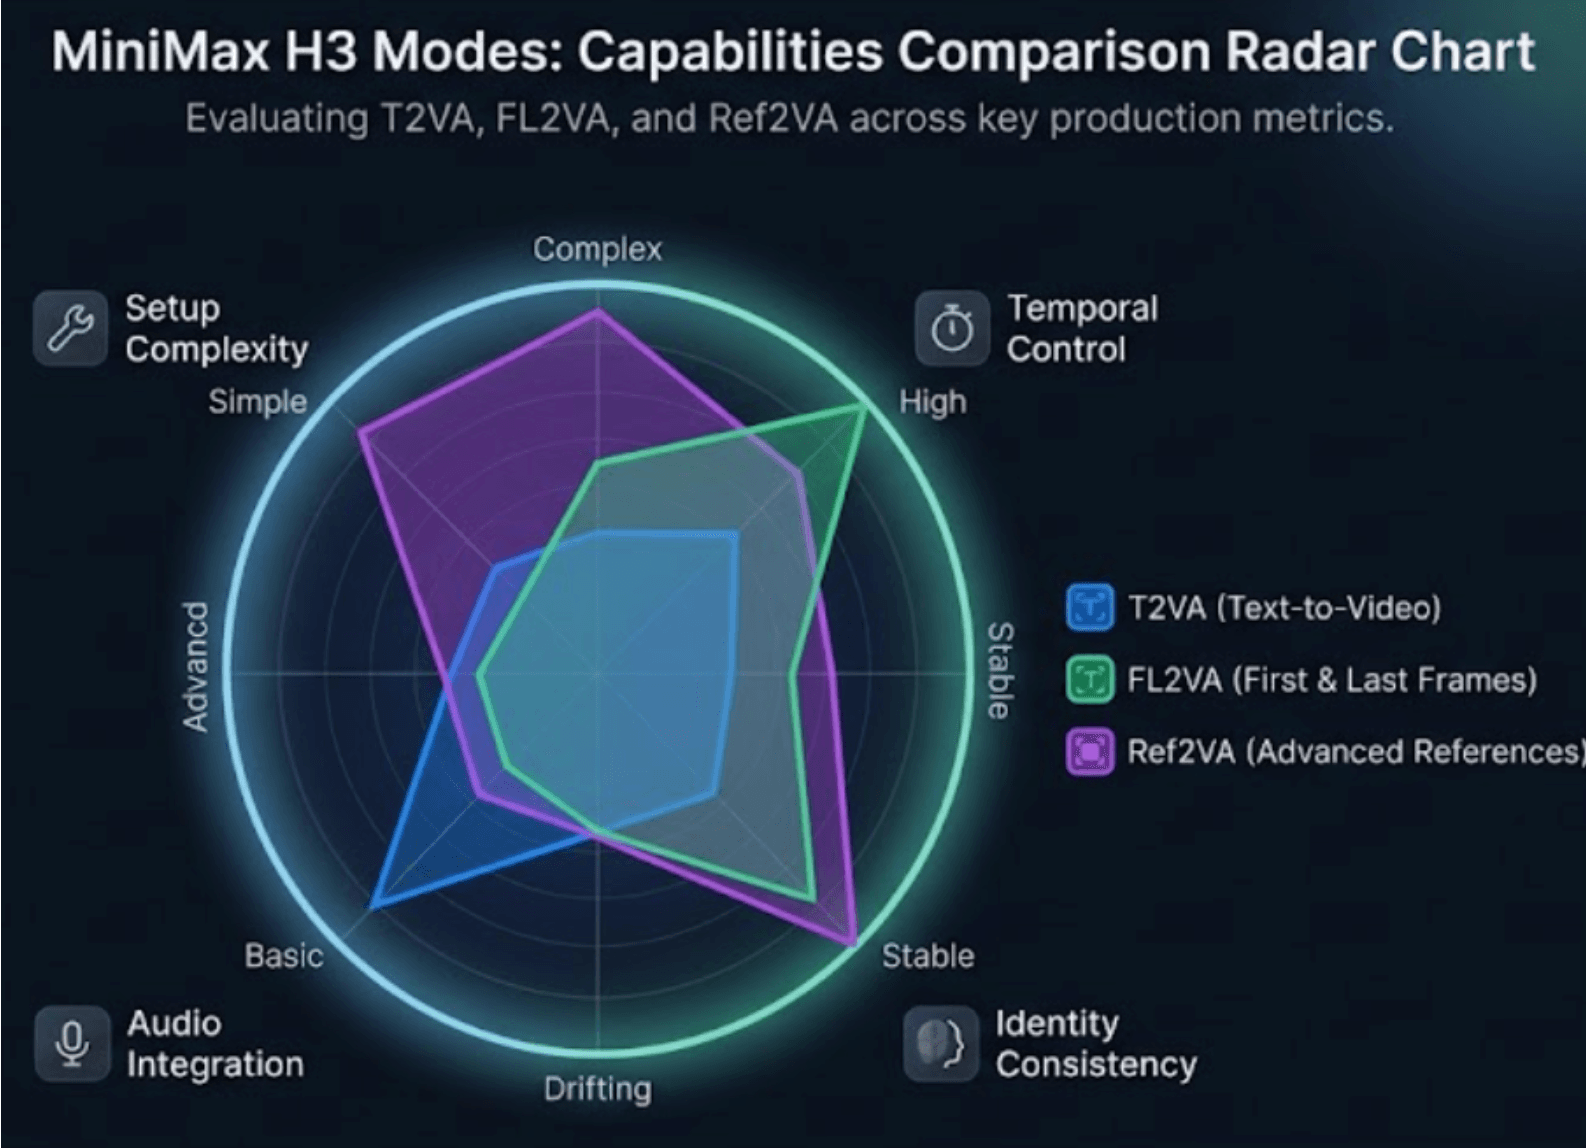
選擇正確的模式,重要性往往不亞於重寫提示詞。MiniMax 的 Base 工作流程支援純文字生成,以及首幀、尾幀和首尾幀任務,而其獨立的 Ref2VA 檢查點則專門處理多模態參考生成。
| 模式 | 輸入 | 最佳提示詞目標 |
| T2VA | 文字 | 建構完整的視聽場景 |
| I2VA | 首幀 | 保留開頭並向後延伸發展 |
| FL2VA | 首幀 + 尾幀 | 描述兩個端點之間的過渡 |
| L2VA | 尾幀 | 朝著提供的結尾向前建構 |
| Ref2VA | 圖片/影片/音訊 | 結合不同的參考素材角色 |
T2VA、I2VA、FL2VA 與 L2VA
T2VA 必須從零開始建立場景。I2VA 則將提供的圖片視為實際的首幀,因此提示詞在引入動態之前,應先保留身分特徵、服裝、物件、色彩與構圖。
在使用 FL2VA 時,提示詞不應只是單純描述圖片 1 與圖片 2。MiniMax 特別建議描述兩者之間肉眼可見的路徑:主體如何移動、姿勢如何改變、物件如何被操作,以及構圖或燈光如何收斂到最後一幀。L2VA 則透過從一個合理的早期狀態出發,並逐漸落在提供的尾幀上,來逆向思考整個過程。
什麼時候該使用 Ref2VA?
當不同的資產扮演不同的任務時,請使用 Ref2VA——例如,一張圖片定義角色、另一張定義服裝、一段影片提供步行動作與鏡頭節奏,而音訊則提供聲音參考。
這可以被理解為以關係為主導的生成。模型不僅需要知道每個檔案包含什麼內容,還需要知道來自每個來源的資訊應如何影響最終的影片。MiniMax 的全參考格式明確區分了可重複使用的主體、具體的圖片錨點、影片層級的時間來源,以及音訊參考。
使用能解決問題的最簡單模式
實務製作上有一個原則:除非鏡頭確實需要,否則不要增加參考素材的複雜度。
如果一個過渡轉場只需要精確的開頭與結尾,FL2VA 就能為該任務提供直接的定義。當你真正需要建立諸如 「來自圖片 1 的身分 + 來自影片 1 的動作 + 來自音訊 1 的聲音」 這種關聯時,再切換到 Ref2VA。
這也讓除錯變得更容易。當互相競爭的獨立約束條件變少時,就更容易判斷問題是出在動作、身分、構圖還是音訊上。
如何控制鏡頭、運鏡、時間點與過渡轉場?
當你把時間軸視為剪輯而非一段文字時,H3 提示詞就會變得更容易掌控。
鏡頭切換、時間戳記與時間預算
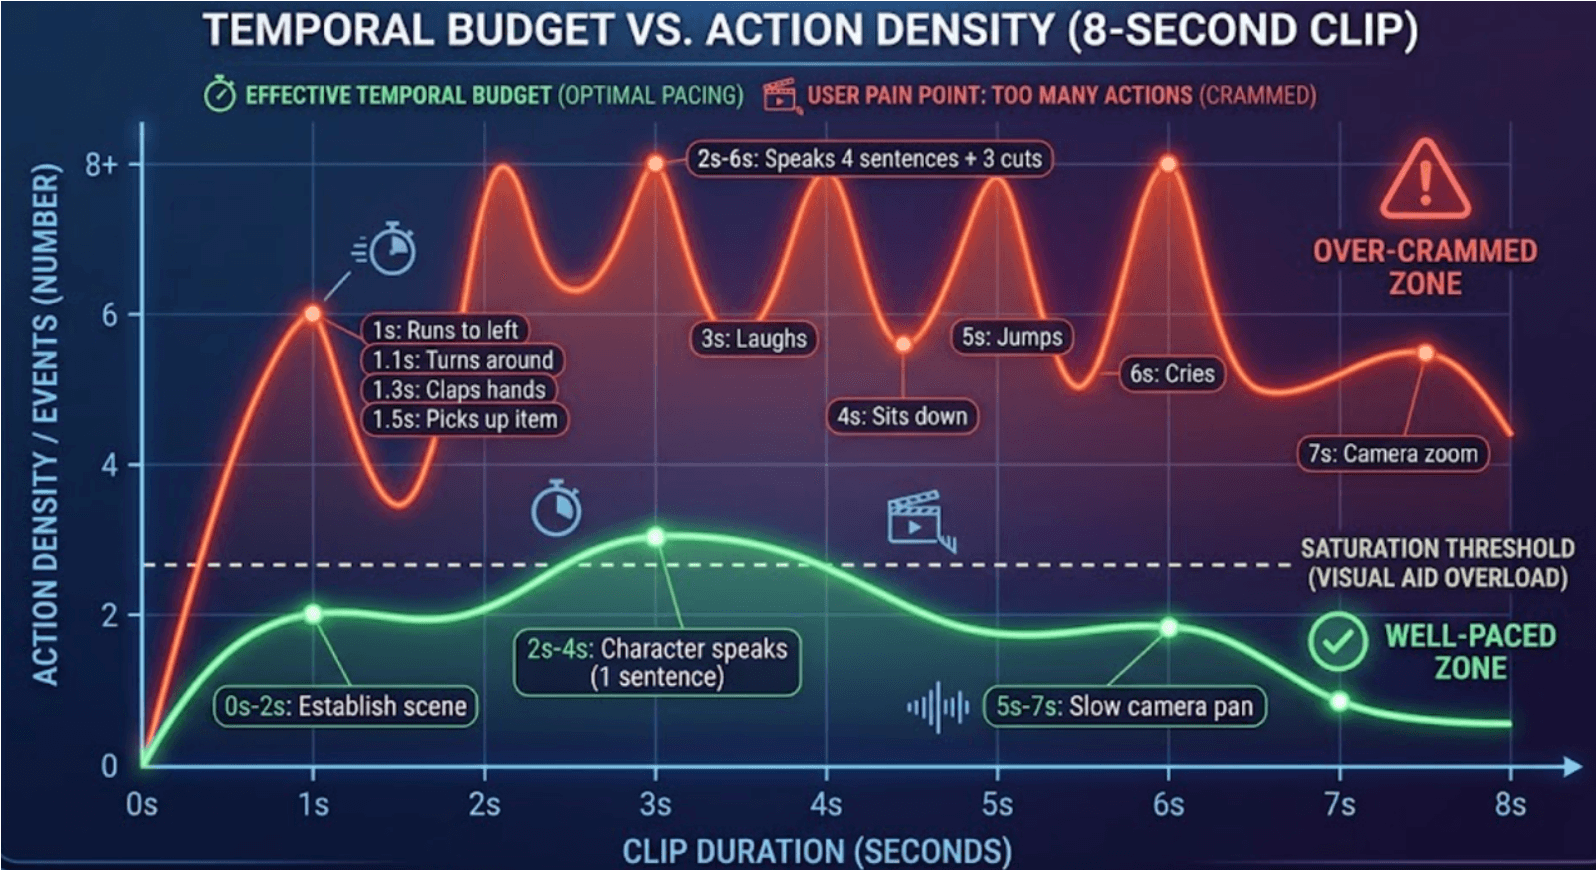
MiniMax 的官方格式不會在 [Shot 1] 加上時間戳記。後續的鏡頭則以遞增的剪輯時間開始,例如 [Shot 2] At 00:03.500。新的鏡頭應該引入有意義的新資訊——例如不同的視角、地點、狀態、主體或時間。微小的距離或角度變化,通常用運鏡來表達會比多切一個鏡頭更好。
這創造了一個實務上的時間預算。在一段 8 秒的短片中,三個動作、兩次運鏡、一次反應、一句對話和兩次鏡頭切換,全都在爭奪有限的秒數。當生成的畫面讓人感覺節奏倉促時,刪除部分事件通常比加入更多描述性語言更有效。
H3 可以遵循的運鏡語言
MiniMax 檔案支援的運鏡操作包括推/拉、平移、橫移、俯仰、升降、環繞、跟拍、固定鏡頭、主觀視角、滾轉與鏡頭晃動。其建議的邏輯基本上是:
運鏡類型 + 可選的幅度 + 可選的速度
因此,與其寫「動態電影感鏡頭」,不如寫出具體可行的指令,例如 「鏡頭緩慢向右橫移,同時保持主體在畫面中央。」
區分必須固定與可以改變的部分
在生成之前,先建立一個簡單的心智對照表:固定 vs. 變動。
產品影片可能會要求瓶子形狀、標籤文字、瓶蓋和顏色保持固定,同時讓鏡頭位置、反光、水流和燈光產生變化。角色序列則可能鎖定臉部、髮型與服裝,同時允許姿勢與表情演變。
這減少了相互矛盾的指令,因為提示詞不再要求所有視覺屬性同時改變。
如何在不失去角色或產品一致性的情況下使用參考素材?
最強大的參考工作流程會為每個資產指定特定的用途。
賦予每個參考素材一個明確的工作
一個實用的對應關係可能是:
圖片 1 → 角色身分 圖片 2 → 服裝 圖片 3 → 產品設計 影片 1 → 行走動作與運鏡路徑 音訊 1 → 聲音音色
MiniMax 官方的 Ref2VA 格式支援正是這種跨來源的定義:一個主體可以從圖片獲取外觀、從影片獲取動作,而單一參考檔案也可以提供多個可重複使用的主體。
重點在於避免意外的轉移。如果影片 1 應該提供動作,但不應提供其演員或環境,請在關係設計中明確指出。
主體、圖片、分鏡腳本與參考影片
在官方術語中,<Subject N> 代表可重複使用的視覺內容,而 <Picture N> 則在圖片本身作用具體影格、構圖錨點或影片腳本與分鏡參考時使用。<Video N> 代表全影片層級的關聯,例如剪輯、延續、運鏡、切換、節奏或時間結構。<Audio N> 則處理音訊複製或諸如音色、語氣、節奏或音樂風格等特徵。
這種區別避免了一個常見的概念錯誤:角色參考自動等於關鍵影格,而分鏡腳本也不自動等於精確的端點。
參考經濟學與鏡頭層級的一致性
更多的參考素材並不等於自動提供更多資訊。在製作工作流程中,請將參考影片裁剪至明確展示你需要動作、運鏡或人聲品質的那一部分。
同時,要在整個鏡頭的過程中評估身分的一致性,而不僅僅是在第一幀。某個社群測試發現在該使用者的特定本機設定下,特寫鏡頭中的身分漂移比小臉構圖發生得更早。精確的時間點不應一概而論,但這個工作流程的教訓很有價值:在每個重要鏡頭的多個時間點檢查臉部身分、服裝與小道具。
進階 Ref2VA、對話與音訊提示詞如何運作?
Ref2VA 是 H3 提示詞變得更像是多模態製作規劃,而不是傳統文生影片提示詞的領域。
六部分 Ref2VA 提示詞結構
MiniMax 的全參考指南定義了六個部分:
subject_definitions → summary → retention_analysis → detailed_description → overall_soundscape → non_diegetic_music。
系統首先定義參考素材代表的意義,接著總結任務,說明如何保留或轉移每個參考素材,最後按播放順序寫出目標影片。
在寫正式提示詞之前,一個實用的規劃層級是:
| 來源 | 保留 | 轉移 | 忽略 |
| 圖片 1 | 臉部、頭髮 | — | 背景 |
| 影片 1 | — | 走路、運鏡 | 演員身分 |
| 音訊 1 | 聲音音色 | 語氣 | 原始對話 |
這將一個模糊的要求(例如「使用所有這些參考素材」)轉化為明確的來源到目標的關聯。
對話、人聲、音效與配樂
說話的角色使用穩定的 ID,例如 (S1) 與 (S2),而對話則放在 <d>[Language] ...</d> 之中。MiniMax 同時區分了畫面上對話與畫面外旁白,並建議當畫面上的角色僅在擔任旁白時,應明確保持其嘴型閉合。
環境音效與物理效果屬於音效場景,而 non_diegetic_music 則保留給觀眾而非角色聽見的音樂。如果你想要腳步聲、雨聲和物件聲音,但不需要配樂,請保留音效場景並將 non_diegetic_music: N/A 設為不適用。
自然語言提示詞 vs 官方結構化提示詞
簡短的自然語言指令在託管版 H3 系統中仍然有效,因為 MiniMax 使用了 H3-Context-IR,這是一個預處理層,負責在為 H3-Base 產生結構化表示之前,解釋文字、圖片、影片和音訊之間的關聯。公開的模型卡將指令解析、跨模態關聯、時間理解和邏輯推理描述為該過程的一部分。
這解釋了一個表面上的矛盾:簡單的提示詞適用於直覺的託管生成,而結構化提示詞對於精確的多參考、對話、時間點和可重複的製作任務則更有價值。
為什麼 MiniMax H3 會忽略提示詞?最佳的測試工作流程是什麼?
當生成失敗時,一次改寫所有東西會讓問題的原因更難以被識別。
常見的 H3 提示詞問題與修復方法
| 問題 | 可能原因 | 要測試的第一件事 |
| 說話者錯誤 | 說話者對應不清 | 鎖定 (S1)/(S2) |
| 角色改變 | 衝突的身分訊號 | 簡化參考素材 |
| 參考被忽略 | 角色定位模糊 | 指定單一工作 |
| 隨機切換鏡頭 | 太多鏡頭指令 | 改用相機運鏡 |
| 時間戳記被忽略 | 被當作動作計時 | 保留給鏡頭切換使用 |
| FL2VA 跳動 | 缺少過渡路徑 | 描述中間的變化 |
| 結尾不對 | 收斂效果弱 | 鎖定最終構圖 |
| 不想要的音樂 | 音訊層混雜 | 明確設定音樂 |
| 文字改變 | 字句未被保留 | 引述確切可見的文字 |
| 影片感覺倉促 | 事件太多 | 減少節拍 |
一個實用的原則是:當兩種模式都能解決同一個任務時,進行對照測試,而不是假設複雜的模式一定能產生更好的短片。
實用的逐步 H3 測試工作流程
首先為生成設定驗收標準:也許角色身分最重要,或者產品標籤、端點過渡、對話歸屬或運鏡是不可妥協的。
然後分層測試:先建立角色和場景;接著加入動作和鏡頭;在視覺行為穩定後,加入人聲和音效;只有在較簡單的版本運作正常後,才引入額外的鏡頭切換、分鏡或額外的角色。高解析度重新生成應該在語義結果正確之後進行,因為高解析度無法解決互相衝突的參考關係。
這種分階段的方法在可規模化的影片管線中特別有用。對於將重複性知識或業務內容轉化為影片的工作流程,包括諸如 Leadde 等文件轉影片的培訓工具,將內容結構、視覺行為、AI 旁白和最終渲染拆分開來,能讓修繕更容易被獨立處理,而不必每次都重建整個製作過程。
儲存成功的鏡頭,而不是重新生成所有東西
對於較長的作品,請將每個成功的片段視為經過驗證的製作資產。如果鏡頭 1 和鏡頭 2 運作正常,但鏡頭 3 失敗了,請重新生成失敗的部分,而不是丟棄上游的所有成果。
社群 H3 工作流程出於這個原因已經在使用檢查點鏡頭:一旦成功的片段被保存下來,就可以重新執行下游的實驗,而不必一再付出重新創作早期素材的運算與創意成本。
這帶出了一個更廣泛的製作原則:
生成 → 驗證 → 儲存 → 繼續。
對於 AI 影片而言,提示詞工程最終將演變為工作流程工程。
結論
當任務被清晰結構化,而不是僅僅用更多的詞彙來描述時,MiniMax H3 的提示詞效果最好。選擇符合鏡頭的最簡單模式、具體描述肉眼可見的變化、將固定屬性與變數區隔開來、賦予每個參考素材明確的角色,並逐層進行除錯。對於進階的 Ref2VA 工作流程,真正的優勢在於:明確定義角色、動作、運鏡、音訊和關鍵影格之間的關聯——然後將成功的生成結果轉化為下一個鏡頭可重複使用的積木。