AI 影片語音配音:2026 年運作原理與最佳工具推薦
AI 影片配音是翻譯影片的自動化流程,能將原始口語對話替換為目標語言中同步的合成旁白,同時保留說話者的聲音特質、語調與情感表現。對跨國企業與數位教育工作者而言,這項技術省去了傳統預訂錄音室、甄選配音員以及手動剪輯時間軸的繁瑣瓶頸。
從教學設計的角度來看,培訓與產品團隊往往花費不成比例的心力將現有文件轉換成影片資產,卻在跨國市場進行在地化時遇到另一道障礙。現代的 AI 影片工作流程彌補了這項營運落差:像 Leadde 這樣的平台能讓團隊在幾分鐘內將 SOP 文件轉為培訓影片,並自動將簡報轉化為基礎資產,而整合式 AI 配音更能協助企業在幾分鐘(而非幾週)內實現全球受眾的影片在地化。
在本指南中,你將深入探討現代語音合成背後的技術架構、比較適用於企業與教育內容的主流配音平台,並學習如何導入自動化的在地化工作流程,以維持大規模的教學清晰度。
AI 影片配音:這是什麼?內容團隊為什麼需要它?
AI 影片配音工具是一個軟體平台,利用人工智慧自動為現有影片資產進行逐字稿轉錄、翻譯與生成新的旁白音訊。先進的平台會運用聲音複製(Voice Cloning)技術來保留說話者的原始語調、節奏與聲音特徵,確保在地化版本對當地受眾而言聽起來真實自然。
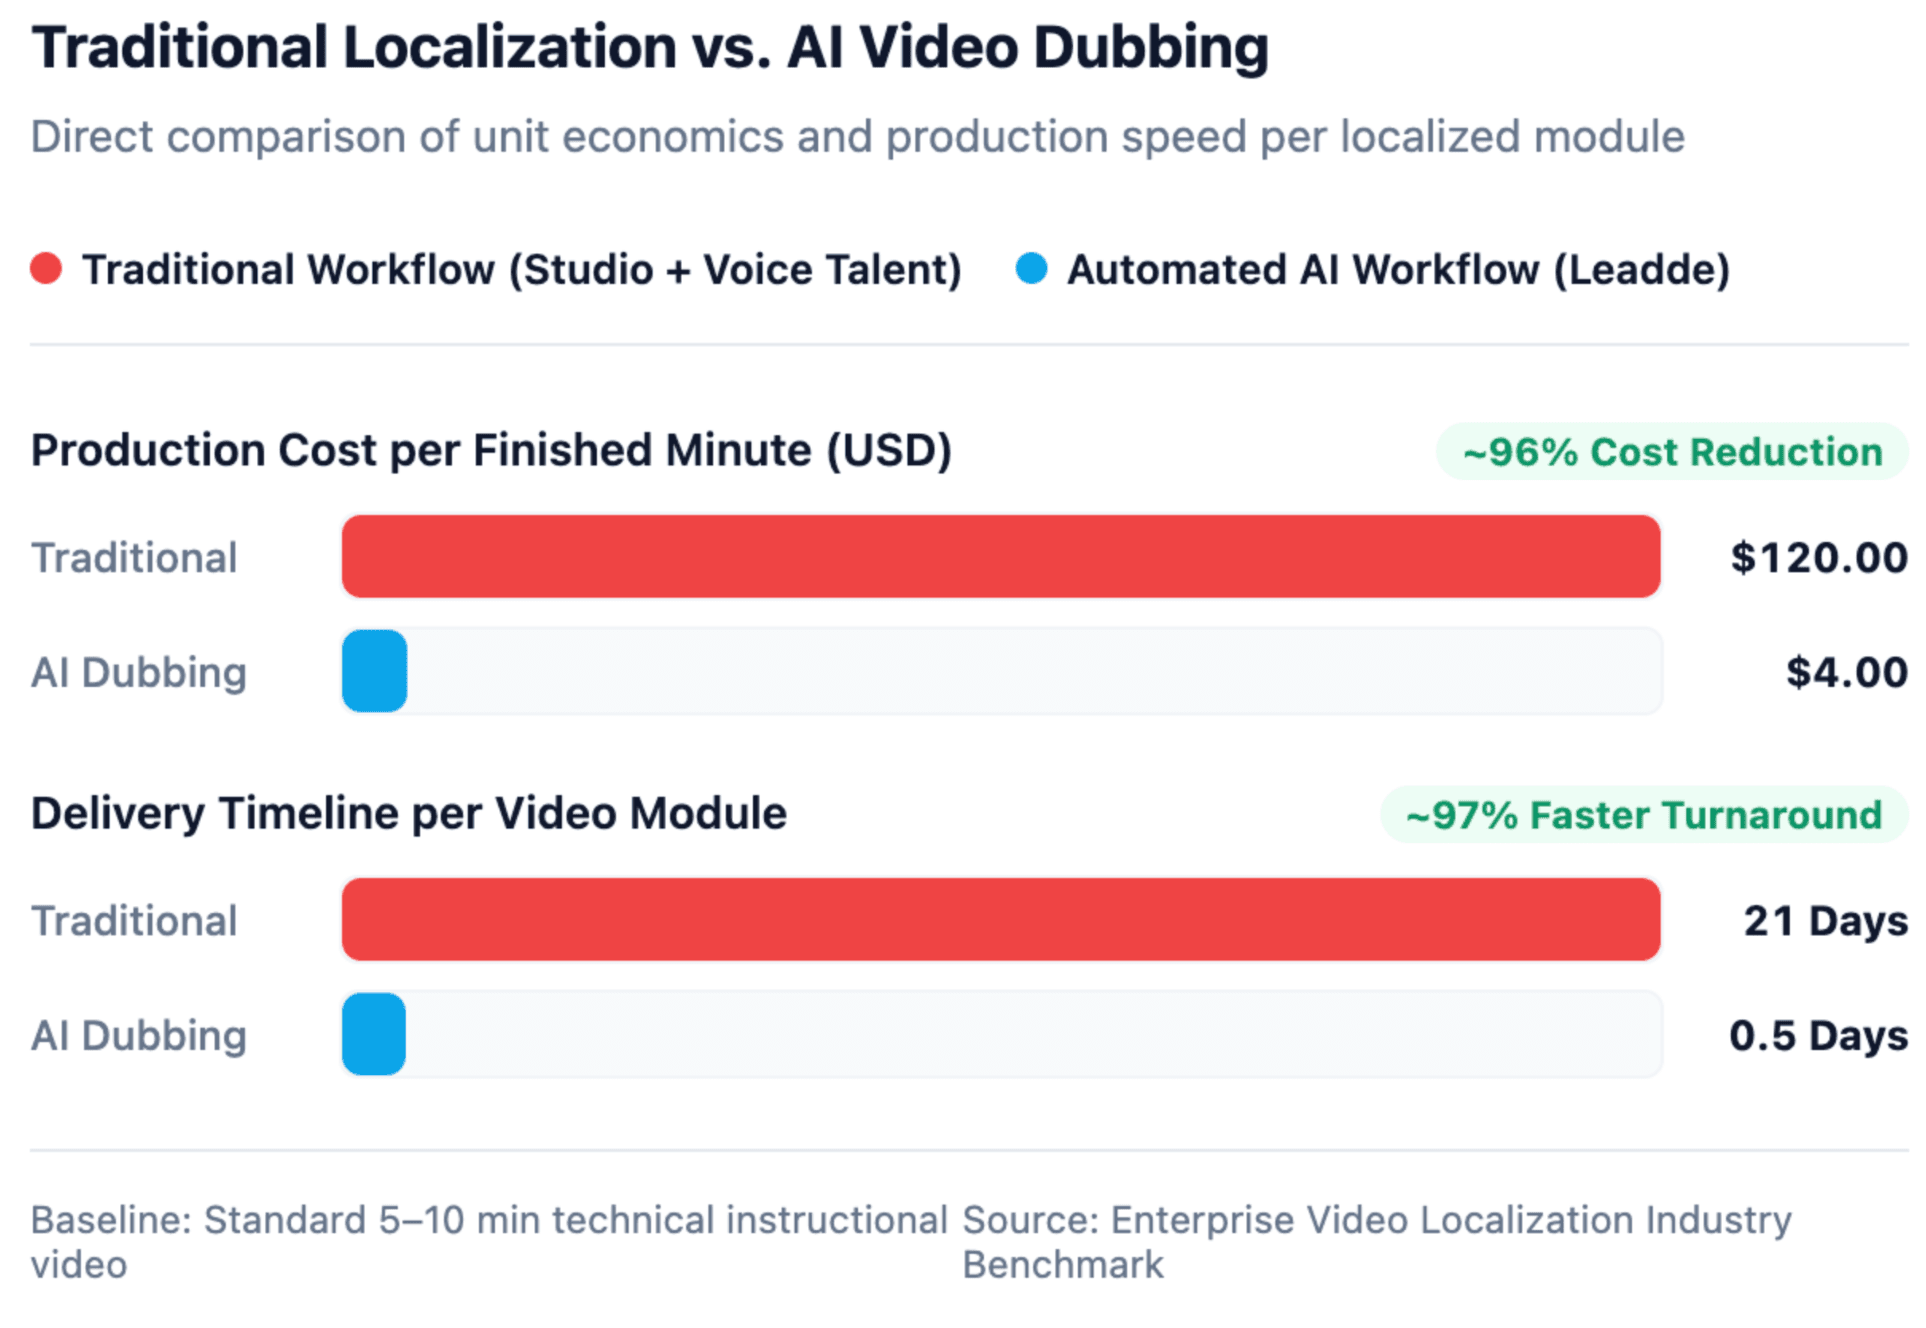
從教學設計的角度切入,傳統的在地化週期——轉錄、翻譯、錄音與重新剪輯——為全球培訓項目的推廣造成了重大瓶頸。內容團隊面臨著越來越大的壓力,必須在不犧牲教學準確性的前提下快速交付在地化媒體。雖然傳統方法能確保高度的情感掌控力,但在擴展現代影片庫時,其財務與營運成本卻是無法永續的。AI 影片配音能將這些重複的製作階段自動化,讓組織能夠針對全球市場調整影片內容,並以極低的成本維持品牌一致性。
AI 影片在地化流程的實際運作方式為何?
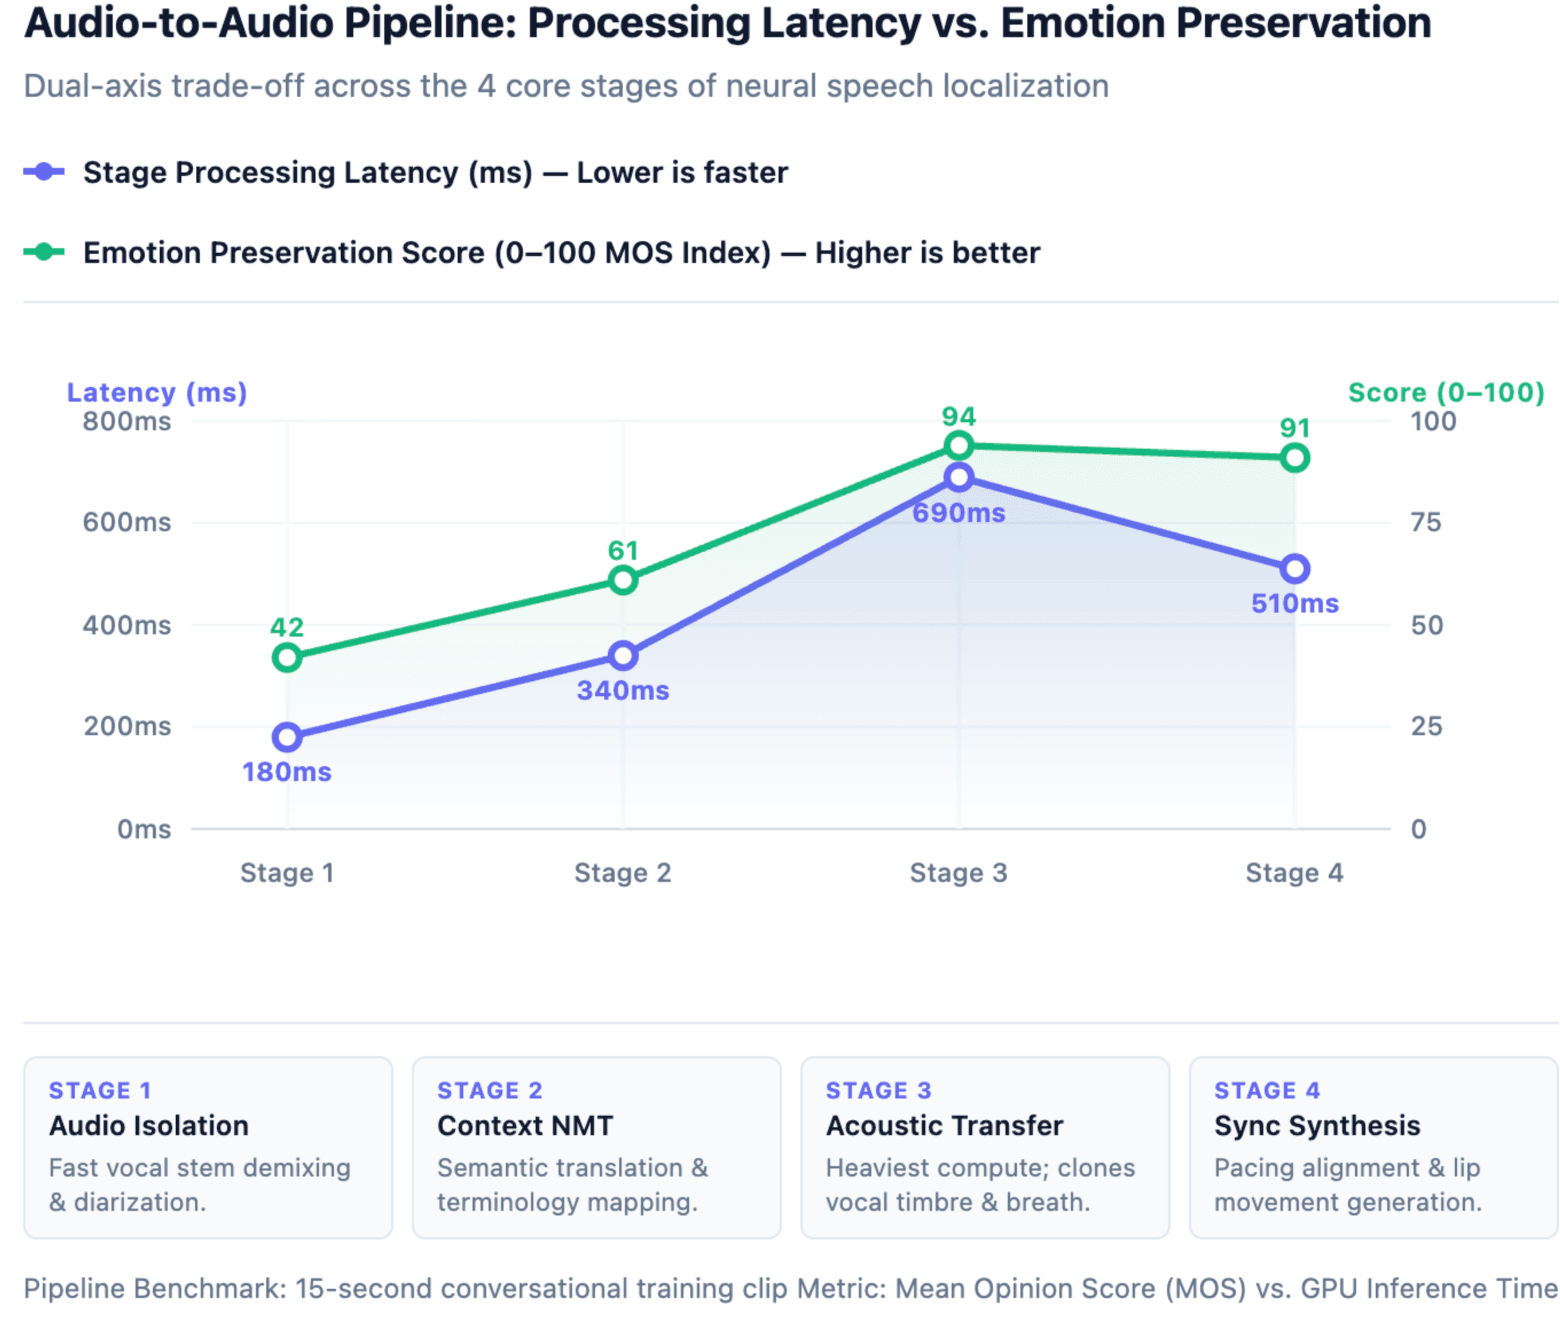
在專業的影片工作流程中,要在不打亂視覺流暢度的情況下無縫替換音訊,需要一個同步的技術管線。早期的文字轉語音(TTS)工具聽起來很機械化,且經常覆蓋掉關鍵的背景音訊。如今的 AI 模型能夠將人聲層獨立出來,確保背景音樂與環境音保持完整。
語音辨識與聲紋識別(Diarization)
AI 引擎會將主要語音層從背景噪音中分離出來,準確轉錄說出的字句,並識別同一部影片中的多個不同說話者(聲紋識別)。這種最初的文字萃取構成了將要進行在地化的基礎逐字稿。
具備上下文意識的在地化
先進的 AI 不會進行字面上的逐字翻譯,而是會調整用詞、慣用語與技術專有名詞,讓輸出結果對當地受眾而言聽起來自然流暢。專業平台允許團隊審查和編輯這些文字,以防止教學錯誤不斷擴大,其運作方式就像是企業工作流程專屬的影片翻譯工具。
語音對語音(Audio-to-Audio)聲音複製
現代生成式模型不是單純從文字逐字稿生成聲音,而是直接以來源音訊的表現作為條件來調整輸出。AI 會捕捉呼吸模式、微暫停與情感節奏,並在此基礎上結合如何製作 AI 聲音的現代突破,將這些聲音細微差別對應到翻譯後的語言中。
時間與視覺對齊
由於翻譯後的句子在不同語言中的長度各不相同(例如德文翻譯通常比英文長),AI 會動態調整生成音訊的節奏,以配合原始影片的視覺線索、投影片轉場與口型動作。
哪些是適合創作者與企業的最佳 AI 配音工具?
不同的溝通目標需要不同的在地化策略。把靜態 PDF 轉為全球合規影片的教育工作者,其軟體需求與為短篇宣傳短片配音的社群媒體經理截然不同。
| 選項 | 最適合 | 優勢 | 限制 |
| Leadde | 教育與培訓影片 | 專為文件轉影片工作流程打造;可將 PDF、SOP 與簡報轉換為跨越 88 種語言與 175 種方言的結構化在地化培訓影片。 | 主要專注於可規模化的企業與教學內容,而非獨立的社群媒體剪輯。 |
| ElevenLabs | 具情感的音訊在地化 | 業界領先的自然聲音複製與語音對語音情感轉移;支援超過 90 種語言與口音。 | 主要為音訊導向的管線;若需要視覺對嘴,則需搭配外部工具。 |
| HeyGen | 簡報者視覺在地化 | 針對真人說話影片提供高準確度的視覺對嘴與強大的自訂 AI 虛擬人生成功能。 | 高級配音與對嘴功能會消耗獨立的點數額度;在較長的影片中可能會發生聲畫不同步的情況。 |
| Canva (EasyDubbing) | 快速行銷影片 | 直接整合至 Canva 編輯器中;針對社群媒體內容提供快速的一鍵翻譯與聲音複製功能。 | 最適合短片;缺乏深度的企業學習管理系統(LMS)整合。 |
如何實作可規模化的「文件轉影片」配音工作流程?
培訓團隊往往需要花費大量時間將文件與簡報轉換成影片,之後才能開始進行在地化。依賴手動錄製每一種語言版本是一種過時且無法規模化的方法。
從文件生成基礎影片
與其從頭錄製真人簡報者,不如使用像 Leadde 這樣的 AI 影片生成器來吸收現有的組織知識,例如學習如何將 PDF 手冊轉換為培訓影片或 Word SOP。該平台會自動將文件結構化為合乎邏輯的場景,生成教學講稿,並套用初期的 AI 簡報者與旁白。
審查來源逐字稿
在啟動配音流程之前,內容團隊應手動審查基礎逐字稿。在來源語言中修正聽錯的技術術語或專有縮寫,可以防止該錯誤在多個目標語言中被乘以放大。
套用複製聲音並進行大規模在地化
透過配音引擎處理核准的基礎影片,確保工具能保留 AI 講師的聲音與情感語調。審查在地化後的輸出結果,並將最終影片與產生的多語言字幕(SRT 檔案)一起匯出以完全符合無障礙合規要求,幫助分佈式團隊利用 AI 影片工具同步全球培訓。
大規模製作多語影片時會面臨哪些常見挑戰?
雖然 AI 影片生成的採用率日漸普及,但許多創作者與教育工作者在探討人們是如何製作逼真的 AI 影片時,同時也正努力應對如何維持自然表達與視覺一致性的挑戰。理解這些限制對於建立可規模化的工作流程至關重要。
解決長篇內容中的對嘴不同步問題
許多 AI 視覺配音工具在處理長時間的連續鏡頭時往往力有未逮,在幾分鐘過後常會導致視覺不同步或音訊與口型脫節。為減緩這個問題,專業人士會將長影片拆解為易於管理的片段處理,或策略性地使用 B-roll(輔助畫面)與簡報投影片來切換掉簡報者的臉部畫面。
管理語言膨脹與認知負荷
當把英文的技術內容翻譯成德文或西班牙文等語言時,文字膨脹(Text Expansion)是必然會發生的現象。如果 AI 工具將較長的翻譯硬塞進壓縮的時間窗口中,語速就會變得不自然地急促,大幅增加學習者的認知負荷。教學設計人員必須將在地化講稿編修得更精簡,而不是人工加速音訊。
處理多說話者聲紋識別
雖然自動化工具便於快速發布,但當有多人發言時,它們往往無法識別或保留不同的聲音。針對座談討論或訪談影片,內容團隊必須使用具備聲紋識別能力的專屬 AI 平台,才能同時複製多個獨特的說話者,而不會將聲音特徵混淆合併。
常見問答 (FAQ)
AI 配音能維持原說話者的情感嗎?
可以。現代的 AI 配音系統採用語音對語音建模。AI 不只是朗讀翻譯後的文字逐字稿,還會分析原始音訊的情感表現、音高與呼吸模式,並將這些相同的語調變化套用到目標語言中。
如何將培訓文件轉為配音影片?
像 Leadde 這樣的平台專精於文件轉影片的工作流程。使用者可以上傳現有的 PDF 或簡報,學習如何透過 AI 一步步建立多語言視訊講座,並將文字轉換為配有 AI 旁白的結構化教育影片,接著便能輕鬆翻譯並配音成多種語言。
AI 配音能保留背景噪音與音樂嗎?
可以。現代的 AI 配音工具會將主要語音層從背景音訊中分離出來。它們只會將說出的字句替換為翻譯後的旁白,同時完整保留原本的音樂、音效與環境噪音。
為什麼 YouTube 的自動配音不足以應付企業培訓需求?
雖然 YouTube 內建的翻譯功能對於隨意觀賞的發布很有效率,但它通常無法保留說話者的情感語調、難以處理多說話者聲紋識別,且無法複製原始聲音,因而無法達到企業培訓所需的專業品質。
對於專有的商業資料而言,AI 影片在地化安全嗎?
企業級 AI 影片平台提供強固的資料隱私控制,確保專有培訓資料與複製的聲音資料不會被用於訓練公共 AI 模型。在上傳內部文件之前,務必先驗證平台的企業資安合規性。
AI 影片配音已經徹底改變了組織處理全球溝通的方式,將以往昂貴且耗時的在地化週期轉化為敏捷、自動化的工作流程。透過將智慧化的「文件轉影片」生成技術與先進的聲音複製及嚴謹的品質把關相結合,內容團隊就能成功地在國際市場上規模化推廣引人入勝的多語言培訓庫。