MiniMax H3の使い方:プロンプト、参照、オーディオ、ComfyUI完全ガイド
MiniMax H3を最も効果的に使いこなす秘訣は、**「最初に最適な生成モードを選び、その上でテキスト、フレーム、参照画像、モーション、音声で何を制御するのかを決めること」**です。テキストからの生成、最初または最後のフレームの固定、あるいは画像・動画・音声を用いた人物の一貫性、動き、カメラワーク、音声のガイドなどが可能です。
H3は、マルチモーダルな参照データとネイティブな音声・映像生成を組み合わせているため、長すぎるプロンプトよりも、明確なコントロールを行うことで優れた結果が得られます。本ガイドでは、適切なワークフローの選び方、効果的なプロンプトの書き方、参照データの活用法、セリフやサウンドの管理、効率的なテスト手法、そしてComfyUIやAPIの活用法について解説します。
もし、クリエイティブなプロンプトの作成から始めるのではなく、PDF、プレゼン資料、SOP、あるいはトレーニング資料をお持ちであれば、H3で各シーンを手動でディレクションする前段階として、またはその代わりに、Leaddeを使って構造化されたソースコンテンツを動画ワークフローに変換する方が適している場合もあります。
MiniMax H3の使い方:どのワークフローから始めるべきか?
MiniMax H3を最も素早く使いこなす方法は、プロンプトを書く前に生成モードを選ぶことです。H3はテキスト、最初/最後のフレームの入力、マルチモーダル参照をサポートしていますが、それぞれの入力が果たす役割は異なります。MiniMaxの公式モデルカードでは、オープンウェイトのチェックポイントが、テキストおよびフレームベース生成用の「FL2VA」と、画像・動画・音声を用いた参照駆動型の生成用の「Ref2VA」に分類されています。
| モード | 最適用途 | 動画を制御するもの |
| T2VA | ゼロからのシーン作成 | テキストプロンプト |
| I2VA | 正確な画像からの開始 | 最初のフレーム + プロンプト |
| L2VA | 特定のエンディングへの到達 | 最後のフレーム + プロンプト |
| FL2VA | 開始と終了の両方の制御 | 最初と最後のフレーム |
| Ref2VA | 人物の一貫性、動き、カメラ、スタイル、音声の保持 | マルチモーダル参照 + プロンプト |
画像は「フレーム」ですか、それとも「参照」ですか?
この違いを理解することで、多くのコントロール上の課題が解決します。
フレームは時間軸上のアンカーです。アップロードした商品画像を、視聴者が最初に目にする映像としてそのまま使用したい場合は、「最初のフレーム」として設定します。
参照は再利用可能な情報です。新しい構図を作成する際に、商品のデザイン、キャラクターの顔、衣装、あるいはビジュアルスタイルの一貫性を保ちたいだけの場合は、「参照」として扱います。
MiniMaxの公式プロンプトガイドでもこの区別が明確に示されています。I2VAは提供された画像の0.00秒目から開始するのに対し、フルリファレンスモードでは、各アセットが果たす役割に応じて、被写体、画像、動画、音声を個別に追跡します。
H3コントロールスタック
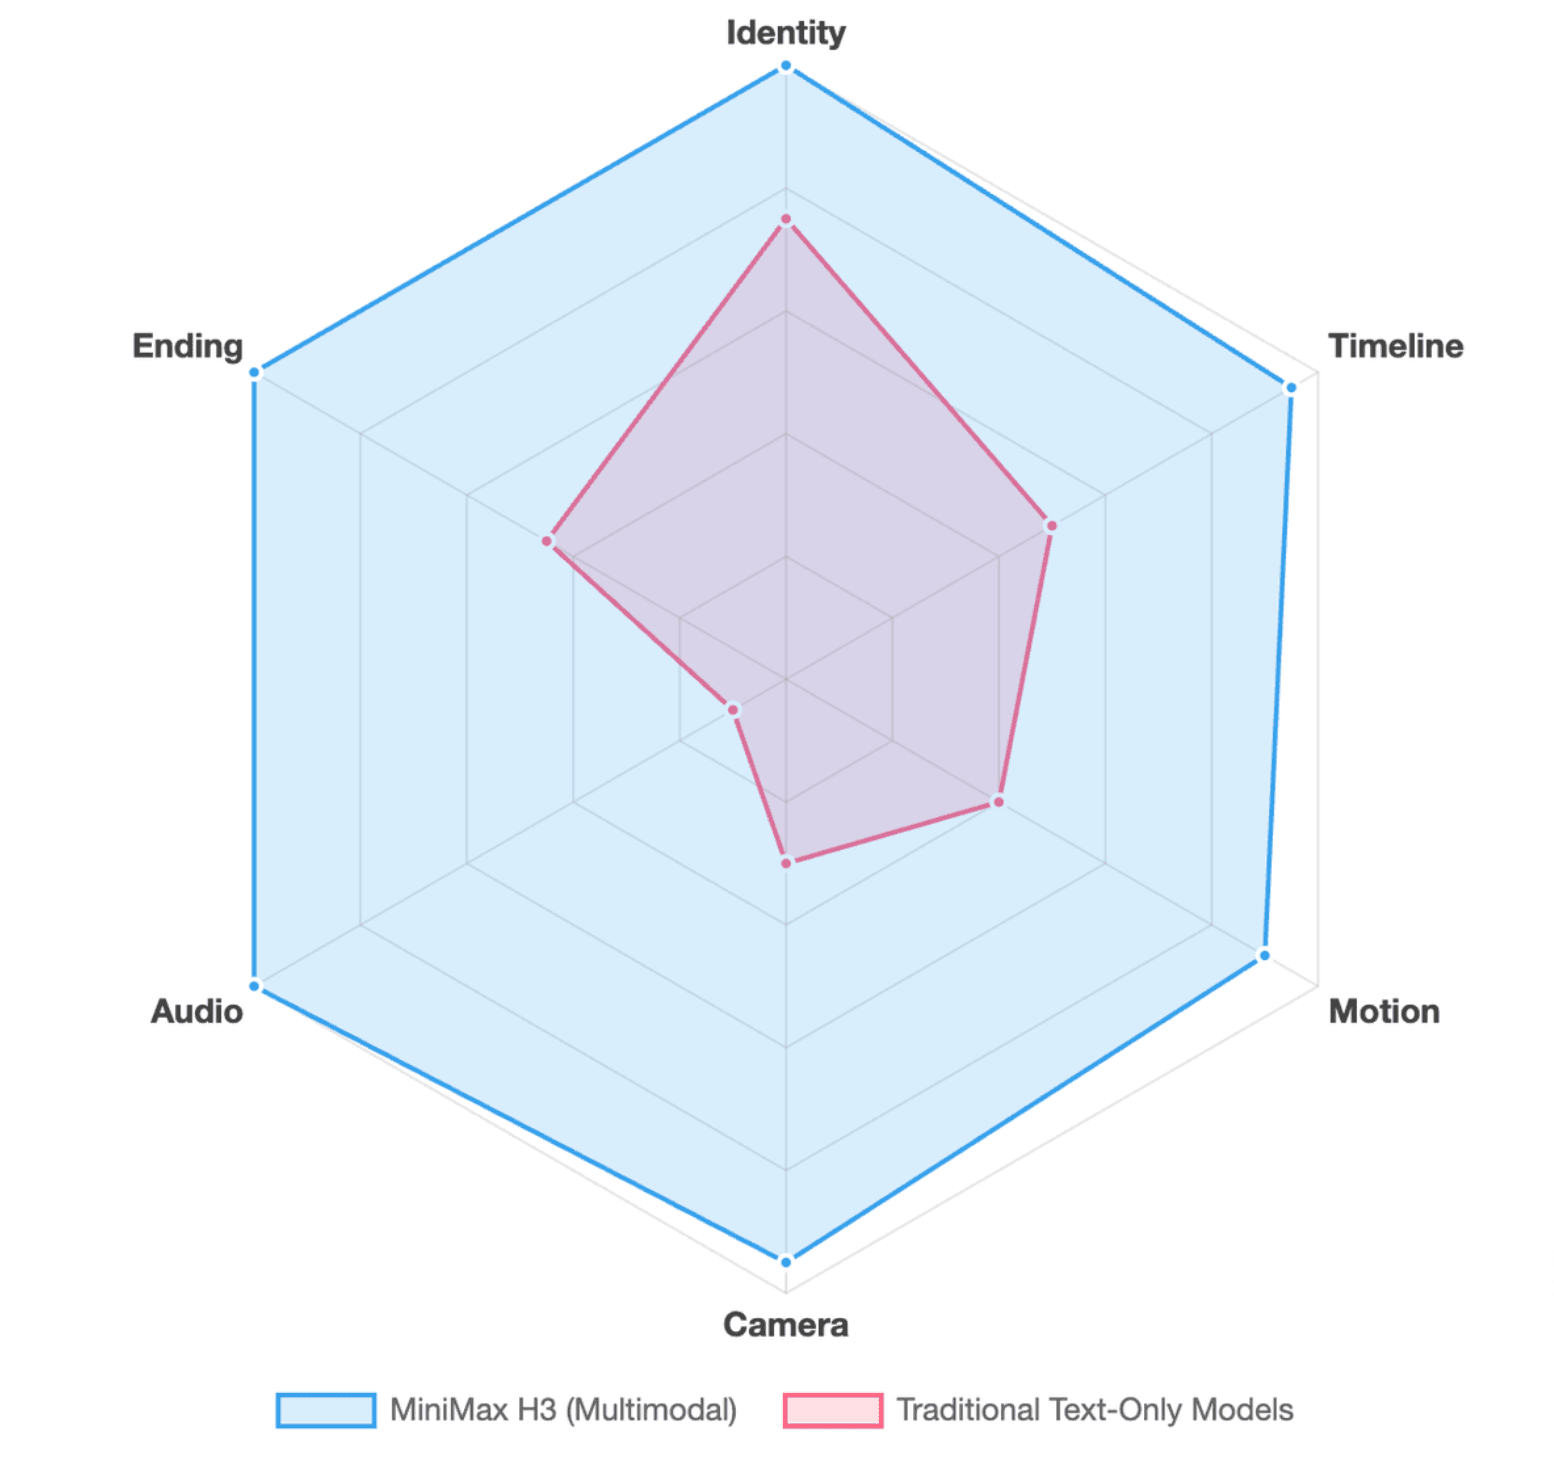
プロンプトを書く前に、動画の6つの要素(アイデンティティ、タイムライン、モーション、カメラ、オーディオ、エンディング)を何で制御するかを決定します。
例えば、商用動画を作成する場合、商品のアイデンティティには参照画像、商品の動きにはテキスト、カメラワークには参照動画、サウンドデザインにはネイティブ音声の指示、そして最後の決めカットには最後のフレームを使用することができます。
これにより、「1つの長いテキストプロンプトですべてを制御しようとする」というよくある失敗を防ぐことができます。
MiniMax H3でより高いコントロール性を得るプロンプトの書き方
実用的なH3プロンプトは、再生順に動画を描写します。効果的な動画スクリプトの書き方で使われているベストプラクティスと同様に、形容詞を並べるコピーライターではなく、実際に目に見え、耳に聞こえるものを描写するディレクターの視点で考えましょう。
実用的な構成は以下の通りです:
シーン → 被写体 → アクション → カメラ → セリフ/サウンド → エンディング
MiniMaxの公式ベースプロンプト形式も、これと同じ基本ロジックに従っています。その integrated_multimodal_description ではショットを順番に描写し、overall_soundscape と non_diegetic_music によって物理的なサウンドとBGMを個別に制御します。
再生順にシーンを構築する
以下の悪い例のようにするのではなく:
ドラマチックな動きのある、プレミアムでシネマティックなスキンケアのコマーシャル。
目に見える一連の流れを記述します:
黒い石の台座の上に、ガラス製の美容液ボトルが置かれている。細い光がラベルを横切って差し込む。カメラが近づきながら、ボトルが時計回りにゆっくりと回転する。結露した水滴が光を反射する。ロゴをカメラに向けた状態でボトルが静止する。
2つ目のバージョンでは、H3が実行すべき目に見える状態の変化が明確に提供されます。
また、複雑さの予算についても考慮しましょう。3人のキャラクター、4つのカット、変身シーン、2つのセリフ、動くカメラ、そして複数の参照データを含む10秒間のクリップは、技術的には描写可能かもしれませんが、それらのすべての要素が10秒という時間内に自然に収まるとは限りません。
カメラワークとカットを意図的にディレクションする
プッシュイン、プルバック、パン、トラック、ティルト、アーク、または静止など、ショットに貢献する場合にのみカメラの動きを指定します。
すべてのフレーミングの調整をカットの切り替えにしてしまわないようにしましょう。ミドルショットからクローズアップへの緩やかな変化は、新しいシーンではなくカメラの動きとして描写できることがよくあります。
アクションだけでなくエンディングも定義する
アクションがどこで終了するのかを明記することで、プロンプトのコントロール性が高まります。
「キャラクターが窓に向かって歩く」で終わらせるのではなく、最終的な状態を定義します:キャラクターが窓の横で立ち止まり、カメラの方を振り向き、スカイラインを背景にした構図で静止する。
これは、プロダクトデモ動画、ロゴのショット、トランジション、最初/最後のフレームを使用するワークフローにおいて特に重要です。
MiniMax H3で画像、動画、ストーリーボード、ボイスリファレンスを活用する方法
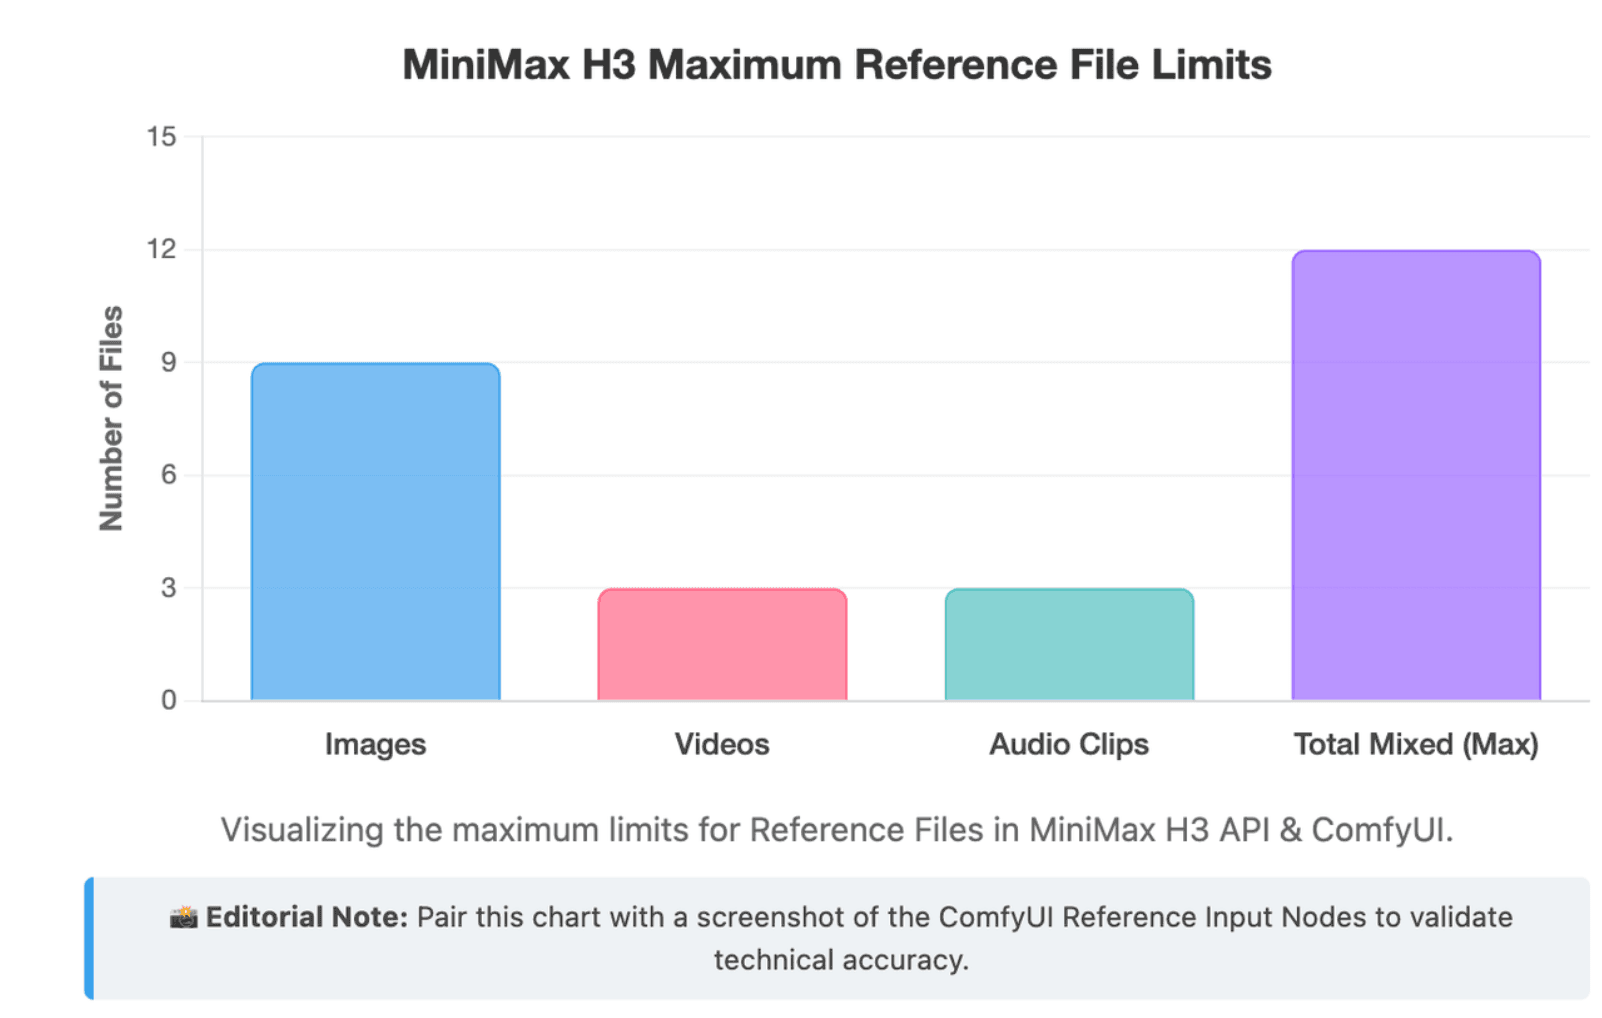
リファレンス・トゥ・ビデオ機能こそが、H3を単なる従来の画像生成ツール以上のものにしている所以です。公式のRef2VAモデルはマルチモーダルな参照データを受け入れ、人物の一貫性、動き、カメラワーク、スタイル、音声を制御するためにそれらを利用できます。MiniMaxの現在のドキュメントでは、合計で最大9枚の画像、3本の参照動画、3つの音声クリップ、12個の混合ファイルをサポートしていることが記載されています。
すべての参照データに1つの明確な役割を与える
強力な参照設定の例:
画像1 → キャラクターのアイデンティティ;画像2 → 衣装;動画1 → 身体の動き;動画2 → カメラワーク;音声1 → 声。
ComfyUIの公式H3ドキュメントでも同じ原則が推奨されています。各入力を接続順に参照し、どの素材がアイデンティティ、スタイル、モーション、カメラ、または音声を制御するのかを明示します。
参照データの数を増やせば自動的にコントロール性が上がるわけではありません。むしろH3が解決すべき関係性が複雑になります。2枚の画像がそれぞれ異なる衣装を示唆し、一方で参照動画には別のキャラクターの外見が含まれている場合、プロンプトでそれぞれの役割を明確にしない限り、モデルはどのシグナルを優先すべきか判断に迷うことになります。
<Subject> と <Picture>
MiniMaxのフルリファレンス形式において、<Subject N> は、参照アセットから抽出された人物、オブジェクト、環境、その他の要素など、再利用可能な視覚的コンテンツを表します。一方、<Picture N> は、フレームや構図のアンカーとして使用される具体的な画像を表します。そして <Video N> と <Audio N> は、時間軸または音声の参照データを追跡します。
つまり、1つの被写体が必ずしも1つのファイルである必要はないということです。例えば、1つの画像の顔のアイデンティティと、別のソースからの衣装や動きの情報を組み合わせたキャラクターを作成することができます。
ストーリーボードはいつ使うべきか?
言葉で説明するよりも目で見た方が空間的な関係性を伝えやすい場合は、ストーリーボードを視覚的なプランニング層として機能させることができます。これは、複数のショットで構成されるシーケンス、商品の発表シーン、キャラクターの立ち位置、あるいは反復する構図において特に有効です。
AI動画ワークフローの観点から言えば、その利点はストーリーボードがすべてのフレームを保証してくれることではありません。空間やショットのプランニングに関する情報を、テキストの文章のみで伝えなければならない負担を軽減できる点にあります。
MiniMax H3でセリフ、効果音、音楽を制御する方法
H3は、音声を別のポストプロダクション層として扱うのではなく、動画と同時にネイティブなステレオ音声を生成します。MiniMaxは32 kHzのステレオ出力を指定しており、そのプロンプトシステムはセリフ、物理的なサウンド、非劇伴音楽をそれぞれ異なる概念としてサポートしています。
ショットの一部としてセリフを書く
セリフを書く際は、誰が話すのか、何を話すのか、いつ話すのか、どれくらいの画面時間を使うのかの4つの疑問に答える必要があります。
MiniMaxの構造化されたフォーマットでは、(S1) などの永続的なスピーカーIDや、<d>[English]...</d> などのセリフタグを使用できます。しかし、初心者が最初からこの構文を覚える必要はありません。それよりも重要な原則は「タイミング」です。
セリフの予算管理を行う
セリフには実際の秒数が消費されます。
スピーカーが4秒間しか登場しない場合、現実的に発話に8秒かかるような長文を書かないようにしましょう。そうしなければ、モデルは音声を圧縮、早口にする、途中で切る、あるいは歪ませるなどの処理を余儀なくされます。
実際の現場では、ローカル環境でH3を使用するユーザーは、音声を独立したレイヤーとして扱うのではなく、視覚的なプロンプト作成と並行してショットのタイミングやセリフの調整を行っています。あるRTX 5080でのテストレポートでは、構造化されたマルチショットプロンプトを使用し、生成自体の計算コストが高い状態を維持したまま、プロンプトの繰り返し調整が必要になったことが報告されています。
サウンドスケープと背景音楽を分ける
シーン内に物理的に存在する音(足音、エンジン、風、ドア、群衆、服擦れの音、機械音など)にはサウンドスケープを使用します。
キャラクターには聞こえていないが観客には聞こえる音楽には、非劇伴音楽を使用します。
これら2つを分離することで、「シネマティックな音を追加する」といった曖昧な指示よりも、H3に対してはるかに有用なディレクションを提供できます。MiniMaxの公式プロンプト形式でも、これら2つの音声レイヤーは意図的に分けて管理されています。
より良いMiniMax H3の結果を生み出す設定とテストワークフロー
MiniMaxのドキュメントでは、H3の出力仕様として4〜15秒、24 FPS、複数のアスペクト比、そしてオープンなH3-Baseワークフローにおけるデフォルトとして768ピクセルの短辺解像度が定義されています。その完全なシステムは、H3-Regenerate-2Kを通じて2K出力まで生成可能です。
ショットに応じて長さ、アスペクト比、解像度を選ぶ
自動的に最も長い再生時間を選ぶのは避けましょう。意味のあるイベントの数に合わせて長さを調整します。
ほとんどの横長コンテンツには16:9、縦長のSNS動画には9:16、正方形の構図が配信チャネルに適している場合は1:1を使用します。ComfyUIでは、公式のH3ワークフローにおいて、解像度セレクターを通じてアスペクト比やメガピクセルのコントロールが可能ですが、ピクセル数が高くなるほど生成コストが増加します。
プレビューの忠実度ラダーを活用する
低コストのプレビューは有用ですが、それは適切な疑問を確認するために限られます。
初期のテストは、構図、主要な動き、カメラの方向、カット割り、大まかなタイミングを確認するのに適しています。一方で、小さなテキスト、遠くの顔、ロゴ、細かい製品の詳細を評価するにはあまり信頼性が高くありません。
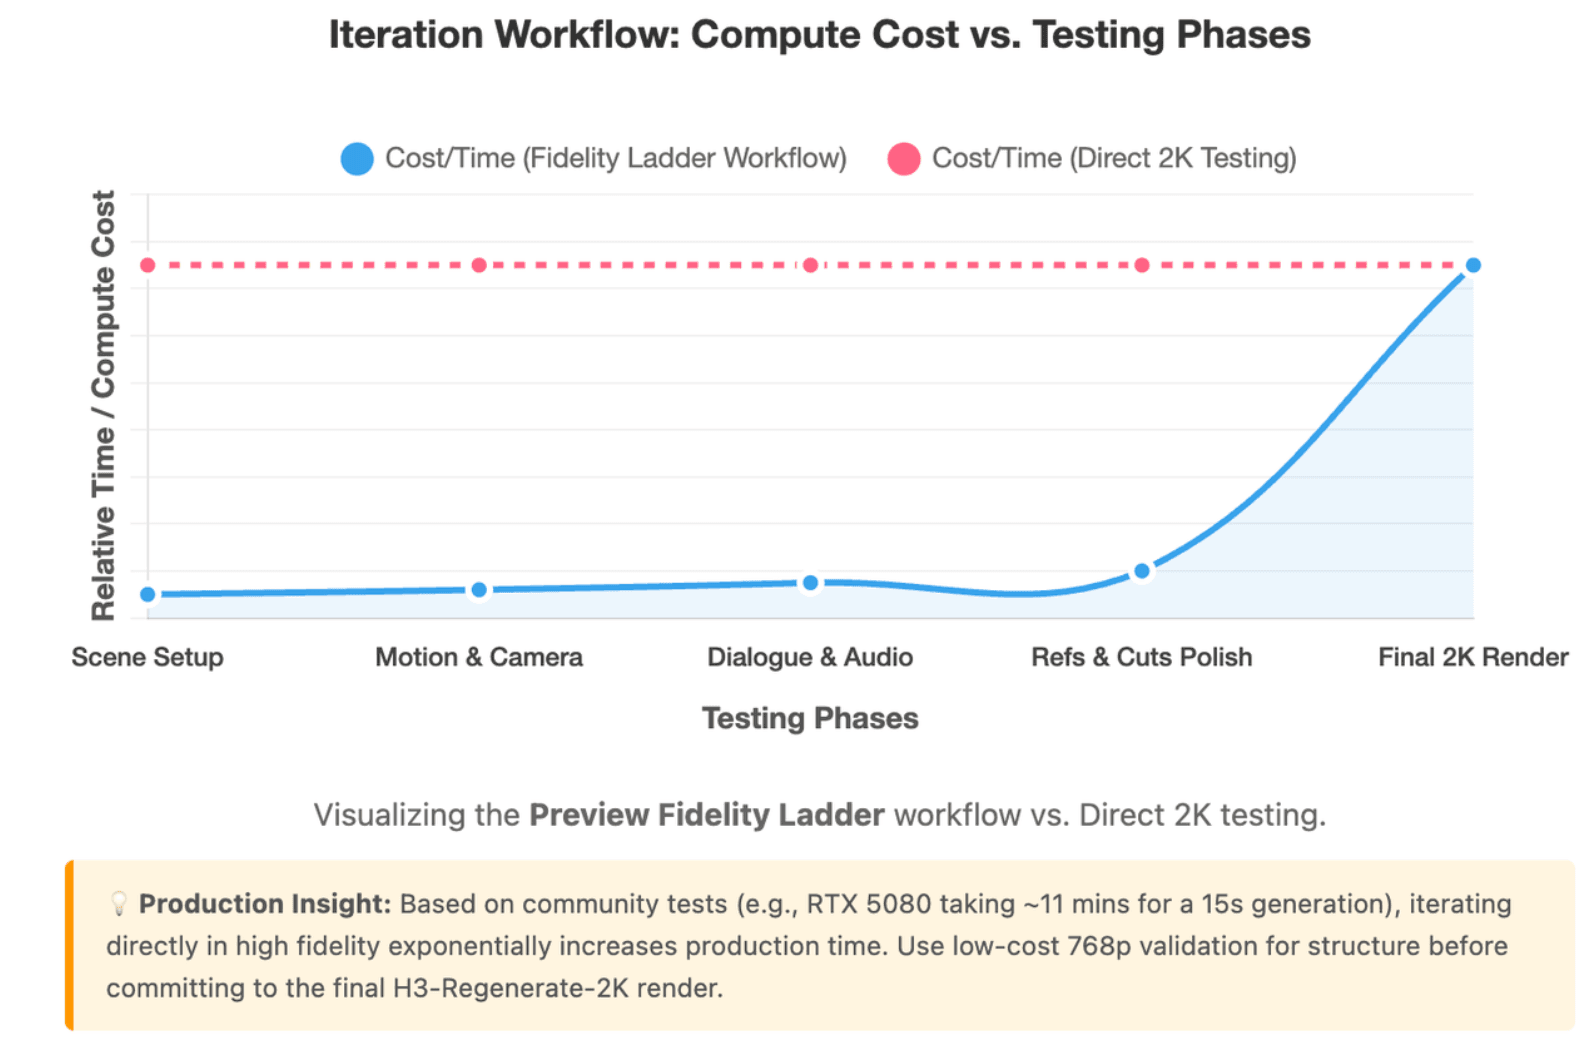
したがって、目標は単に「常にまず低解像度で生成すること」ではありません。構造的な決定にはコストの低い生成を使用し、高忠実度で初めて視覚的に判別できるようになるディテールに対して計算リソースを費やす、というアプローチをとることです。
1度に1つの変数だけをテストする
実用的な制作の順序としては、まずシーンを検証し、次に動きとカメラ、その次にセリフ/音声、さらに追加の参照データやカット割り、そして最後に高品質な生成を行うという流れになります。
これが重要な理由は、AI動画の実質的なコストがしばしば**生成コスト × 繰り返し回数**になるためです。あるコミュニティのテストでは、RTX 5080システムで15秒、0.4MP、10ステップのH3生成に約11分かかり、動画の長さに伴ってステップあたりの時間が大幅に増加したことが報告されています。また、ユーザーはメモリ不足エラーを回避するための回避策が必要であったことも報告しています。これはあくまで1つの現実的な事例であり、普遍的なベンチマークとしてではなく参考として捉えてください。
ComfyUIやAPIワークフローでのMiniMax H3の活用とトラブルシューティング
ComfyUIでは現在、テキスト・トゥ・ビデオ、イメージ・トゥ・ビデオ、リファレンス・トゥ・ビデオ向けの公式H3テンプレートを提供しています。そのネイティブノードは、テキスト/フレームワークフローにはFL2VAファミリを使用し、マルチモーダル参照にはRef2VAを使用します。
MiniMax APIは異なるアプローチをとっています:H3のタスクは非同期処理です。生成、Context-IR、または再生成タスクを送信すると task_id が返されるため、そのタスクをクエリして結果を取得します。生成に成功したタスクは content.url を通じて動画を返し、Context-IRは content.prompt を通じて強化されたプロンプトを返します。
また、完全なH3システムを、オープンなH3-Baseウェイトと混同しないように注意する必要があります。MiniMaxは、H3-Context-IR → H3-Base → H3-Regenerate-2K という3つのモジュールについて説明しています。ローカルのH3-Baseは768pの生成を検証し、完全な2Kワークフローでは、元のコンテキストと768pの結果を組み合わせて再生成を行います。
3つのレベルで不具合を診断する
プロンプトを書き直す前に、どのレイヤーで不具合が発生しているのかを特定します。
| レイヤー | 典型的な問題 | 変更すべき点 |
| プロンプト | アクション、タイミング、カメラ、エンディングの誤り | タイムラインの書き直し |
| 参照データ | アイデンティティ、衣装、動き、音声のズレ | 参照役割の明確化または削減 |
| レンダリング | 小さなテキスト、遠くの顔、細かいディテール | 高忠実度な出力/設定のテスト |
すべての視覚的な欠陥がプロンプトの記述ミスに起因するわけではないため、この区別を行うことが重要です。
よくあるMiniMax H3の問題と実用的な解決策
アイデンティティが崩れる場合は、競合する参照データを簡素化し、どのソースがアイデンティティを制御しているのかを明確に定義します。商品やロゴが変わってしまう場合は、モデルが再設計してもよい要素と、絶対に維持しなければならない属性を明示的に切り分けます。
動画が急ぎ足に感じられる場合は、プロンプトの細部を増やすのではなく、アクション、カット、またはセリフを減らします。音声が圧縮されているように聞こえる場合は、セリフを短くするか、スピーカーにより多くの時間を割り当てます。
最初/最後のフレームの間でワープが発生する場合は、単に2つの端点を指定するだけでなく、その間の物理的な移行過程を描写します。R2Vの参照データがほとんど影響を与えていない場合は、単に添付するだけでなく、その正確な役割を記述します。
ローカル環境のユーザーは、パフォーマンスのチューニングについても慎重に行う必要があります。ComfyUIはオプションのSage Attentionについて公式にドキュメント化しており、サンプルワークフローでは品質の低下を最小限に抑えながら生成速度がおおむね2倍になるとしていますが、その他のキャッシング、量子化、および実験的な最適化手法にはそれぞれ異なるトレードオフが存在する場合があります。
結論
MiniMax H3は、動画 generationをプロンプトの長さのコンテストではなく制作ワークフローとして扱うことで、より簡単にコントロールできるようになります。適切なモードを選択し、それぞれの参照データに明確な役割を与え、利用可能な時間内でアクションとセリフの時間配分を行い、最終品質のレンダリングを行う前に構造的な決定をテストし、不具合をプロンプト、参照データ、レンダリングのいずれの問題として診断する。このアプローチにより、単純なテキスト・トゥ・ビデオのクリップから複雑なマルチモーダル設定に至るまでスケーラブルに対応できるようになり、現代におけるAI動画の急速な制作手法を体現するものとなります。