MiniMax H3 Promptguide: Så skriver du bättre prompter för video, Ref2VA, kamera, ljud och referenser
En stark MiniMax H3-prompt bör definiera mer än bara en visuell stil. Den bör förklara vad som händer över tid, hur kameran rör sig, vilka detaljer som måste förbli konsekventa, vad varje referens bidrar med och hur dialog, ljud och musik samspelar i sekvensen. För bättre kontroll är nyckeln att välja rätt H3-läge, beskriva observerbara förändringar och ge varje referens en tydlig roll.
Denna guide täcker T2VA, I2VA, FL2VA, L2VA, Ref2VA, kamerakontroll, ljud, karaktärskonsekvens och praktisk felsökning. Dessa principer gäller även för strukturerade AI-videoflöden som Leadde, där dokument, utbildningsmaterial och produktinformation förvandlas till skalbara videor komplett med berättarröst, avatarer och flerspråkig output.
MiniMax H3-promptguide: Vad är den bästa promptstrukturen?
Det mest användbara sättet att se på en MiniMax H3-prompt är som ett audiovisuellt produktionsmanus. Istället för att stapla ord som ”cinematisk”, ”realistisk” och ”dramatisk” bör du beskriva vad tittaren faktiskt ser och hör när klippet utvecklas för att förstå hur man skapar realistiska AI-videor.
Den enkla H3-promptformeln
För vardagliga prompter börjar du med:
Subjekt + Handling + Miljö + Kamera + Tidsschema + Ljud
Exempelvis etablerar ”en kvinna på en regnig tågstation” en scen, men den skapar inte mycket information om händelseförloppet. En starkare prompt förklarar att hon går mot plattformen, stannar när hon hör ett tåg närma sig, vänder sig mot ljudet och följs av en långsamt panorerande kamera.
MiniMax officiella Base Prompt Guide formaliserar detta med tre fält: integrated_multimodal_description, overall_soundscape och non_diegetic_music. Det första hanterar den visuella tidslinjen, handlingar, tagningar, talare, dialog och synkroniserat scenljud; de andra två separerar miljö- och originalljud från publikanpassad bakgrundsmusik.
Skriv observerbara resultat, inte bara adjektiv
En bra regel är att omvandla abstrakta avsikter till synligt beteende.
Istället för ”hon ser självsäker ut”, kan du beskriva att hon går stadigt, håller ögonkontakt, rättar till jackan och stannar utan tvekan.
Samma tillvägagångssätt fungerar för begränsningar. Istället för att upprepa ”zooma inte in”, kan du beskriva det önskade resultatet: ”subjektet behåller ungefär samma storlek i bildrutan från början till slut.” Ett H3-konsistenstest från communityn visade att mätbara inramningsbegränsningar fungerade bättre i just det arbetsflödet än att upprepade gånger uppge ett negativt kamerakommando. Detta är en anekdotisk observation från arbetsflödet, ingen officiell garanti från MiniMax.
Vilket MiniMax H3-läge bör du använda?
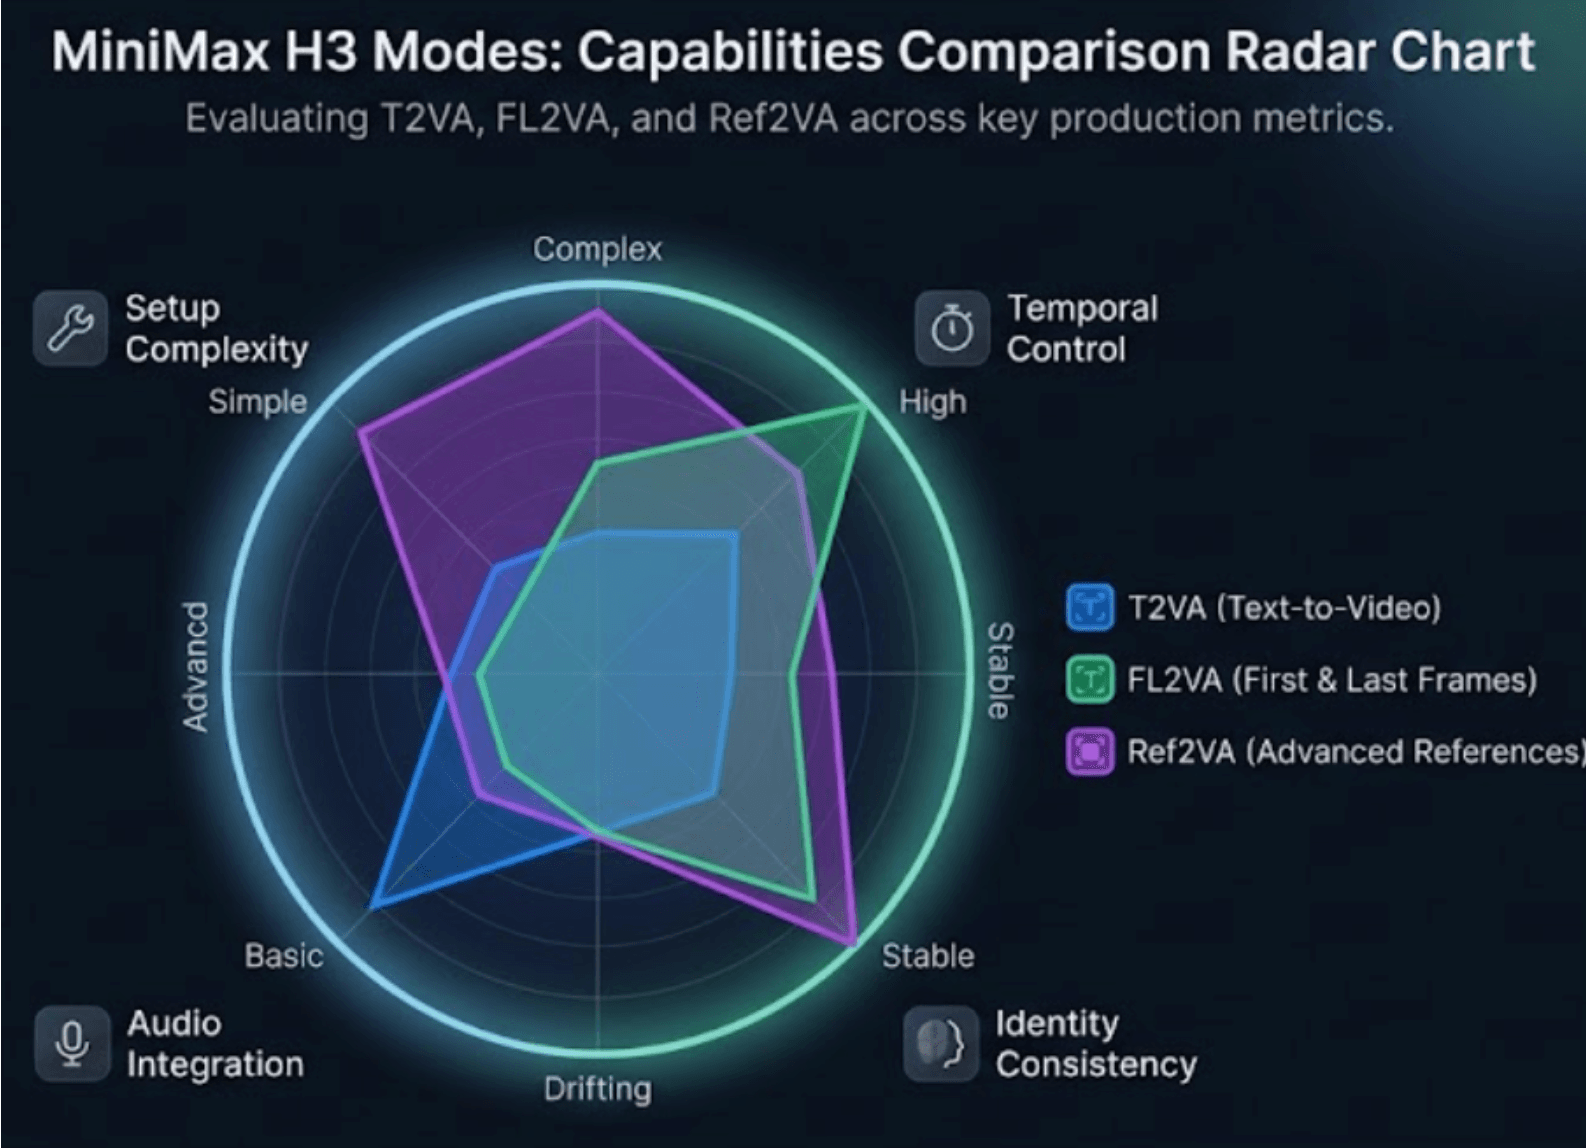
Att välja rätt läge kan vara lika viktigt som att skriva om prompten. MiniMax basarbetsflöde stöder textbaserad generering samt uppgifter för första bildrutan, sista bildrutan och både första och sista bildrutan, medan dess separata Ref2VA-kontrollpunkt hanterar multimodal referensgenerering.
| Läge | Indata | Bästa mål för prompten |
| T2VA | Text | Bygg upp hela den audiovisuella scenen |
| I2VA | Första bildrutan | Bevara startpunkten och utveckla framåt |
| FL2VA | Första + sista bildrutan | Beskriv övergången mellan slutpunkterna |
| L2VA | Sista bildrutan | Bygg upp mot det tillhandahållna avslutet |
| Ref2VA | Bilder/video/ljud | Kombinera olika referensroller |
T2VA, I2VA, FL2VA och L2VA
T2VA måste bygga upp scenen från grunden. I2VA behandlar den medföljande bilden som den faktiska första bildrutan, så prompten bör bevara identitet, kläder, objekt, färger och komposition innan rörelse introduceras.
Med FL2VA ska prompten inte bara beskriva Bild 1 och Bild 2. MiniMax rekommenderar specifikt att man beskriver den observerbara vägen mellan dem: hur subjektet rör sig, hur poser förändras, hur objekt hanteras och hur komposition eller belysning konvergerar mot den sista bildrutan. L2VA vänder på resonemanget genom att utgå från ett rimligt tidigare tillstånd och gradvis landa i den medföljande sista bildrutan.
När ska du använda Ref2VA?
Använd Ref2VA när olika tillgångar fyller olika funktioner – till exempel definierar en bild en karaktär, en annan kläderna, en video tillhandahåller gångrörelse och kamerarytm, och ljudet står för röstreferensen.
Detta förstås bäst som relationsstyrd generering. Modellen behöver inte bara veta vad varje fil innehåller, utan också hur information från respektive källa ska påverka den slutgripande videon. MiniMax fullreferensformat skiljer explicit på återanvändbara subjekt, konkreta bildankare, videobaserade tidskällor och ljudreferenser.
Använd det enklaste läget som löser tagningen
En praktisk produktionsregel är: lägg inte till referenskomplexitet om inte tagningen kräver det.
Om en övergång bara behöver en exakt början och ett exakt slut ger FL2VA uppgiften en direkt definition. Gå över till Ref2VA när du verkligen behöver relationer som identitet från Bild 1 + rörelse från Video 1 + röst från Ljud 1.
Det gör också felsökningen enklare. När färre oberoende begränsningar konkurrerar är det lättare att identifiera om problemet kommer från rörelse, identitet, inramning eller ljud.
Hur kontrollerar du tagningar, kamerarörelser, timing och övergångar?
H3-prompter blir enklare att kontrollera när tidslinjen behandlas som en redigering snarare än som ett stycke löpande text.
Klipp, tidsstämplar och tidsbudget
MiniMax officiella format använder inte tidsstämplar som [Shot 1]. Senare tagningar inleds med ökande klipptider, till exempel [Shot 2] At 00:03.500. En ny tagning bör introducera meningsfull ny information – såsom en annan vinkel, plats, tillstånd, subjekt eller tidpunkt. En mindre avstånds- eller vinkelförändring uttrycks vanligtvis bättre som en kamerarörelse snarare än ett nytt klipp.
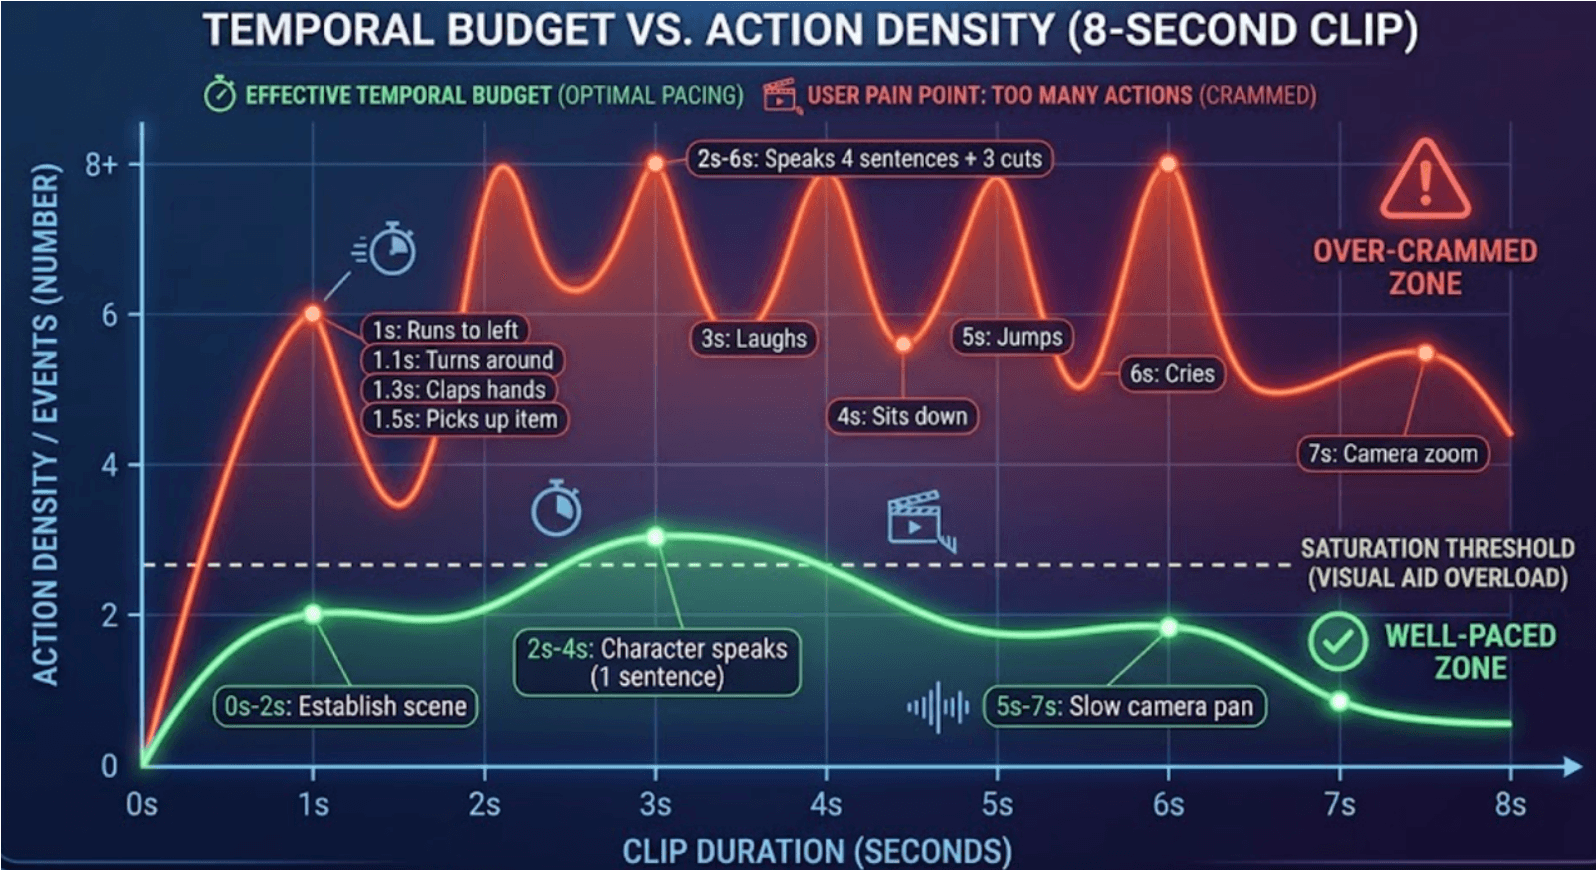
Detta skapar en praktisk tidsbudget. I ett 8 sekunder långt klipp konkurrerar tre handlingar, två kamerarörelser, en reaktion, en talad mening och två klipp om samma begränsade tidsutrymme. När en generering känns stressad fungerar det ofta bättre att ta bort händelser än att lägga till mer beskrivande språk.
Kameratermerminologi som H3 förstår
MiniMax dokumenterar kamerarörelser inklusive åkning framåt/bakåt, panorering, sidoförflyttning (truck), tilt, kranrörelse (pedestal), bågformad rörelse, följning, statiska tagningar, POV, roll och kameraskakning. Rekommenderad logik är i huvudsak:
Rörelsetyp + valfri amplitud + valfri hastighet
Så istället för ”dynamisk kinematisk kamera”, skriv något handlingsinriktat som ”kameran åker långsamt åt höger samtidigt som produkten hålls centrerad.”
Separera det som måste vara fast från det som kan ändras
Innan du genererar, skapa en enkel mental karta över fasta respektive rörliga delar.
En produktvideo kan kräva att flaskans form, texten på etiketten, korken och färgen förblir fasta medan kameraposition, reflektioner, vattenrörelser och ljussättning förändras. En karaktärssekvens kan låsa ansikte, frisyr och klädsel samtidigt som pos och uttryck tillåts utvecklas.
Detta minskar risken för motsägelsefulla instruktioner eftersom prompten inte längre ber varje visuell egenskap att förändras på en och samma gång.
Hur använder du referenser utan att förlora karaktärs- eller produktkonsistens?
De starkaste referensarbetsflödena tilldelar varje tillgång ett specifikt syfte.
Ge varje referens ett tydligt uppdrag
En praktisk mappning kan se ut så här:
Bild 1 → karaktärens identitet Bild 2 → kläder Bild 3 → produktdesign Video 1 → gångrörelse och kamerabana Ljud 1 → röstklang
MiniMax officiella Ref2VA-format stöder just den här typen av källöverskridande definition: ett subjekt kan få sitt utseende från en bild och sin rörelse från en video, medan en enda referensfil dessutom kan tillhandahålla flera återanvändbara subjekt.
Det viktiga är att undvika oavsiktlig överföring. Om Video 1 ska tillhandahålla rörelsen men inte dess skådespelare eller miljö, ange detta explicit i relationsdesignen.
Subjekt, bilder, storyboards och referensvideo
I officiell terminologi representerar <Subject N> återanvändbart synligt innehåll, medan <Picture N> används när själva bilden fungerar som en konkret bildruta, kompositionsankare eller referens för videomanus och storyboard. <Video N> representerar helvideorelationer som redigering, kontinuitet, kamerarörelser, klipp, rytm eller tidsmässig struktur. <Audio N> hanterar ljudkopiering eller egenskaper som röstklang, framförande, rytm eller musikstil.
Denna åtskillnad förhindrar ett vanligt konceptuellt misstag: en karaktärsreferens är inte automatiskt en nyckelbildruta, och en storyboard är inte automatiskt en exakt slutpunkt.
Referensekonomi och konsistens på tagningsnivå
Mer referensmaterial är inte automatiskt mer informativt. I produktionsflöden bör du trimma en referensvideo till den del som tydligt visar den rörelse, kamerabana eller röstkvalitet du behöver.
Utvärdera dessutom identiteten genom hela tagningen istället för enbart i den första bildrutan. Ett community-test visade avsevärt tidigare identitetsförskjutning i närbilder jämfört med inramningar med mindre ansikten under användarens specifika lokala inställning. De exakta tiderna bör inte generaliseras, men lärdomen för arbetsflödet är användbar: kontrollera ansiktsidentitet, kläder och smårekvisita vid flera tillfällen i varje viktig tagning.
Hur fungerar avancerad Ref2VA, dialog och ljudpromptering?
Ref2VA är där H3-promptering blir mer lik multimodal produktionsplanering än konventionell text-till-video-promptering.
Den sexdelade Ref2VA-promptstrukturen
MiniMax fullreferensguide definierar sex sektioner:
subject_definitions → summary → retention_analysis → detailed_description → overall_soundscape → non_diegetic_music.
Systemet definierar först vad referenser betyder, sammanfattar sedan uppgiften, förklarar hur varje referens bevaras eller överförs, och skriver slutligen målvideon i uppspelningsordning.
Ett användbart planeringslager innan den formella prompten skrivs är:
| Källa | Bevara | Överför | Ignorera |
| Bild 1 | Ansikte, hår | — | Bakgrund |
| Video 1 | — | Gång, kamera | Skådespelarens identitet |
| Ljud 1 | Röstklang | Framförande | Originaldialog |
Detta förvandlar en vag begäran som ”använd alla dessa referenser” till explicita relationer mellan källa och mål.
Dialog, röst, ljudeffekter och musik
Talande karaktärer använder fasta ID-nummer som (S1) och (S2), medan dialog placeras inom <d>[Language] ...</d>. MiniMax skiljer också på dialog i bild och voiceover utanför bild samt rekommenderar att man uttryckligen håller en karaktärs läppar stängda i bild när den personen enbart agerar berättare.
Miljö- och fysikaliska effekter hör hemma i ljudlandskapet, medan non_diegetic_music är reserverad för musik som hörs av publiken snarare än karaktärerna. Om du vill ha fotsteg, regn och objektljud men ingen filmmusik behåller du ljudlandskapet och sätter non_diegetic_music: N/A.
Naturlig språkprompt vs officiell strukturerad prompt
Korta instruktioner på naturligt språk kan fortfarande fungera i det hostade H3-systemet eftersom MiniMax använder H3-Context-IR, ett förbearbetningslager som tolkar relationer mellan text, bilder, video och ljud innan det producerar en strukturerad representation för H3-Base. Den öppna modellkortet beskriver instruktionstolkning, korsmodal association, tidsförståelse och logiskt tänkande som en del av den processen.
Detta förklarar en till synes motsägelse: enkla prompter kan fungera bra för okomplicerade, hostade genereringar, medan strukturerade prompter blir mer värdefulla för exakta uppgifter som innefattar flera referenser, dialog, timing och repeterbar produktion.
Varför ignorerar MiniMax H3 prompter, och vilket är det bästa testarbetsflödet?
När en generering misslyckas gör en total omskrivning att det blir svårare att identifiera orsaken.
Vanliga H3-problem med prompter och lösningar
| Problem | Trolig orsak | Första sak att testa |
| Fel person pratar | Otydlig talarmappning | Lås (S1)/(S2) |
| Karaktären förändras | Motstridiga identitetssignaler | Förenkla referenser |
| Referensen ignoreras | Rollen är tvetydig | Tilldela ett jobb |
| Slumpmässiga klipp | För många tagningsinstruktioner | Använd kamerarörelse |
| Tidsstämpeln ignoreras | Använd som handlingstiming | Reservera den för klipp |
| FL2VA-hopp | Saknad övergångsbana | Beskriv mellanliggande förändringar |
| Slutet missar | Svag konvergens | Lås slutkompositionen |
| Oönskad musik | Ljudlager har blandats | Ställ in musik explicit |
| Texten ändras | Ordalydelsen bevaras ej | Citera exakt synlig text |
| Videon känns stressad | För många händelser | Minska antalet takter |
En bra princip är att köra en kontrollerad jämförelse när två lägen kan lösa samma uppgift, snarare än att anta att det mer komplexa läget alltid kommer att ge det bättre klippet.
Ett praktiskt, stegvis H3-testarbetsflöde
Börja med att definiera acceptanskriteriet för genereringen: kanske är karaktärens identitet det viktigaste, eller så är produktetiketten, slutövergången, dialogägarskapet eller kamerarörelsen icke-förhandlingsbar.
Testa därefter i lager: etablera karaktär och scen först; lägg till rörelse och kamera härnäst; addera röst och ljud först när det visuella beteendet är stabilt; introducera extra klipp, storyboards eller ytterligare karaktärer först efter att den enklare versionen fungerar. Högupplöst regenerering bör komma efter att det semantiska resultatet är korrekt, eftersom högre upplösning inte kan lösa motsägelsefulla referensrelationer.
Detta etappvisa tillvägagångssätt är särskilt användbart i skalbara videorörledningar. För arbetsflöden som förvandlar repeterbar kunskap eller affärsinnehåll till video, inklusive dokument-till-video-verktyg för utbildning som Leadde, blir det enklare att isolera revideringar när man separerar innehållsstruktur, visuellt beteende, AI-berättarröst och slutgripande rendering, istället för att behöva bygga om hela produktionen varje gång.
Spara lyckade tagningar istället för att generera om allt
För längre projekt bör du behandla varje lyckat klipp som en validerad produktionstillgång. Om Tagning 1 och 2 fungerar men Tagning 3 misslyckas, regenerera den misslyckade delen istället för att kasta bort allt som gjorts tidigare i kedjan.
H3-arbetsflöden i communityn använder redan kontrollpunkter för tagningar av den här anledningen: när en framgångsrik del har sparats kan efterföljande experiment köras om utan att man upprepade gånger behöver betala den beräkningsmässiga och kreativa kostnaden för att återskapa tidigare material.
Detta leder till en bredare produktionsprincip:
Generera → validera → spara → fortsätt.
När det gäller AI-video blir prompt-engineering med tiden arbetsflödes-engineering.
Sammanfattning
MiniMax H3-promptering fungerar bäst när uppgiften är tydligt strukturerad snarare än bara beskriven med fler ord. Välj det enklaste läget som passar tagningen, beskriv observerbara förändringar, separera fasta attribut från variabler, ge varje referens en specifik roll och felsök ett lager i taget. För avancerade Ref2VA-arbetsflöden kommer den verkliga fördelen av att göra relationerna mellan karaktärer, rörelse, kamera, ljud och nyckelbildrutor explicita – för att sedan förvandla framgångsrika genereringar till återanvändbara byggstenar för nästa tagning.